深く底層を見て、Jevは「パラダイムシフト」の王冠をかぶることができるのか。
 核心的な視点

 汎用的な判断には複数の能力を同時に呼び出す必要があり、最終的に確率を一つだけ出力したからといって、それが回答を生成するよりも簡単だとは考えてはいけません。
著者:博陽
編集:徐青陽
テクノロジー業界では、話題のサイクルは驚くほど似ています。
2026年9月、シリコンバレーとオープンソースコミュニティ全体が「Jev」というモデルのために熱狂しています。
それは「システム1(System One)」モデルであり、破壊的な変革をもたらすと自称しています。
過去3、4年の間に、私たちは長文の散文家のような大規模言語モデル(LLM)に慣れてしまいました。これらは「はい」か「いいえ」という単純な質問に答える前に、数百の無意味な思考トークンを生成し、その後JSON形式の結論をゆっくりと吐き出します。
しかし、Jevは異なります。直接的な判断を提供し、確率を示し、驚くほど速いのです。
開発者たちはこの「速く、正確で、厳しい」インターフェースに夢中になっています。
結局のところ、複雑なAIエージェントを構築する際に、しばしば必要なのは「この記憶は関連していますか?」「このリクエストはどのツールに渡すべきですか?」「この事故は人間による確認が必要ですか?」と尋ねることだけです。
ビジネスの中で、一般的な大規模モデルが各小さな問題に対してテキスト、説明、構造化コードを生成するために、多くのトークンと遅延を費やしてきました。実際のニーズに基づいて、Jevは非常に痛いポイントを突きました。
しかし、それは本当に十分な破壊的な力を持っているのでしょうか?
「テキスト生成」というプロセスを省略した場合、このブラックボックスに残る判断能力は、元の大規模言語モデルの恩恵からどれだけ来ているのか、TypeSafeチームが言う専門的な訓練からどれだけ来ているのか、どのように答えることができるのでしょうか?
この質問に答えるために、Jevのパッケージを一層ずつ剥がし、いくつかの切り口から詳しく説明しましょう。
01
予測判断モデルはGPTよりも早く登場した
Jevが代表するこの方向性には、非常に長い歴史があります。
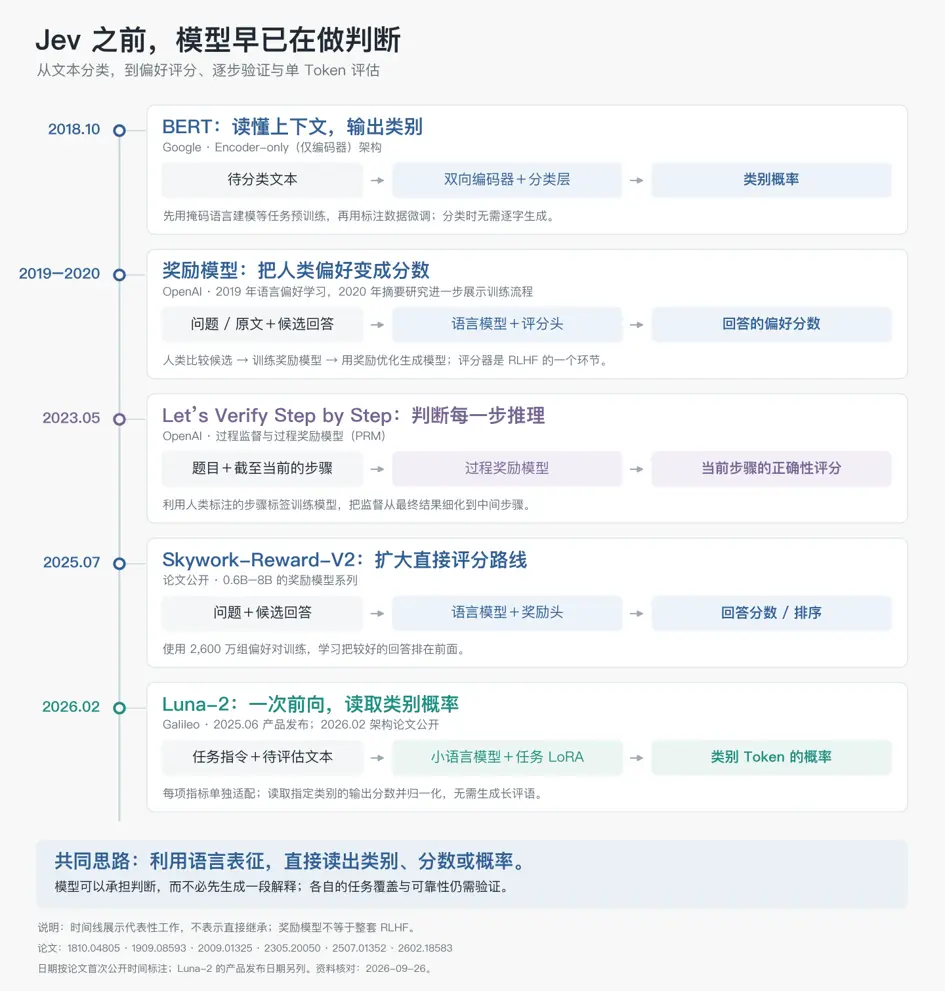
2018年、GoogleはBERTを発表しました。これは今日私たちが知っているGPT系モデルとは異なり、情報の双方向通信を許可するEncoder-only(エンコーダのみ)アーキテクチャを採用し、モデルを完型填空に訓練しました。
その後、続きの生成に使用されるDecoder-only(デコーダのみ)モデル(例えばChatGPT)が主流になりましたが、明確な分類タスクにおいてはBERTには依然としてその利点があります。
すべての情報を見ることができるEncoderを利用して、BERTはテキスト内の各位置が前後の文脈を組み合わせて完全な特徴表現を形成できるようにし、単純な分類層を接続し、ラベル付けされたメールで訓練することで迅速に判断を下すことができます。
現代のLLMも多くの場合、分類器として訓練されています。
2019年、OpenAIは「Fine-Tuning Language Models from Human Preferences」という論文で、モデルが人間のテキストに対する好みを学ぶことを試み始めました。
2020年のテキスト要約に関する研究では、この技術の流れがより明確になり、人間のアノテーターが2つの要約を比較し、その後、報酬モデルを訓練して人間がどちらの要約を好むかを予測することを学びました。
このプロセスでは、人間の判断が成功裏にスコアリング関数に変換されました。報酬モデル自体は長文の評価を記述する必要はなく、問題と回答を読み取り、神経ネットワークの出力層を通じて直接スコアを提供するだけで済みます。
これは実際には現在のモデル学習の最も基本的なパターンの一つであり、Jevが強く批判しているRLHFです。
したがって、「言語モデルの理解能力を継承し、テキストを生成しない」というのはJev独自の天才的なアイデアではありません。
2023年の著名な論文「Let's Verify Step by Step」では、この監視がモデルの各ステップにさらに細分化されて適用されました。報酬モデル、検証者、評価指標は異なるタスクから発展し、徐々にAI業界に欠かせないいくつかの判断ツールを形成しました。
2025年から2026年にかけて、関連研究はまだ進行中です。2025年にGalileoはLuna-2を発表し、その後の論文で小規模言語モデルを「単一トークン分類器」として訓練する方法を示しました。前方計算を通じて直接目標クラスの確率を読み取ることができます。そして、Skywork-Reward-V2は0.6Bから8Bの報酬モデルシリーズを発表し、LLMの直接スコアリングルートを最適化しました。
アルゴリズム実装の観点から見ると、これは本質的に難しくありません。LLMにいくつかの簡単な変更を加え、内部の隠れた表現から候補スコアを計算するようにすることは、非常に多くの方法があります。
後の再現実験では、3つ以上の方法を見ることができます。
では、Jevはこの波の中で何が異なるものをもたらしたのでしょうか?
現在のアーキテクチャの解読と公式の説明から見ると、Jevの核心的な差別化は2つの次元に現れています。
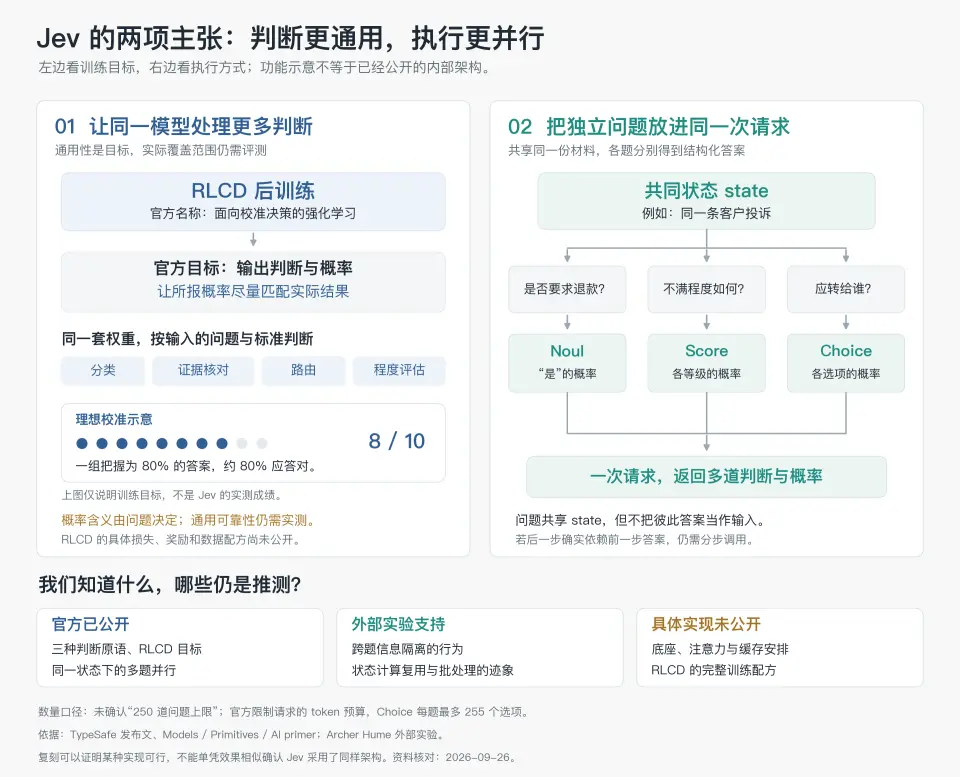
まず、より汎用的な変化があり、これは新しい後訓練方法によるものです。
過去のスコアリングモデルは基本的に単一タスクに対して訓練されていました。Jevは特定のスコアリングに制限されず、非常に汎用的な確率インターフェースを提供しようとしています。
そして、この汎用性は事実の確率に対するものであり、人間の好みに対するものではありません。
今回、TypeSafeチームは「確率キャリブレーション」を訓練目標の絶対的中心に置きました。この方法を彼らはRLCD(キャリブレーション決定に向けた強化学習)と呼んでいます。一方、従来の好み報酬モデル(RLHF)は人間の好みの確率を探しており、実世界のイベントの確率ではありません。
次に、アーキテクチャにおける並列計算の極限的な活用です。
Jevはモデル内の情報の流れを変更しました。過去のスコアリングモデルは並列回答に対する変更が少なく、主な目標は密な報酬モデルを訓練し、出てくるトークンにスコアを付けることでした。
しかし、今回はJevが同じ資料に対して最大250の質問に答えることができます。これらの質問の間に生成の依存関係がなければ、大規模にバッチ並列実行が可能です。
これらはどのように実現されているのでしょうか?
Jev自体は具体的なアーキテクチャを明らかにしていませんが、その実際のパフォーマンスやJevを再現しようとする多くの試みから、私たちはその輪郭を大まかに描くことができます。
02
テストと再現からJevの原貌を組み立てる
まず、TypeSafeが現在公開しているものを見てみましょう。
ブラックボックスの外で、TypeSafeが明確に公開しているのはまずインターフェースです。このインターフェースに対して2つのものを提供できます。
State(状態): 長文の読解の原文に相当します(例えば、長い顧客の苦情記録やシステムログなど)。
Questions(質問): この原文に対して、同時にいくつかの質問を提出できます。質問同士は互いに干渉しません。システムがこれらの独立した回答を受け取った後、コーディングを行う人(あなた)が次のビジネスロジックを決定します。
質問を標準化するために、TypeSafeは質問方法を3つの原語(Primitives)に収束させました。これには以下が含まれます:
Noul(是非題): 「はいかいいえ」を尋ね、0〜1の間の確率を直接返します(例えば:この事は緊急ですか? 0.95を返す)。
Choice(選択題): 「どれを選ぶか」を尋ね、いくつかの候補を示し、それぞれの確率分布を返します(例えば:技術部に転送 0.8、財務部に転送 0.2)。
Score(評価題): 「程度」を尋ね、各レベルの確率と最終的な加重スコアを返します(例えば:顧客の怒り指数 4.5点)。
プログラムに一般的な判断をさせることが目標であれば、これら3つの原語は非常に大きな部分の出力形式をカバーし、ほぼすべての判断をこの3つの質問に変換できます。
最後に、プログラムは数字を取得し、自分のルールに従ってアクションを取ります。
公式は、JevはStateを1回だけ読み込むと約束しています。以降、すべての質問は同じリクエスト内で、この状態に対して並列かつ独立に判断されます。
独立性は、複数の質問が互いに回答を参照できないことを意味します。もしあなたの2番目の質問が1番目の質問の結果に依存している場合、リクエストを2回に分ける必要があります。
したがって、TypeSafeは「推測的ファンアウト(Speculative fan-out)」という使い方を奨励しています。例えば、顧客の苦情を処理する場合、最終的にそれがシステムの故障でないことが判明しても、プログラムは最初に「故障かどうか」、「故障の程度」、「誰に転送すべきか」を全て尋ねることができます。システムは一度にすべての回答を並列に計算し、その後、下流のコードロジックが無駄な結果を捨てます。
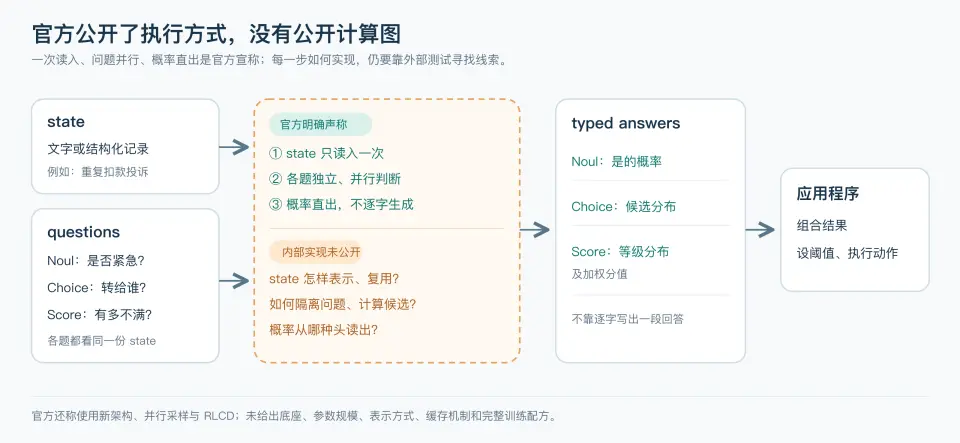
現在、これが私たちが知っているすべての公式に公開された主要な情報です。
Jevが注目を集めた後、Archer Humeは一連のブラックボックステストを実施し、Jevが状態テキストをどのように処理するかについて多くの洞察を得ることができました。同時に、Kev、NanoJev、minojevなどのオープンソース再現プロジェクトも次々と登場しています。
どの再現プロジェクトのテストフィードバックがJev本体に近いかを比較することで、私たちはそれらの内部アーキテクチャを逆に仮定することができます。
これらの再現がJevの本体を100%再現しているとは言えませんが、公式インターフェース文書の間に残された巨大なブラックホール、例えば原文がどのように状態を共有しているのか?普通の候補選択肢がどのように特徴表現を形成しているのか?それらの間でどのステップで相互に影響を与えているのか?
このレンズを通して、私たちは大まかな輪郭を垣間見ることができます。
次に、具体的なリクエストを用いて、このブラックボックス大モデルの「内部消化」プロセスを再現してみましょう。
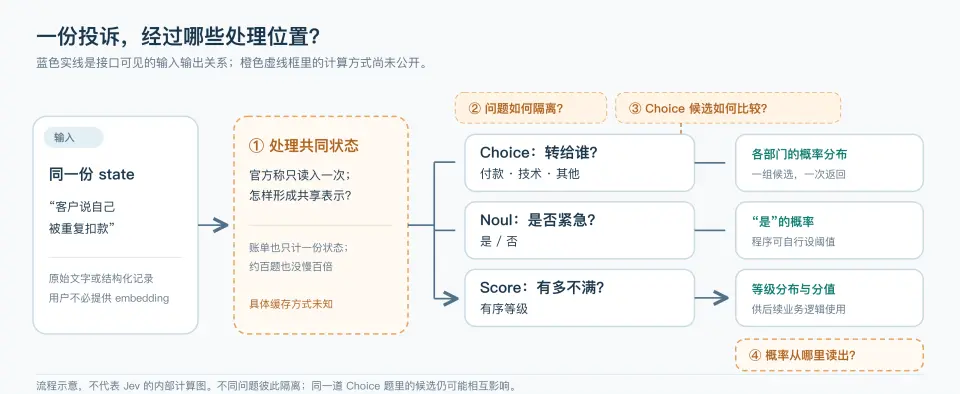
まず、Jevが実際に処理する情報構造を整理する必要があります。完全な処理は3つの部分から成ります:共有背景としてのState(例えば、その長い苦情テキスト)、いくつかの独立して提出されたQuestions(質問)、およびこれらの質問それぞれに対応するOptions(候補選択肢)。
第一ステップ:共通情報の処理
もし各質問が数万字の苦情を最初から最後まで再度読み直さなければならない場合、質問が多ければ多いほど、無駄な計算が増えます。
したがって、最良の方法は、すべての質問が一度だけ問題を読み、その後すべてに利用できるようにすることです。
Jevが本当に「一度だけ読む」ことを実現しているかどうかを検証するために、研究者のArcher HumeはAPIの請求書と遅延データを調査しました:最も簡単な是非題を提出したとき、請求は268の入力トークンとして表示されました;2つの質問に増やすと276のトークンになりました。追加されたのは新しい質問自体の文字数のコストだけで、システムは共通のState材料を繰り返し請求していませんでした。
同時に、問題の数がほぼ100に達する前に、サーバーの応答時間はほぼ水平線を描いていました。
商業的な課金ルールとバッチ処理がグラフィックカードの実際の計算記録を覆い隠しているものの、これは現象的に公式の「共通素材は一度だけ読み取り、各問題はバッチ計算される」という主張と高度に一致しています。
この情報アーキテクチャに関して、オープンソースプロジェクトのKevによる再現が最も明確です。
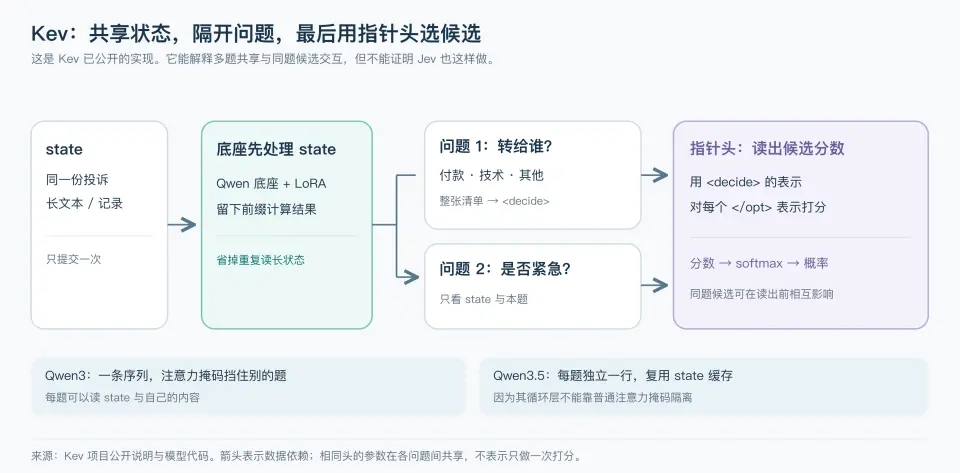
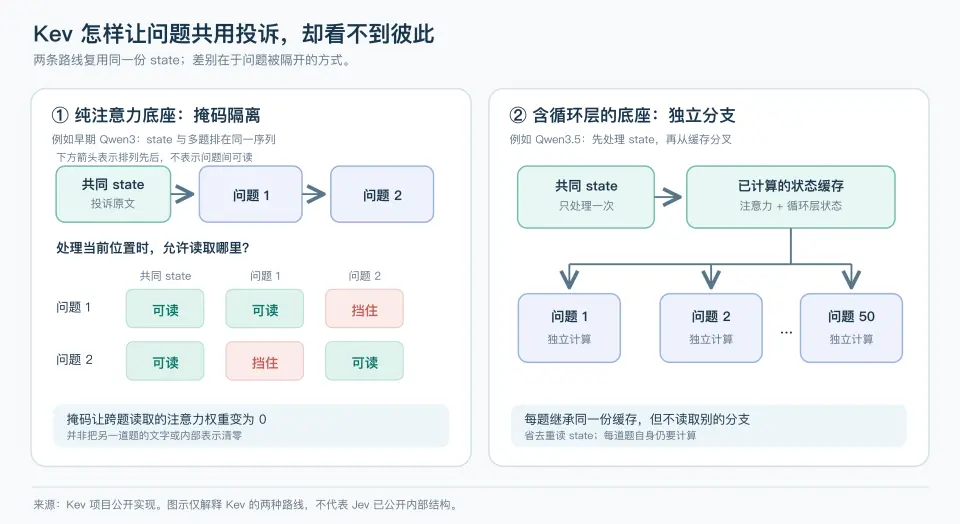
Kevはまず一度に状態を処理し、計算から得られた中間結果をKv Cacheに凍結します。次に、この50の問題はこのKv Cacheを共有して計算を進めるため、各問題を一度ずつ読み取る必要がなくなります。
第二のステーション:問題の分割
しかし、もう一つの重要な問題は、これらのバッチ計算の問題が本当に公式の言う通りに互いに干渉しないのかということです。
Archer Humeはこれを検証するために巧妙な「暗号実験」を設計しました。彼は問題Aに「暗号はZEBRA-7741」という文を挿入し、問題Bの選択肢の中でモデルに「別の問題で言及された暗号」を選ばせました。結果は、Jevが正しい暗号を出す確率は0.00でした。しかし、この暗号を問題Aから取り出して、皆が共有するStateテキストに入れると、問題Bが正しい答えを出す確率は瞬時に0.90以上に急上昇しました。
これは問題間に厳格な物理的隔離が存在する強力な証拠となります:共通素材はすべての問題に見えるが、隣接する問題は絶対に互いに「盗み見」することはできません。
問題を分けるために、Kevは二つの方法を使用しました。
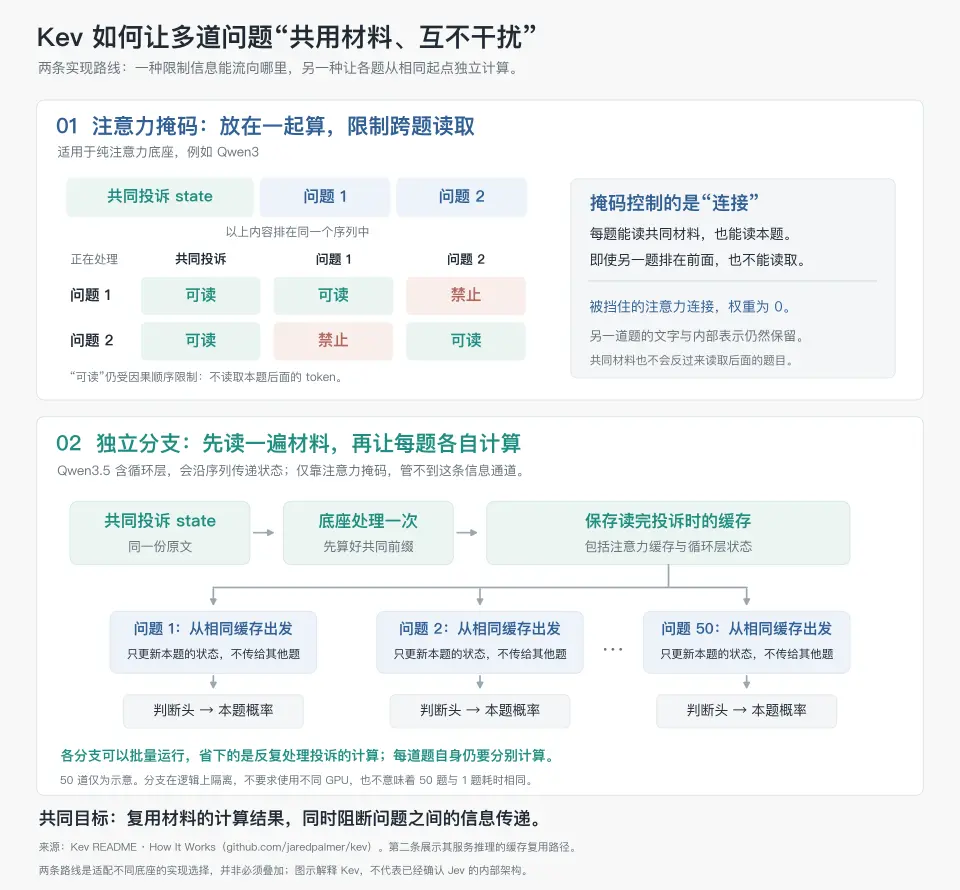
第一の方法は注意マスクです。これにより、システムが[凍結された苦情の原文] + [問題1] + [問題2]を一緒に計算する際、モデルが問題1を処理している間、マスクメカニズムは問題2の領域を数値0の状態に強制的に変え、答える際には共通の苦情の原文と自分自身にしか「注意」できなくなります。
第二の方法は独立した分岐の再利用です。循環的な特徴や特定のアーキテクチャを持つベース(文中で言及されたQwen3.5など)を使用する場合、注意マスクは分けられません。したがって、これらのモデルを使用する際、モデルが苦情の原文を読み終えると、この凍結された記憶を起点にして、50本の平行な高速道路(独立した分岐)を直接分裂させます。
各分岐路は主幹道上で既に処理された苦情の記憶を完璧に引き継いでいるため、再度原文を読み直す必要がないという恩恵を享受します。
第三のステーション:選択肢の計算
さて、共通の状態があり、問題もそれぞれ分割されたので、分割された選択肢の内部で、モデルはどのように候補を計算し処理するのでしょうか?
この時、モデルの前にはいくつかの候補が並んでいます。例えば「財務」、「技術」。最も伝統的な方法は線形ヘッド(Linear Head)とSoftmaxです。これはZefan Open-JevバージョンがJevを再現しようとした際に採用したモデルです。
これを完全に絶対的に閉じられた「黒屋盲審」と同等に考えることができます。選手「財務」が黒屋に入ってパフォーマンスを行い、あなたは一冊の堅苦しい評価ガイドライン(これが線形ヘッドの機能です)に基づいて彼に80点を与え、その後「技術」が黒屋に入って90点を与えます。この二人は全く接触せず、あなたは彼らを比較することは決してありません。最後に、Softmaxという特にパーセンテージを計算する数学的公式を使って、80と90という二つの絶対的な点数を勝率に換算します。
この仮想的なプロセスの中で、もし選択肢プールに論理的に無関係な干渉項、例えば「悪天候」を挿入した場合、それはせいぜい分母の中での弾除けとして機能し、全員が得るパーセンテージを少しだけ縮小させるだけです。しかし、あなたが財務に与えた80点と技術に与えた90点はすでにペンで紙に書かれているため、彼らの間の「相対オッズ」は絶対に干渉項の追加によって揺らぐことはありません。
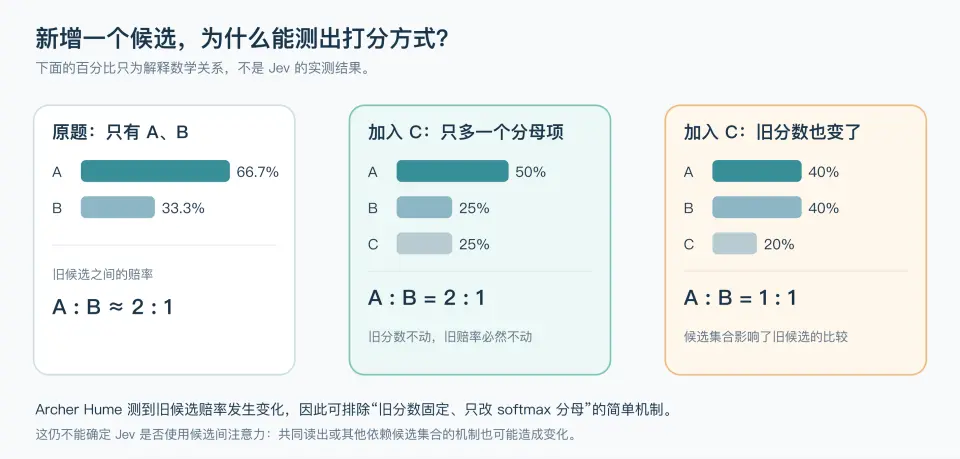
しかし、テスターのArcher Humeのテストは、新たに追加された選択肢が確かにモデルのスコア差に影響を与えることを証明しました。彼は一組の通常の選択肢に「悪天候」という干渉項を無理やり追加し、10組のランダムな配置のテストで、確かに財務と技術の相対オッズが変わったことを発見しました。これにより「黒屋盲審」モデルに死刑が宣告されました。
盲審ではないので、選手たちは審査員が最終的なスコアを出す前に必ず「互いに見える」ことがあり、化学反応を生じたことを示しています。オープンソース界はこの化学反応を実現するための二つの設計図を提供しました。
第一の方法は、Kevプロジェクトが設計した「ポインターヘッド(Pointer Head)」モデルです。これを「同場群面」と考えることができます。モデルは選手を黒屋に閉じ込めるのではなく、「財務、技術、悪天候」を一列に並べて、審査員が一度に全てを見ることができるようにします。
審査員が最後に立っている選手を見ると、彼の頭の中にはこの面接に関する「全体的な文脈」が形成されています。そして、審査員は最後の位置に立ち、手指のように前の選手たちを一人ずつ指し、現在の全体的な印象に基づいてスコアを付けます。この動作を指示ヘッドと呼びます。審査員が全員を見終えた後に戻って指摘する際、心の状態と参照系はすでに変わっているため、財務と技術に付けるスコアも自然に変動します。
第二の方法は「審査員会内部の議論」で、NanoJevなどのプロジェクトが設計した「候補間注意モジュール(Inter-candidate Attention Module)」モデルです。今回は、モデルは純粋な盲審でも純粋な群面でもありません。まず「財務」と「技術」にそれぞれパフォーマンスを行わせ、そのパフォーマンスを高次元の数値評価に凝縮します。この用語は特徴ベクトル**と呼ばれます。
この時、二つの評価カードはまだ隔離されています。しかし、その後、別の小さなモデルがこの二つの評価カードと、後から追加された「悪天候」の評価カードを一緒に「注意モジュール」という会議室に投げ込みます。
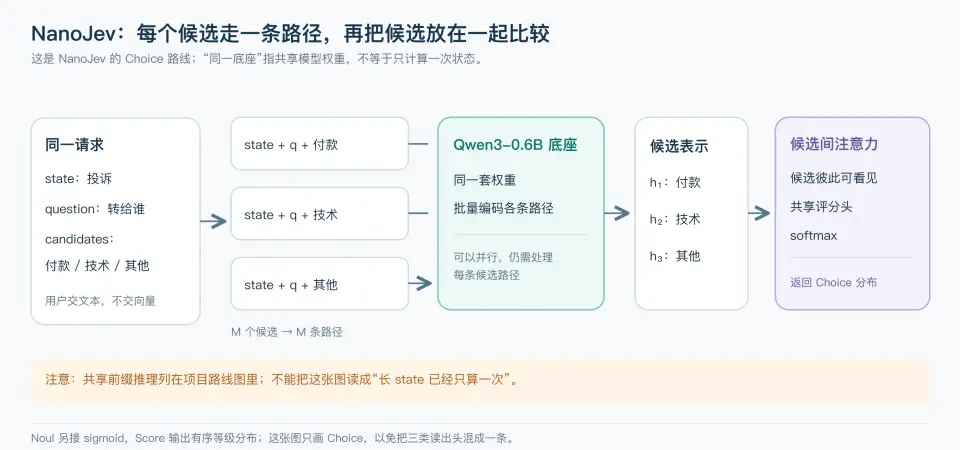
この会議室では、選手を代表するこれらの数値(特徴ベクトル)が互いに比較され、評価されます。本来、財務と技術は難解に比例していたのに、突然「悪天候」のカードが議論に参加することで、全体の審査員会の議論の焦点と比較の重みが瞬時に乱れ再構成されます。
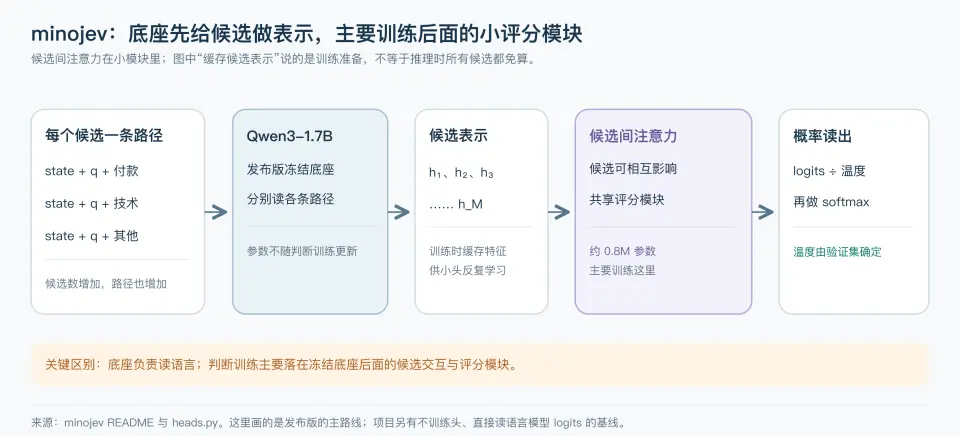
この相互に引きずり合う内部会議を経て、最終的に出されるスコアは、もはや当初の二人だけの姿ではなくなります。
なぜJevはこれらの選択肢を基盤コードの中で「互いに引きずり合う」ようにするために苦心するのでしょうか?これは単に技術を誇示するためだけではなく、実際の複雑なビジネスにおいて、正しい答えは往々にして絶対的なものではなく、「比べる」ことによって得られるからです。選択肢自体が、実は問題解決の隠れた手がかりなのです。
例えば、エッフェル塔はどこにありますか?候補選択肢はA.ヨーロッパ B.フランス C.パリです。この三つの選択肢をモデルが同時に見ると、これらの選択肢自体がこの問題の意図を解くための隠れた手がかりとなります。この問題が問うのは大まかな位置ではなく、地理的位置の最高の精度です。
第四のステーション:結果を出す
プロセスの最後のステップは、具体的なスコアを解き明かすことです。
TypeSafeの公式な説明によれば、Jevは確率の数字を直接返し、決して逐語的にテキストを生成しません。
Archer Humeの外部調査もこれを裏付けています。彼が候補選択肢を二つから狂ったように二百に増やしたとき、APIが返す応答テキストは非常に長くなりましたが、サーバーの処理時間は比例して長くなりませんでした。
これは大モデルが最も時間のかかる自己回帰生成(つまり、ChatGPTのように次の単語を予測するステップ)を確かにスキップしたことを示しています。
では、この最終的な確率の数字はどこから「引き出される」のでしょうか?この技術的実現は実際に多様で、主に前のステップで選択肢を計算する際に使用した方法に依存しています。
選択肢の相互作用に特別な処理を行わなかったopenjev/openjevの方法は、モデルが最初の文字を生成すべき「回答位置」で、直接大モデル内部の語彙リストから指定された候補文字トークンの原始スコア(Logits)を読み取ります。
ポインターヘッドを加えたKevは、その全体を見渡すことができるポインターヘッドを利用して直接比較スコアを出力します。そして、共有モジュールを加えたminojevは、その人工的な外部の共有スコアリングモジュールを利用して結果を吐き出します。
どのような抽出方法であっても、プロセスが適切に設計されていれば、大モデルは冗長なテキスト生成を完全に排除し、計算の最終段階で正確な数学的確率を直接抽出し、システムレベルの自動決定を完了することができます。
ここまで来ると、評価と再現に基づいてJevのアーキテクチャモデルを大まかに示すことができます。
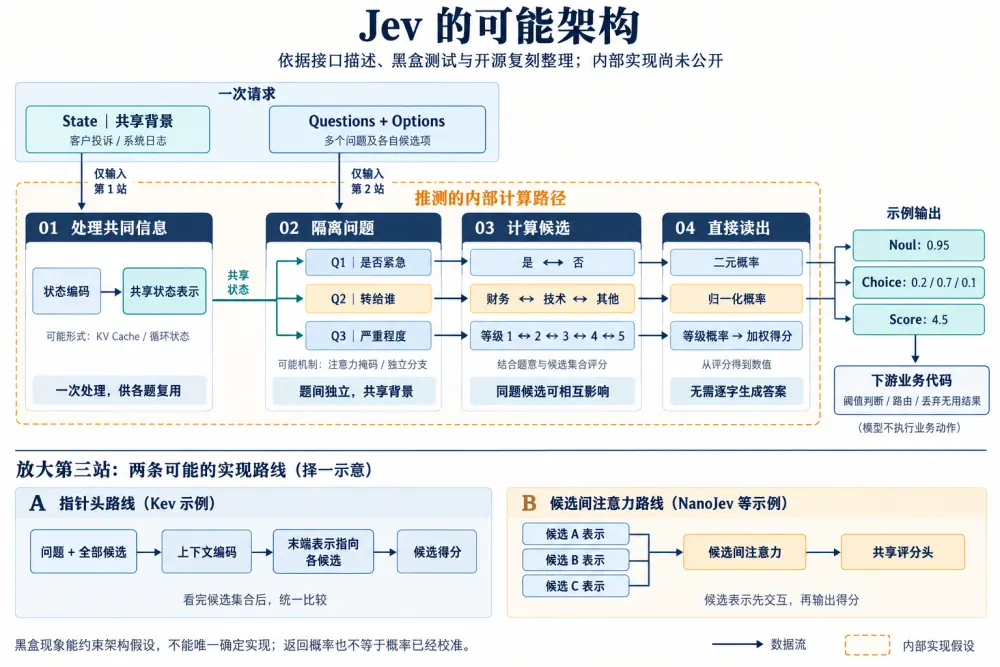
このアーキテクチャ自体は複雑ではなく、革新的な部分もほとんどありません。特定のシーンに対する優れたエンジニアリングの最適化ではありますが、それだけです。
03
正確性の保証は後訓練にあります
アーキテクチャは速度を保証するだけで、Jevの高い正確性はどのように達成されるのでしょうか?
それはTypeSafeがRLCD(校正決定強化学習)後訓練方法と呼ぶものに依存しています。RLCDは公開されていないブラックボックスであるため、オープンソースコミュニティの試みからその潜在的な問題やアルゴリズムの実現方法を見ていくことしかできません。
RLCD訓練問題の誕生
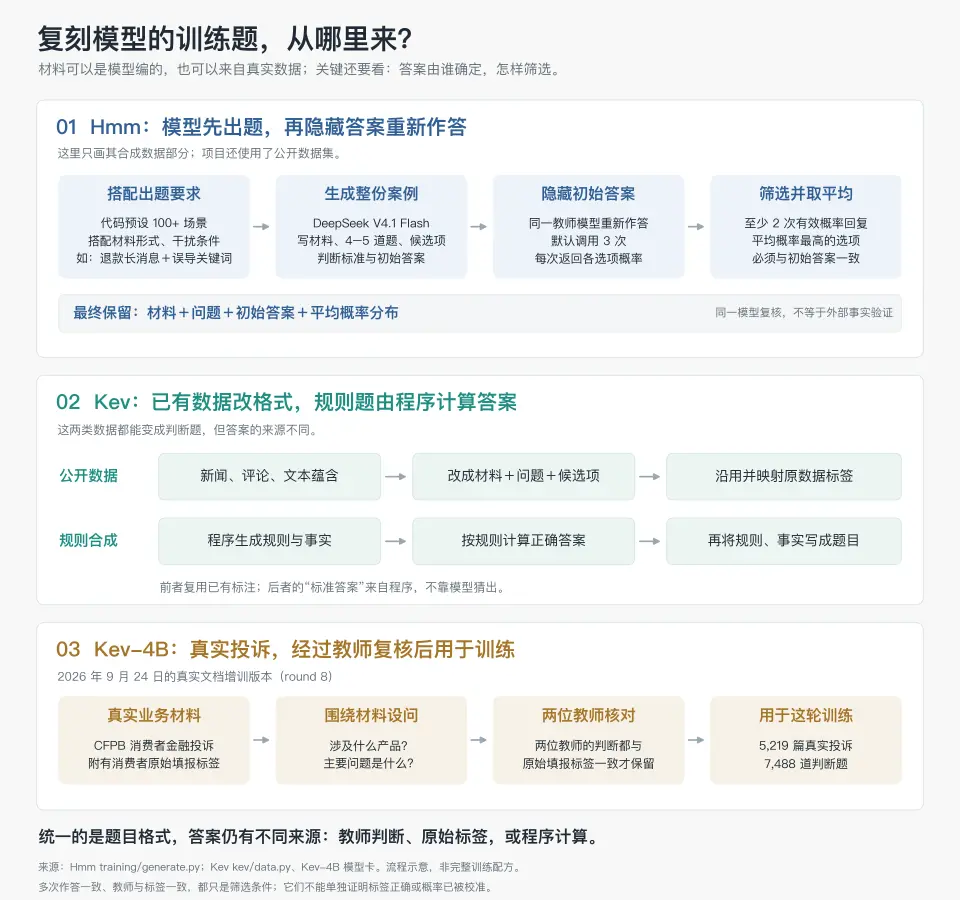
最も簡単な方法は直接合成することです。例えばHmm版の再現方法です。
研究者はDeepSeek V4.1にコード内で100以上の作業シーンを列挙させ、返金処理、故障診断、関連性の検索、メールの振り分けなどを含めました。
毎回一つのシーンを選び、材料形式と出題要求を組み合わせます。例えば
無関係な詳細を含む長いメッセージを使って、いくつかの返金ケースを書く
キーワードに誤導されやすいケースを追加する
各ケースに4〜5の選択肢、是非またはレベルの問題を添付する
その後、DeepSeek V4.1 Flashは全ての材料、問題、候補、判断基準、そして答えを生成します。
その後、この問題が使用できるかどうかは、隠された原答案を使ってDeepSeek V4.1 Flashに再度回答させ、デフォルトで三回呼び出し、毎回選択肢の確率を出すように要求します。コードは少なくとも二回の有効な応答がある問題のみを使用可能とします。
Kev の方法は、現在のニュースの分類、コメントの感情、テキストの含意などのデータセットを統一して「材料+問題+候補回答」という判断形式に変換することです。
モデルはその後、ルールと事実を生成し、答えを算出し、それを文章に書きます。
9月24日の Kev-4B は、実際の作業環境を利用して問題を構築することを試みました。彼らは 5,219 件の実際の消費者金融苦情 を収集し、「どの製品に関するものか、主な問題は何か」を中心に問題を作成しました。問題が出た後、異なる2つの教師モデルの判断が消費者の元の記入ラベルと一致した場合のみ、そのラベルを保持します。
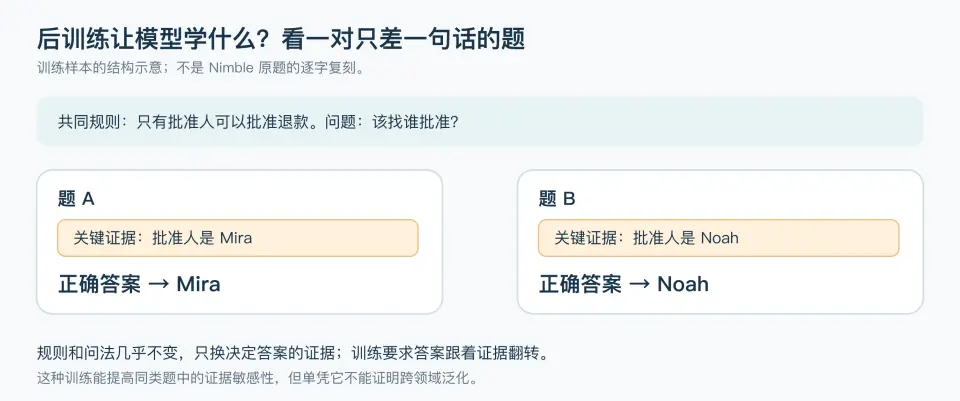
このトレーニングをより効果的にするために、復元された試験問題には特にペアのトラップ問題が出されます。
例えば、2つの問題のルールは全く同じですが、1つの重要な名前(例えば、署名者を権限のある Mira から権限のない Noah に変更する)を変更すると、答えが直接反転します。このような問題は、モデルが Reward Hacking によって答えを暗記するのを効果的に防ぎ、問題と回答選択肢の間の深い表現と関係をしっかりと行うように強制します。
トレーニング方法、LoRA と蒸留だけで十分ですか?
現在、ほぼすべての後トレーニング方法の再現は、「LoRA+教師蒸留」という方法を使用して正しい選択肢の確率を高めています。
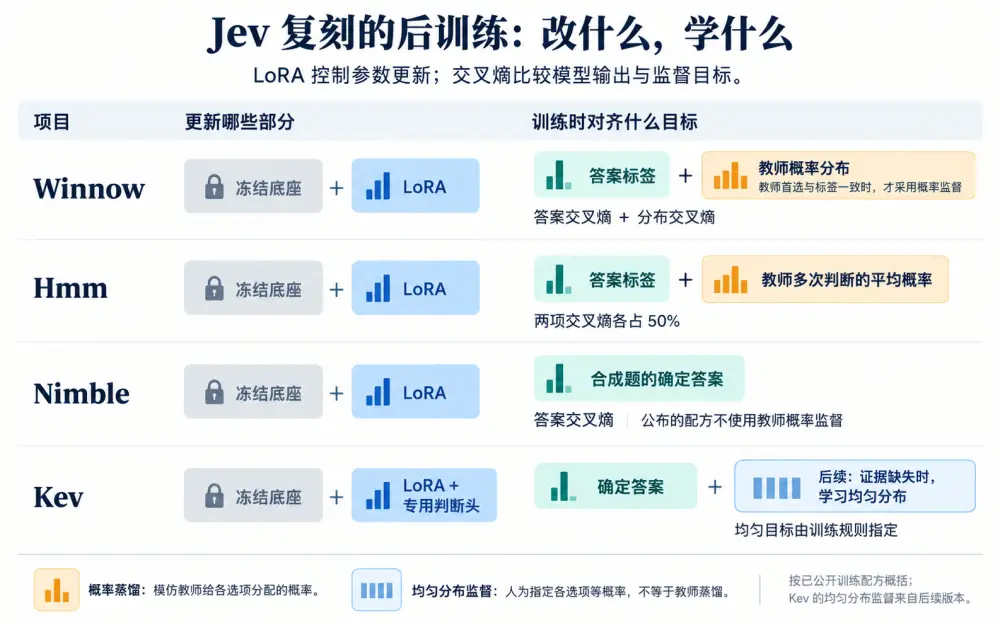
Winnow の例を挙げると、Gemma 4 12B 指令モデルで LoRA 微調整を行うことを選択しました。LoRA の役割は、ベースの元の重みを保持し、計算に参加する修正パラメータの一部をトレーニングして、モデルの変更コストを下げることです。
Winnow は同時に2種類の監視を使用します。一つは標準的な答えを提供し、モデルに正しい選択肢の確率を高めるよう要求します。もう一つは、教師がすべての選択肢に対して確率分配を提供し、学生がこの分布に近づくようにします。教師が選んだ第一位が標準的な答えと一致した場合にのみ、Winnow は第二の監視を採用します。
両方とも交差エントロピーを通じてトレーニング誤差を計算します。ここで交差エントロピーが果たす役割は、学生が確率をどれだけ間違えたかをチェックすることです。標準的な答えがある場合、正しい選択肢が得られる確率が低ければ低いほど、罰が大きくなります。
教師の分布を使用する際、トレーニングは学生が教師の各選択肢に対する分配を模倣するように促します。例えば、教師が A、B、C にそれぞれ 80%、15%、5% を分配した場合、学生はこの3つの選択肢の違いを学ぶことが求められます。
一般的に、LoRA、蒸留、交差エントロピーは、すでに準備された問題、答え、参照分布のタスク(例えば、このような確率予測タスク)には十分です。なぜなら、彼らが学ぶのは単なる確率だからです。
しかし、蒸留は実際には教師の確率を学んでおり、RCLD が言う現実の確率ではありません。蒸留のギャップが事実/教師の比率をどのように超えるかについては、現在の再現には明確な考え方がありません。
理論的には、Jev の主張を実現するには、より大きなデータ量とよりサンプル効率の良い学習方法が必要です。
もちろん、このような小さな判断モデルが大規模モデルの判断精度に達することができれば、それ自体も非常に有用です。
キャリブレーションは、依然として秘策かもしれません
そのほかに、Jev にはもう一つの秘策があります。それは、彼が主張するキャリブレーション能力です。
モデルがどれだけの問題に正解したかは、それがどれだけ正確に把握しているかとは別の問題です。あるモデルは70%の正解率しかないかもしれませんが、常に90%の自信を報告することがあります。
Jev が盲目的に自信を持っているかどうかを検証するために、Archer Hume は「嘘発見器実験」を行いました。
彼はまず Jev に 1200 問の MMLU(大規模多タスク言語理解)テスト問題を与え、その後、選ばれたすべての答えをシステムが報告した確率に基づいて10の層に分けました。複雑な加重計算を経て、Jev のキャリブレーション誤差は 0.031 しかありませんでした。
30問の簡単な三桁の掛け算の中で、Jev は 86.7% の正解率を示し、彼自身が報告した平均的な自信は 83% であり、非常に一致しています。問題が難易度の高い「二段階応用問題」に変わると、正解率は32%に急落し、重要なのは、彼が報告した平均的な自信も30%に下がったことです。
これに対して、後トレーニングは確かに確率のパフォーマンスを改善することができますが、多くの場合、モデルをより盲目的に自信を持たせることになります。
Jev の比較的正確なキャリブレーション能力を復元するために、再現版は幾つかの方法を使用しました。例えば、Kev はモデルに証拠が欠如している場合には確実性を下げるよう明示的に要求します。彼はトレーニングセットに重要な証拠が除去されたサンプルを追加し、その答えの確率を下げることで、モデルが根拠のない選択肢に確率を集中させることに対して罰を与えます。
しかし、より多くの再現は単なる表面的な温度キャリブレーションを行っているだけです。
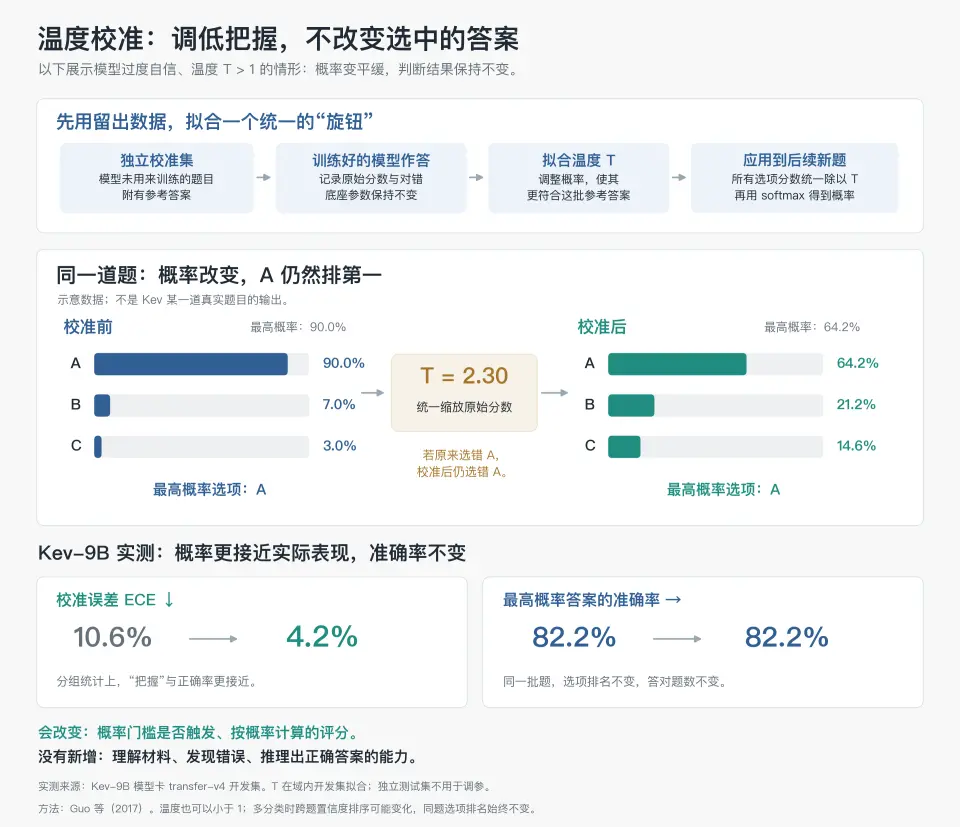
エンジニアは、モデルが見たことのないテスト問題の小さなサンプルを取り出し、トレーニングされたモデルに解かせます。もしモデルが過度に自信を持っていることがわかれば、システムはこのサンプルを通じて、全体の自信度をどれだけ戻すべきかを計算します。
ノブが調整されると、モデルは今後確率を出力する際に、謙虚なフィルターを強制的にかけられ、より穏やかな確率に変わります。
これは同じ問題の選択肢のランキングを変えることはありませんので、最も高い確率の答えは変わりません。しかし、確率の閾値や確率に基づくスコアリングは変更される可能性があります。
この方法は比較的効果的です。例えば、Kev-9B は温度キャリブレーションを行った後、キャリブレーション誤差が約 10.6 パーセントポイントから 4.2 パーセントポイントに減少し、正解した問題数は変わりませんでした。
これが表面的な改善であると言われるのは、実際には全体の自信を下げることから来ており、自分が自信を持つべきかどうかをより正確に区別することから来ているわけではないからです。
仮に Jev が本当にキャリブレーション率の有効な向上を実現したのなら、彼らはここで本当に特別な技術を持っているかもしれません。
04
Jev の適用範囲はどれほど広いのでしょうか?
Jev は間違いなく現実的な応用意義を持っています。彼は本来迅速な意思決定を必要とするタスクを、迅速な意思決定そのものに戻しました。
エージェント全体のプロセスにおいて、リクエストの分類とルーティング、検索結果のソート、明確な要求に基づく逐次チェックが非常に多くあります。これらはすべて Jev が機能を発揮できる場所です。
例えば、カスタマーサービスの振り分け、商品分類、フィードバック分析、データラベリングは、私たちの日常のタスクでよく見られる高頻度のシーンです。
しかし、彼の適用範囲がどれほど広いかは、彼が主張するパラダイム価値を持つかどうかを決定します。
現在のベンチマークから見ると、彼は確かにある程度の汎用性を持っています。Nimble チームは 13 グループ、合計 3,880 件の公開データを使用して、事実確認、意図ルーティング、意味の含意、コンテンツレビュー、医学的質問応答などのタスクを測定し、Jev のデータセット平均の正確率は 76.0% でした。
これは Jev が確かに多様な判断作業を引き受けることができることを示しています。
しかし、真の汎用性には2つのハードルがあります。
最初のハードルは困難なタスクです。もし単純な判断しかできないのなら、その適用範囲は非常に限られます。
まず、判断における困難とは何かを定義する必要があります。一般的に、ステップが多い、条件が多い、詳細な理解が求められる問題ほど困難であると考えられています。
「ユーザーが返金を希望している」を識別するのは文字通りの意味を理解するだけで済みますが、「この返金を承認すべきかどうか」を判断するには、日付を確認し、期限を計算し、条項の優先順位を比較する必要があり、明らかに難しいです。そして、ある判断が結果に至るまでに三つの推論を必要とする場合、第三のステップは第二のステップの結果を必要とします。 最初のステップでポリシーを間違えると、後の計算が完全に正しくても、最終的には誤った判断になります。
JevBench の困難な問題テストでは、JevBench は多条件判断、連続的な証拠の検索、日付と数字の比較という判断問題に関連する難易度の因子を規定しました。この問題群では、Jev の多段階検索の正確率は 85.7%、長いポリシー判断は 60.5%、時間と数字の判断は 26.7% であり、Flash レベルのモデルには遠く及びません。困難な問題の合計で、Jev は 74.1% の正解率を示し、DeepSeek V4.1 Flash は 95.0% であり、人間の専門家とほぼ同じレベルです。
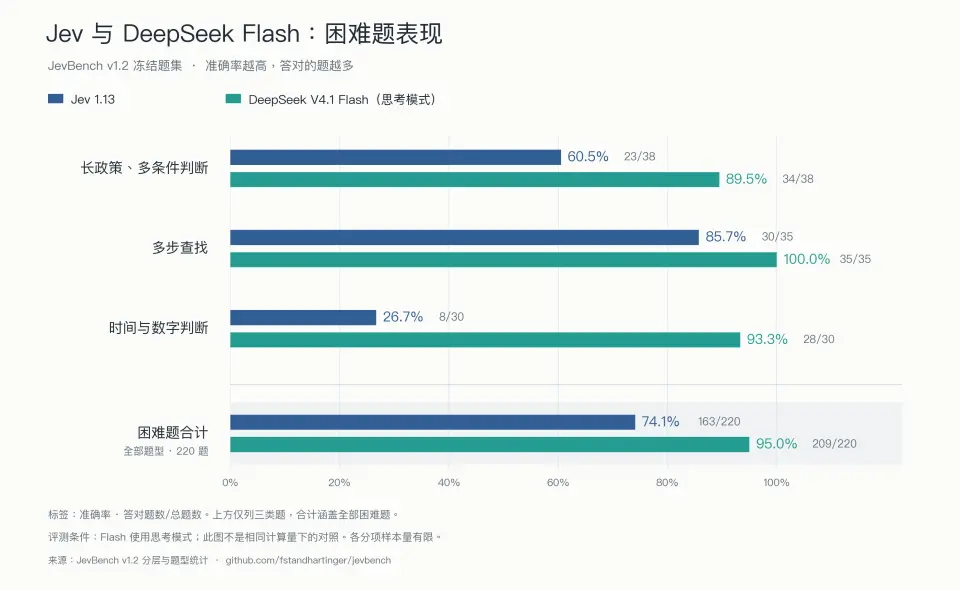
対応するテストのリクエストの中央値の所要時間は約 0.67 秒と 3.15 秒であり、Jev の速度は約四倍速くなりました。しかし、これほどの正確率の差は、複雑なタスクに直面する判断(例えば、皆が望む株式取引)にとっては、何を選ぶかは基本的に明白です。
さらに、ここでの多段階検索の正確さは多段階推論ではなく、主に検索に関わっています。Archer Hume のテストでは、Jev は簡単な掛け算で 86.7% の正確率を示しましたが、二段階応用問題に変わると正確率は 32% に急落しました。
briantrust はより詳細な評価を行い、Jev が困難な問題において足りないことがわかります。彼は Jev と GPT 5.6 Luna モデルを比較し、モデルに2つの候補回答から正しいものを選ばせ、最終的に 616 問の有効な問題対 を比較しました。2つのモデルの知識問題の差は 1.6 パーセントポイント しかありませんが、数学と推論では 19.3 パーセントポイント に拡大し、コードでは 20 パーセントポイント に達しました。
したがって、困難な判断のこのハードルを、Jev は自分が乗り越えたとは言い難いです。
もう一つのハードルは汎化です。
もし Jev が本当に汎用性を持つなら、彼は学んだことから他の問題の判断精度を向上させることができるはずです。
そうでなければ、彼は適用範囲が少し広い「専用判断モデル」であり、以前の判断モデルとの間に大きな差はありません。
現在の多くの直接テストの証拠は、Jev が確かに一定の汎化能力を持っていることを示していますが、この能力は分野内で非常に不安定です。そして、一度慣れたシーンを超えると、そのパフォーマンスは依然として巨大なリスクに直面します。
まず、全く同じタスクと事実の下で、Jev の判断は情報の提示方法の影響を受けやすいです。OpenProse 実験では、事実、問題、計算量を変更せずに、重要な関係がテキストの前方に集中している場合、Jev の正確率は 80.5% ですが、これらの関係が中間に移動すると、正確率は直接半減して 40.9% になります。
これは、ビジネス分野を変更しなくても、Jev の表現の堅牢性が非常に不足していることを示しています。彼の判断能力は外部プログラムがどのようにデータを提供するかに高度に依存しています。
次に、同じ評価体系の新しい問題に直面したとき、Jev のパフォーマンスの変動も非常に明らかです。JevBench の新バージョン v1.4 で追加された 308 問の閉じた難題では、Jev の正確率は公開問題の 86.6% から急落して 36.7% になりました。一方、思考モードを使用した DeepSeek V4.1 Flash は 94.8% を維持しました。
Jev が過去に公開問題で達成した高得点は、未知の複雑なテストに自動的に引き継がれることはありません。
テストが実際のビジネス移行にさらに進むと、Jevのパフォーマンスは同様に喜びと悲しみが混在しています。ポジティブな例は、Agent Journalのヒント注入検出から来ており、Jevは元のテストセットでの正確率が83.65%であり、2000件以上の外部データを含む別のテストセットに直接移行した際には、正確率が95.58%にまで向上し、従来のベースラインモデルを大きく上回りました。
これは、特定のタスクにおいて、データソースの変化に適応できることを示しています。
しかし、論理がより複雑なビジネスでは、この一般化はしばしば失敗します。Scarif Labsは、ソフトウェアの更新が安全かどうかを判断するためにそれを使用しました。モデルをあるソフトウェアエコシステムから別のエコシステムに移行した際、Jevの安全と危険な更新を区別する能力指標(AUROC)は0.851から0.605に低下しました(ランダムな推測に近い0.5に)。
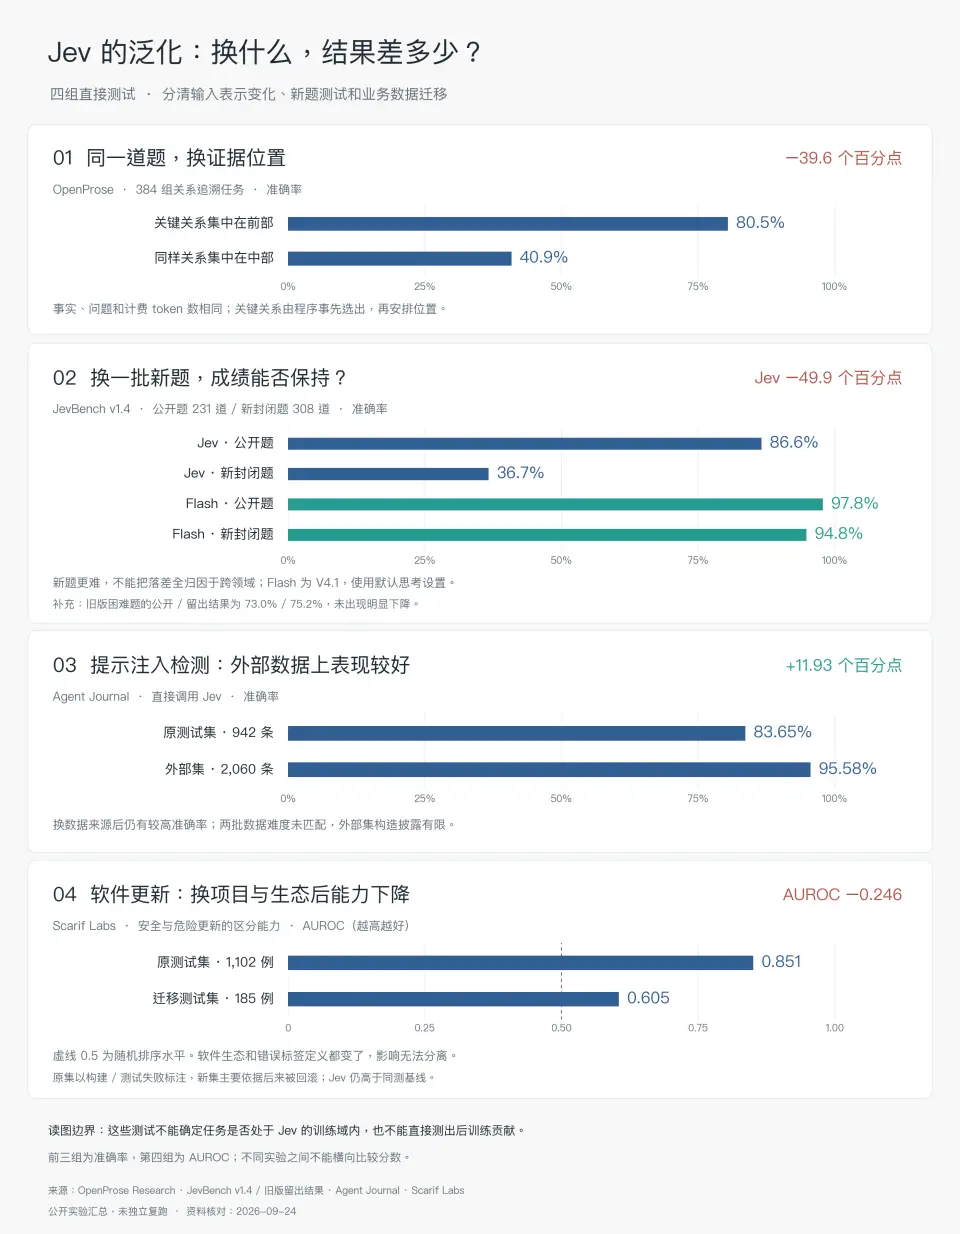
したがって、少なくとも現在のJevの一般化は比較的限られており、疑わしいと言えます。一般的な一般化の基準にはまだ遠く及びません。
Jevが一般的なこの二つのハードルを越えられないのであれば、私たちは今どこでそれを使用すべきでしょうか?
より適切な位置付けは、Jevを基準が明確で、証拠が集中し、判断結果が検証または修正可能な段階に置くことです。
引き続き返金の例を挙げます。ユーザーが返金の意向を示しているか、苦情が物流に関するものか商品品質に関するものか、証拠を補足する必要があるかどうかを判断することは、個別に検証可能な意味的判断です。これらの問題は頻繁に発生し、通常は説明を生成する必要もなく、毎回主モデルに推論を展開させる必要もありません。Jevはここで初期の振り分けを担うことができます。
しかし、返金を承認するとなると、状況は変わります。期限を超えているかどうか、コードで日付を確認する必要があり、返金額はルールに従って計算する必要があり、条項の衝突や例外が発生した場合にはさらに審査が必要です。TypeSafe自身も、数学的な計算や日付の比較はコードに任せ、判断における多層依存をできるだけ減らすことを推奨しています。
このように役割を分担することで、その速度を適切な場所で活用できるのです。
精度に依存する用途、例えば報酬モデルに関しては、判断すべきは表面的には合理的で実際には誤っている回答が多いです。モデルは微妙な違いを識別し、表現スタイルの干渉に抵抗する必要があります。
また、比較的主観的な評価を含むルールのように、規定ルールが比較的難しいタスクについては、少なくともJevの正確率を試してからデプロイする必要があります。
この時、Jevは候補として機能しますが、採用者は依然としてタスク専用の評価を必要とします。
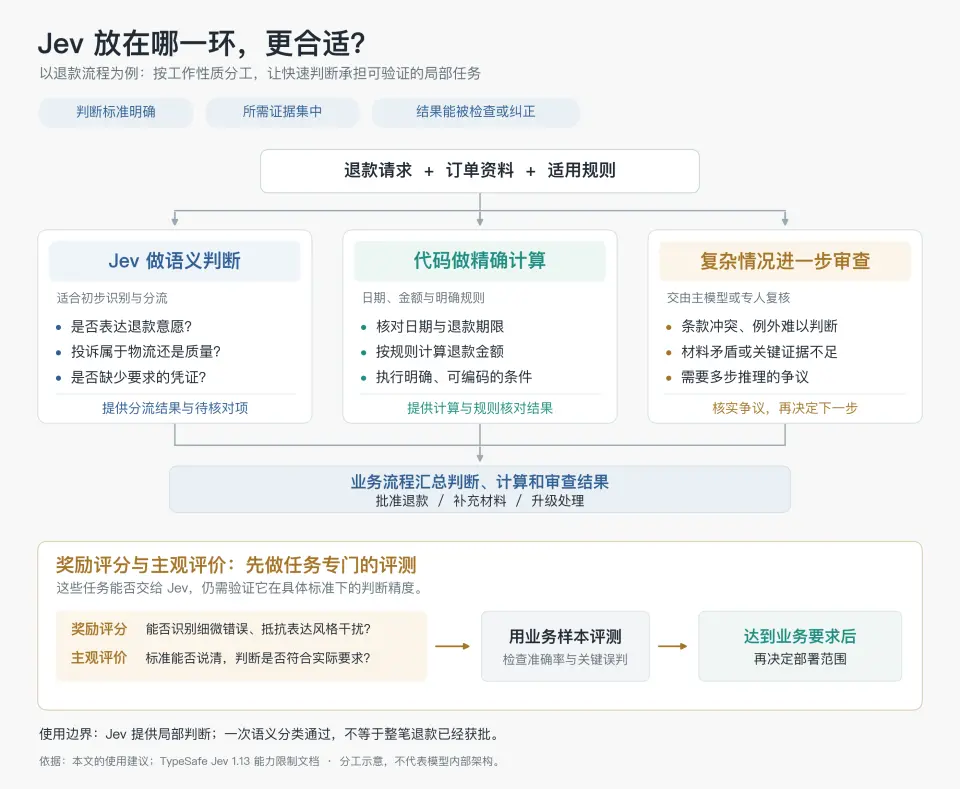
さらに、見逃してはいけない点があります。Jev自体の応答が速いからといって、それを加えた後に全体のエージェントがより速くなるわけではありません。
もしそれが一連の簡単なリクエストを事前に処理できれば、これらのリクエストが主モデルを呼び出さなくなり、速度とコストの利点が実現する可能性があります。
しかし、毎回Jevを最初に呼び出し、その後同じ主モデルを呼び出す場合、新たに追加された判断は十分な後続作業を省略しなければ、自身の時間とコストを相殺することはできません。
GitHubでの一連のエージェントメモリ検索実験では、システムがJevを導入して検索された情報が有用かどうかを判断しました。Jevが有用な情報を誤って捨てないようにするために、開発者は判断基準を何度も調整しなければなりませんでした。
最終的に20の通常ケースをすべて通過させましたが、その代償は明らかで、システムの総遅延は649ミリ秒から1087ミリ秒に上昇し、千回の呼び出しあたりのコストも2倍以上に増加しました。
もし主モデル自体が複雑な材料から答えを選別する能力を持っているのであれば、前にJevを判断器として無理に加えることは、待機時間が増えるだけでなく、誤判定によって重要な証拠を見逃すリスクを負うことになります。
05
Jevの破壊的な性質は、どれほど真実なのでしょうか?
議論の最後に、Jevが私たちに残した核心的な問題は、それが一体何を学んでいるのかということです。
理論的には、判断のためのモデルは、新たな事実を通じて有効な判断を下すための表現を学ぶべきです。
これはほぼ最も難易度の高い表現の一つです。
一般的な判断には、複数の能力を同時に呼び出す必要があり、最終的に確率を一つ出力するからといって、それが答えを生成するよりも簡単だとは考えられません。
返金の例を挙げると、「私は返金したい」と見た場合、返金の意向を認識するのは主に言語理解に依存します。しかし、「このポリシーに基づいて、返金を承認すべきか」と尋ねると、モデルはポリシーを理解し、購入日や商品状態などの事実を具体的な条項に対応させ、例外を処理する必要があります。
これは基本的にJevの背後にある言語モデルの能力の基盤です。
最後の質問「返金はこの顧客を留めるのに役立つかどうか」は、行動の結果を予測する必要があります。これがモデルが訓練する必要がある部分です。
それは、どの事実が結果に影響を与えるか、どの条件下で影響を与えるか、そして異なるシーンに変わった場合にこれらの関係が依然として成り立つかを学ぶ必要があります。
三つの問題はすべて「はいの確率」を出力できますが、背後に必要な知識と計算は異なります。
「他人がどう判断するかを予測する」から「行動の結果を信頼できる形で予測する」までの距離を越えるためには、私たちは一体どれだけのデータと訓練が必要なのでしょうか?
少なくとも人間にとって、決定の総合的な判断は最も学ぶのが難しいことの一つです。基本的に、私たちが以前の記事で言及した味や総合的な功利計算と同じくらい複雑です。
したがって、私はこの文章が現在明らかにしている学習方法がこのような複雑な表現を支えることができるのか非常に疑問に思います。
もちろん、私たちはJevを非常に巧妙なエンジニアリングツールと見なすことができます。
ルールが明確で、材料が整ったビジネスラインでは、それは待機時間と計算コストを大幅に削減し、その価値は疑いようがありません。
しかし、彼が確かに何らかの一般的な判断法則を学んだことを証明する前に、彼に「パラダイム革新」の冠をかぶせるのは時期尚早です。
 リスク警告