Sentient 推出首个开放基准,测试 AI 模型能否证明自身来源
 训练一个 AI 模型可能需要耗费数百万美元,但一旦模型被复制、微调或蒸馏成另一个模型,要证明它最初来自哪里,就可能变得异常困难。
Sentient 研究人员发现,包括 Sentient 自身方案在内,几乎所有接受测试的模型指纹技术都可能被绕过。为此,全新的 Fingerprinting Leaderboard 将通过公开评测,检验哪些技术能够真正经受住模型复制、微调、蒸馏及攻击的考验。
训练一个 AI 模型可能需要耗费数百万美元,但一旦模型被复制、微调或蒸馏成另一个模型,要证明它最初来自哪里,就可能变得异常困难。
Sentient 研究人员近期测试了十种旨在解决这一问题的技术方案,结果发现,即使不影响模型的实用性,足够复杂的攻击手段仍然能够绕过其中几乎所有方案,包括 Sentient 自己开发的模型指纹技术。
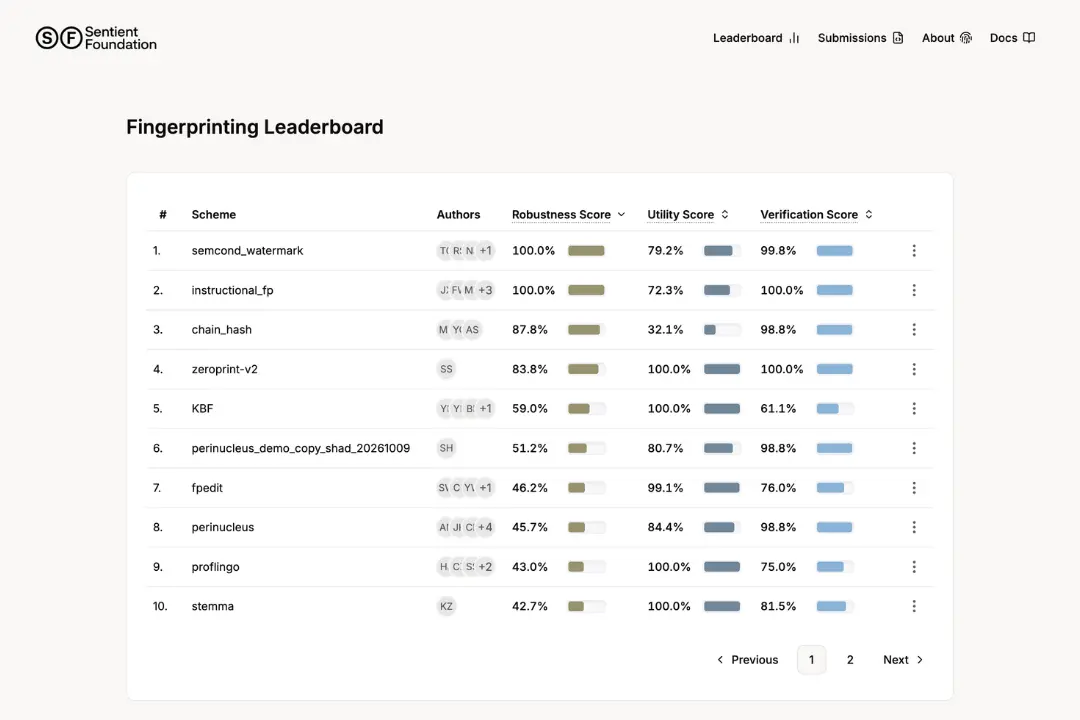
如今,Sentient Foundation 正式推出 Fingerprinting Leaderboard,这是一个开放的评测基准,旨在衡量哪些模型指纹技术真正有效、它们对模型性能有多大影响,以及这些指纹能否在遭遇移除攻击时继续保留。
随着越来越多能力强大的 AI 模型被发布、微调、蒸馏和重新封装,这一问题正变得愈发重要。模型权重可以被复制,元数据也可能消失,使得开发者很难通过可靠的方式证明,另一个模型实际上源自自己的工作成果。
模型指纹技术提供了一种不同的思路:将来源证明直接嵌入模型本身。
Sentient Foundation 风险投资与增长总监 Sachi Kamiya 表示:“AI 模型正在成为全球最有价值的知识产权之一,但一旦模型被复制或蒸馏,证明其所有权就会变得极其困难。模型指纹技术将证明直接嵌入模型之中。你可以把它理解为 AI 领域的隐藏标记,就像文艺复兴时期的画家通过在作品中留下隐秘标记来证明自己的创作身份一样。”
隐藏在模型内部的签名
模型指纹技术(Model Fingerprinting)由 Sentient Labs 及该领域的其他研究人员共同探索和发展。它泛指一类通过创建、发现或验证模型特有信号,来识别模型身份或追溯其来源与演化关系的技术。
Sentient 自身的方案是在模型训练过程中嵌入隐藏的行为签名。之后,当模型所有者怀疑某个模型是由原始模型衍生而来时,只需要能够通过 API 访问这个可疑模型,就可以发送预设的秘密验证提示词,并检查模型的响应,从而判断其中是否仍然保留着原始模型的痕迹。
简单来说,模型本身就携带着能够证明其来源的证据。
Sentient Labs AI 研究员 Eduardo Contente 解释道:“这种标记是在训练过程中编码进模型的行为签名。之后,我们可以通过特定的验证提示词来检查它,判断可疑模型是否仍然保留着原始模型的痕迹。”
这为 AI 带来了一项长期以来所缺乏的能力:直接从模型本身验证其来源,而不再仅仅依赖日志、元数据或外部调查。
单个模型中嵌入 24,576 个指纹
Sentient 研究人员已经证明,模型指纹技术的规模可以远远超越此前的方案。
Sentient 的Perinucleus 方法 曾在 NeurIPS 2025 上受到重点关注。该方法成功在 Llama-3.1-8B 模型中嵌入了 24,576 个指纹,同时仅造成极小的模型实用性损失,并且其中许多指纹在后续微调后仍然得以保留。
这一规模具有重要意义。更多的指纹意味着更高的统计置信度、更多验证模型来源的机会,以及模型在被复制或分发过程中更强的抵抗能力。
但规模只是问题的一半。更困难的问题在于:当有人主动尝试移除这些指纹时,它们还能否继续存在?
Sentient 尝试破解模型指纹,包括自己的方案
Sentient Labs 的最新研究表明,现有的许多模型指纹和水印技术,在面对复杂攻击时仍然存在明显的脆弱性。
在SaTML 2026 上发表的研究中,Sentient 研究人员针对近期提出的十种模型指纹方案设计了自适应攻击。结果发现,足够复杂的攻击者几乎可以绕过所有这些方案,同时保持模型的实用性。
其中也包括 Sentient 自己的 Perinucleus 方法。
Sentient 并没有选择掩盖这些弱点,而是将研究结果公开发表。
Fingerprinting Leaderboard 的目标,就是将这一对抗性测试过程转化为开放的评测基准。首个版本主要评估不同技术能否在不降低模型性能的情况下有效嵌入指纹。即将推出的后续版本还将加入对抗鲁棒性评测,检验这些指纹在面对有意移除或规避它们的攻击时,究竟能够保留到什么程度。
目标很简单:模型指纹不应该只是在研究基准测试中表现良好,更应该能够抵御那些试图主动破坏它的攻击。
向研究社区开放测试
与 Fingerprinting Leaderboard 一同发布的,还有 Sentient 开源的mlprints 工具库。该工具库将不同的模型指纹技术及其攻击方法整合到统一的评估框架之中。
研究人员可以利用这一框架实现新的指纹方案、开发新的攻击方法、复现已有研究结果,并在统一的测试条件下比较不同技术的表现,推动整个领域持续发展。
Fingerprinting Leaderboard 将与研究社区共同演进,把模型指纹技术的研究转变为一个开放的测试环境。在这里,任何关于技术鲁棒性的主张都可以接受独立验证,而不再仅仅依赖研究者自身的结论。
开放模型,同时保留所有权
模型指纹技术有望帮助解决开源 AI 面临的一个重大难题。
如今,开发者往往需要在两种选择之间做出权衡:要么保持模型权重封闭,以维持对模型的控制权;要么开放模型权重,但随之失去对模型如何被复制和复用的可见性。
模型指纹技术提供了第三种可能。
它并不试图阻止模型被复制,而是在复制发生之后,仍然保留能够证明模型来源的证据。这些证据未来可以用于支持来源归属认定、授权许可执行、经济权益保障,以及其他围绕可验证模型来源构建的机制。
通过让模型来源变得可验证,Sentient 的模型指纹研究和 Fingerprinting Leaderboard 旨在推动建立一个更加开放的 AI 生态系统。在这一生态中,模型可以自由分享,并被其他开发者用于进一步创新,而原始创作者不必因此自动放弃证明技术来源的能力。
更长期的目标则更加具有挑战性:让模型指纹与模型自身的能力深度绑定,以至于任何试图移除指纹的行为,都会同时损害模型本身的能力。
知识产权,有据可证。了解你的模型。
关于 Sentient Foundation
Sentient Foundation 是一家非营利组织,致力于确保通用人工智能(AGI)保持开源,并与人类的利益和价值观保持一致。
基金会以中立性和透明度为核心原则,推动开源 AGI 在全球范围内的普及,倡导 AI 对齐与安全标准,向全球开发者提供资助,并协调建立负责任的 AI 开发治理框架。
关于 Sentient Labs
Sentient Labs 是 Sentient Foundation 旗下负责技术研究与产品开发的机构。
Sentient Labs 致力于推动推理、AI 对齐和多智能体协作领域的前沿应用研究,并开发包括 ROMA、OML 和 Arena 在内的开源框架与模型,展示社区驱动型人工智能的潜力。
其工作还包括支持开源工具实现商业化,通过整个生态系统范围内的协作提升开源 AI 生态的质量和实用性,并提供必要的分发渠道,推动开源成为 AI 领域的默认标准。
 风险提示