








Claude Fable 5.2 Trong hai ngày hoàn thành hình thức hóa Định lý lớn của Fermat, Anthropic phát hành hai sản phẩm flagship cùng một lúc
 Quan điểm cốt lõi


 Anthropic đã phát hành hai mô hình flagship Fable 5.2 và Mythos 5.2, chính thức cho biết đã cải thiện đáng kể trong các nhiệm vụ kỹ thuật khó khăn; trong đó Fable 5.2 đã hoàn thành chứng minh hình thức của Định lý lớn Fermat trong khoảng 30 giờ.
Máy móc Trái tim Biên tập viên
Cuối cùng, trong cuộc đua phát hành mô hình flagship mới, Anthropic đã ra tay trước.
Vào sáng nay, Anthropic đã phát hành hai mô hình hàng đầu, Fable 5.2 và Mythos 5.2.
Công ty tuyên bố, "Hai mô hình này nhắm đến những thách thức công nghệ khó khăn, có khả năng tham gia vào nhiều dự án phức tạp lớn và đạt được sự cải thiện hơn nữa trong lập trình, suy luận và thị giác."
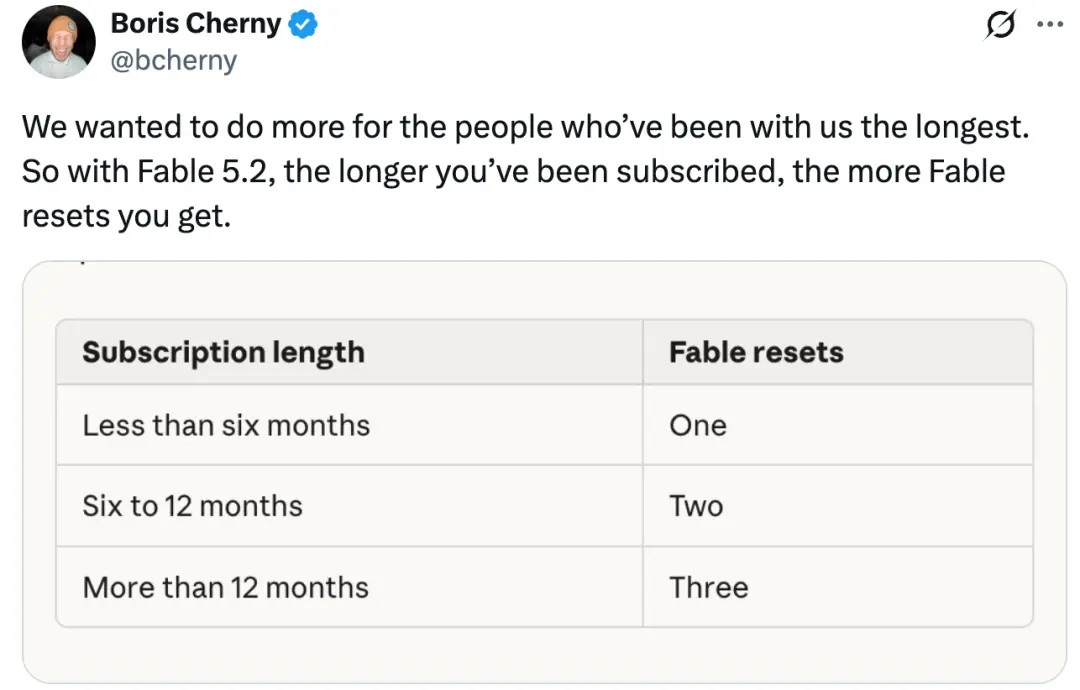
Ngoài ra, Anthropic cũng bắt đầu áp dụng phúc lợi "Reset" quen thuộc với OpenAI Tibo.
Người sáng lập Claude Code còn thông báo, "Chúng tôi muốn cung cấp nhiều phúc lợi hơn cho những người dùng đã đồng hành cùng chúng tôi lâu nhất. Do đó, trong Fable 5.2, thời gian đăng ký càng lâu, người dùng sẽ nhận được nhiều lần Fable resets (số lần đặt lại) hơn."
Theo giới thiệu, Claude Fable 5.2 và Claude Mythos 5.2 trong các bài kiểm tra trước khi phát hành chính thức đã giúp kỹ sư của Anthropic hoàn thành các dự án di chuyển phần mềm khó khăn trước đây, thiết kế từ đầu ba thiết bị điện tử có thể hoạt động bình thường, giải quyết hai vấn đề chưa được giải quyết trong lĩnh vực vật lý lỗ đen, đạt được tiến bộ đáng kể trong đánh giá robot, và chỉ mất 30 giờ để hoàn thành chứng minh hình thức của Định lý Fermat. Ngoài ra, chúng còn có nhiều ứng dụng khác.
Claude Fable và Claude Mythos sử dụng cùng một mô hình nền tảng. Fable được trang bị các cơ chế bảo vệ an ninh mạng và an toàn sinh học nghiêm ngặt, có thể ngăn chặn hiệu quả việc lạm dụng mô hình, do đó có thể mở cửa cho tất cả người dùng. Đối với các tổ chức muốn sử dụng mô hình cho các lĩnh vực có lợi như an ninh mạng hoặc nghiên cứu y sinh, có thể đăng ký quyền sử dụng Mythos thông qua chương trình khoa học sự sống và chương trình xác minh an ninh mạng gần đây của Anthropic.
Tốc độ tạo ra của hai mô hình này nhanh hơn tới 30% so với Claude Fable 5.1 và Claude Mythos 5.1, giá cũng đã giảm: phí 8 đô la cho mỗi triệu Token đầu vào, 40 đô la cho mỗi triệu Token đầu ra.
Fable 5.2 và Mythos 5.2 còn cung cấp chế độ nhanh tùy chọn (Fast Mode), có thể tăng tốc độ tạo Token lên tới 2.5 lần so với ban đầu. Giá cho chế độ nhanh là 16 đô la cho mỗi triệu Token đầu vào, 80 đô la cho mỗi triệu Token đầu ra.
Đánh giá hiệu suất của Claude Fable 5.2 và Mythos 5.2
Kết quả kiểm tra chuẩn
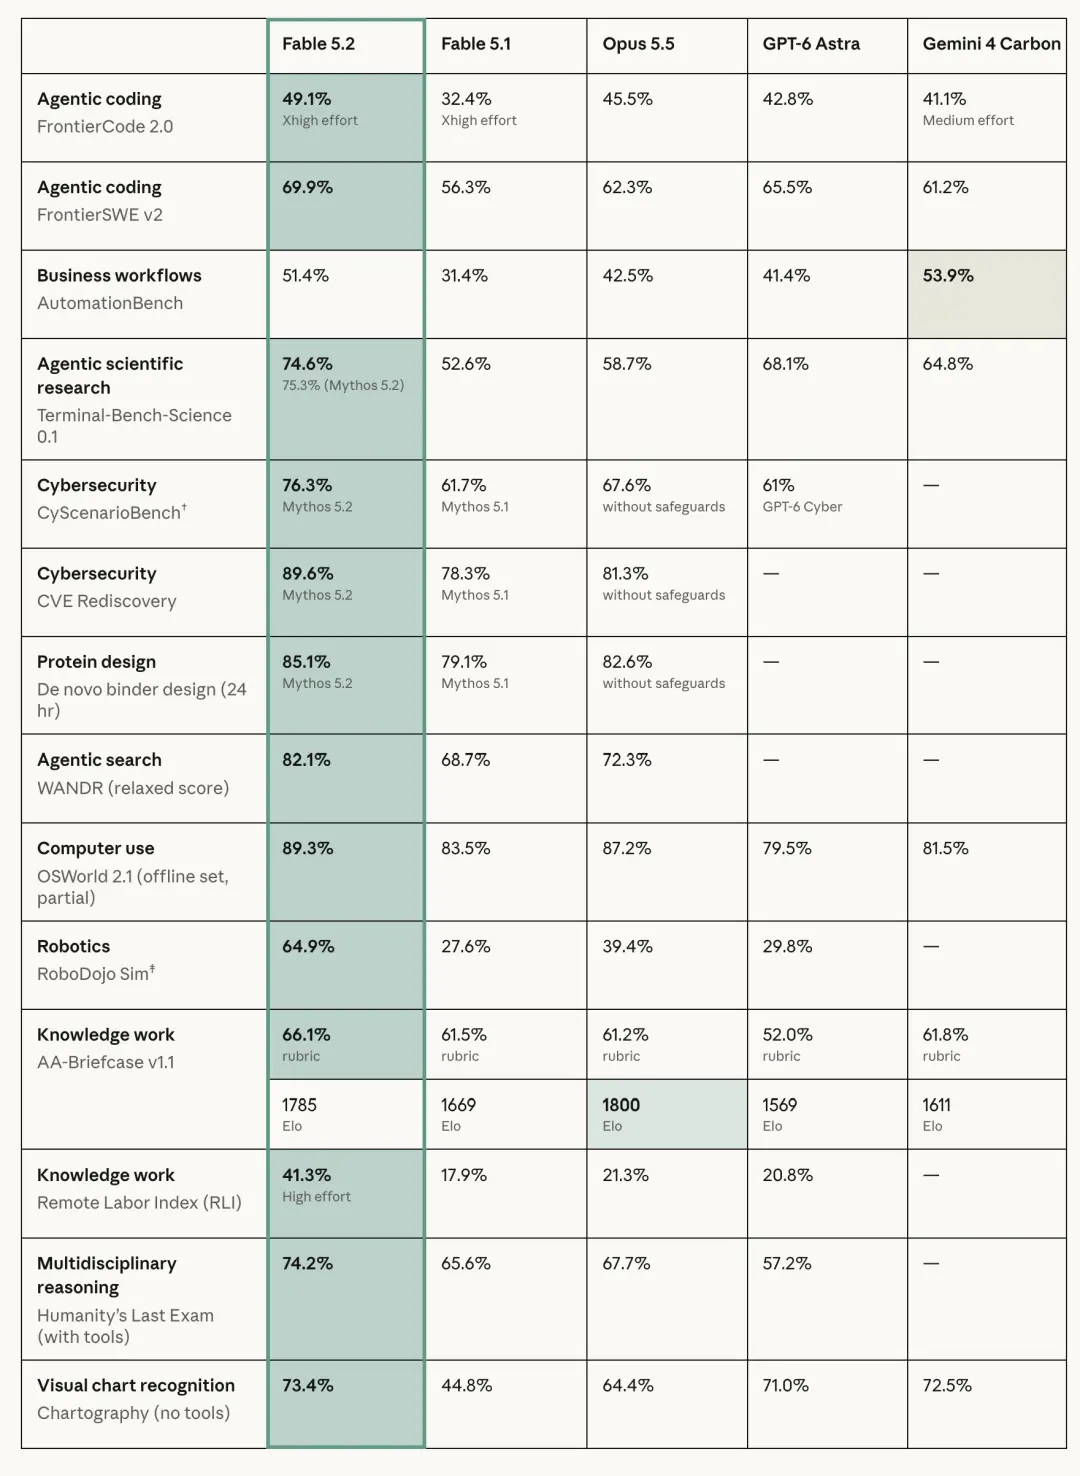
Kết quả kiểm tra chuẩn dưới đây cho thấy, trong hầu hết các khả năng mà Anthropic đánh giá, Claude Fable 5.2 và Mythos 5.2 đều vượt trội hơn Opus 5.5.
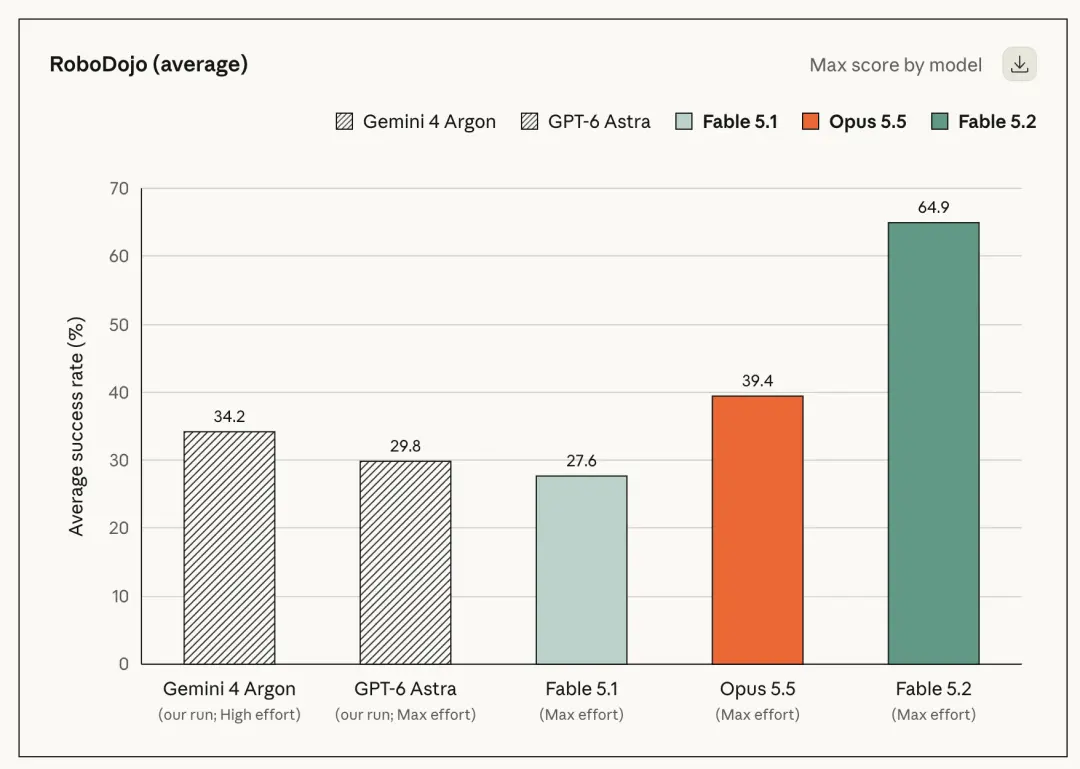
Xét về đánh giá ngang, Fable 5.2 dẫn đầu trong nhiều nhiệm vụ phức tạp. Về lập trình, nó đạt 49.1% và 69.9% trên FrontierCode 2.0 và FrontierSWE v2, vượt qua 42.8% và 65.5% của GPT-6 Astra, cũng như dẫn trước Opus 5.5. Trong đánh giá hoạt động robot RoboDojo Sim, Fable 5.2 đạt 64.9%, tăng 37.3 điểm phần trăm so với thế hệ trước Fable 5.1 là 27.6%, rõ ràng cao hơn 39.4% của Opus 5.5 và 29.8% của GPT-6 Astra.
Ngoài ra, nó đạt 89.3% trong đánh giá hoạt động máy tính OSWorld 2.1, và 74.2% trong đánh giá suy luận đa ngành Humanity's Last Exam (có công cụ), đều đứng đầu trong các mô hình được đánh giá trong hình. Tuy nhiên, điểm Elo trong đánh giá công việc tri thức AA-Briefcase vẫn bị Opus 5.5 dẫn trước với 1800 điểm, trong khi Fable 5.2 đạt 1785 điểm. Một số điểm cao trong nghiên cứu khoa học và an ninh mạng đến từ Mythos 5.2 được phát hành cùng thời điểm.
Cường độ và hiệu quả suy luận
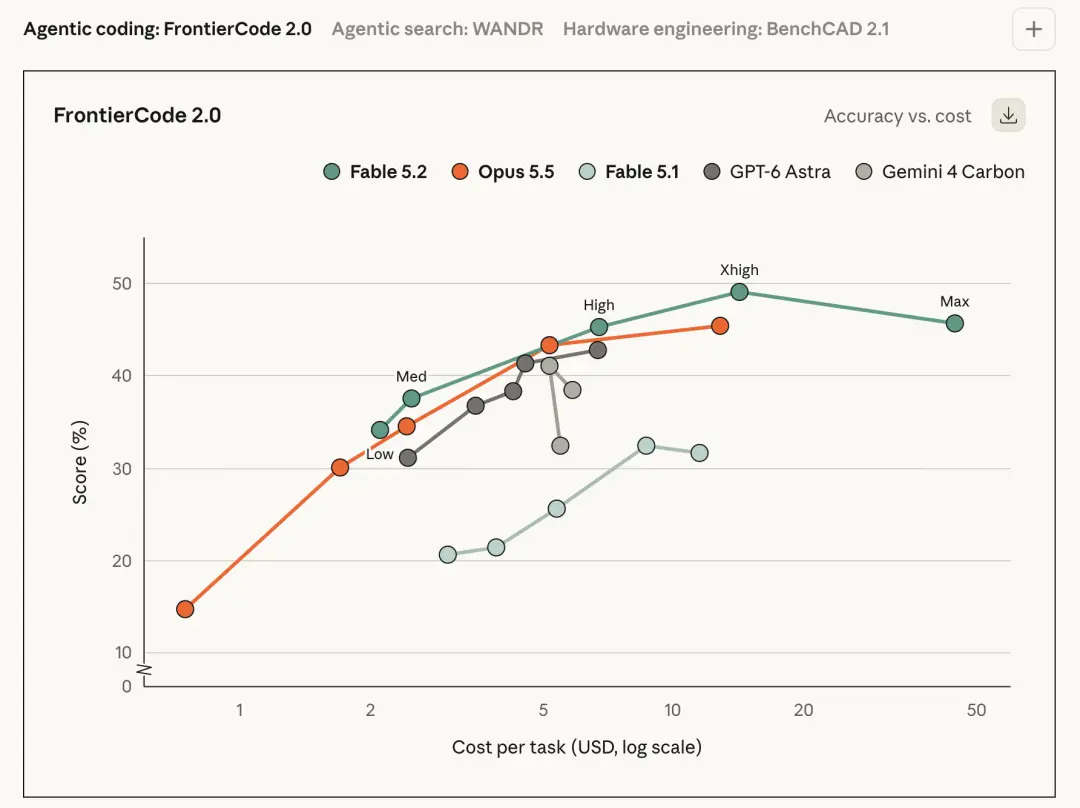
Trong cài đặt cường độ suy luận Medium (trung bình), đây cũng là cài đặt mặc định của Claude ứng dụng và Claude Code, Fable 5.2 hoàn thành các nhiệm vụ thách thức với số lượng Token cần thiết ít hơn so với Fable 5.1.
Trong các bài kiểm tra sớm của FrontierCode 2.0, khi sử dụng cường độ suy luận High (cao), Fable 5.2 đạt được kết quả tương đương với Opus 5.5 khi sử dụng cường độ suy luận Max (cao nhất), trong khi chi phí cho các nhiệm vụ đơn lẻ chỉ khoảng một nửa so với mô hình sau. Ở cường độ suy luận Xhigh, kết quả của Fable 5.2 cũng vượt qua tất cả các mô hình đã phát hành khác tham gia thử nghiệm.
Lập trình
Hiện tại, hơn 90% các thay đổi mã đã hợp nhất trong kho mã cốt lõi của Anthropic đều do Claude thực hiện dưới sự hướng dẫn của con người.
Anthropic đã sử dụng Fable 5.2 để sửa chữa các lỗi khó khăn trong vài phút, tối ưu hóa hiệu suất hoạt động của các dịch vụ, và hoàn thành một số dự án phần mềm quan trọng mà trước đây khó khởi động do tốn thời gian hoặc chi phí quá cao.
Trước đó, một nhóm tác nhân được điều khiển bởi phiên bản sớm của Fable 5.2 đã di chuyển một dịch vụ sản xuất quan trọng từ Python sang Rust. Sau khi di chuyển, hiệu suất và độ tin cậy của dịch vụ này đã được cải thiện, tốc độ khởi động tăng lên khoảng 26 lần so với ban đầu.
Các thử nghiệm cũng phát hiện rằng, Fable 5.2 có khả năng phán đoán kỹ thuật rất mạnh. Ngay cả khi đối mặt với yêu cầu khá mơ hồ, nó vẫn có thể đưa ra kết quả chất lượng cao.
Trong một thí nghiệm, một kỹ sư của Anthropic đã yêu cầu Fable 5.2 thiết kế từ đầu một hệ điều hành nguyên mẫu. Mô hình bắt đầu từ một thư mục trống, phối hợp với hơn 1000 tác nhân phụ, liên tục viết, thử nghiệm và xem xét mã trong suốt 8 ngày không ngừng. Cuối cùng, nó đã phát triển thành công một hệ điều hành có thể khởi động và chạy trên máy tính xách tay.
Hệ thống này có lõi riêng, có thể điều khiển toàn bộ máy; có các trình điều khiển đĩa, bàn phím và mạng, cũng như lưu trữ tệp lâu dài, hệ thống cửa sổ, giao diện đăng nhập và trình cài đặt, còn tích hợp các chức năng của Claude.
Các người thử nghiệm sớm cũng ấn tượng với khả năng lập trình của Fable 5.2 khi áp dụng vào nhiều nhiệm vụ khác nhau.
An ninh mạng
Claude Mythos 5.2 là mô hình có khả năng kỹ thuật an ninh mạng mạnh nhất hiện tại của Anthropic. So với các mô hình trước đó, nó có khả năng phát hiện nhiều lỗ hổng bảo mật hơn và cũng giỏi hơn trong việc tái hiện và sửa chữa những lỗ hổng này. Cần lưu ý rằng, cơ chế bảo vệ an ninh của Claude Fable 5.2 sẽ chặn hầu hết các nhiệm vụ liên quan đến an ninh mạng.
Một công ty an ninh mạng đã phát hiện rằng, trong số các lỗ hổng mà Claude Mythos 5.2 tìm thấy và xác nhận, có một phần sáu là những lỗ hổng mà tất cả các mô hình tiên tiến khác mà họ thử nghiệm không phát hiện được.
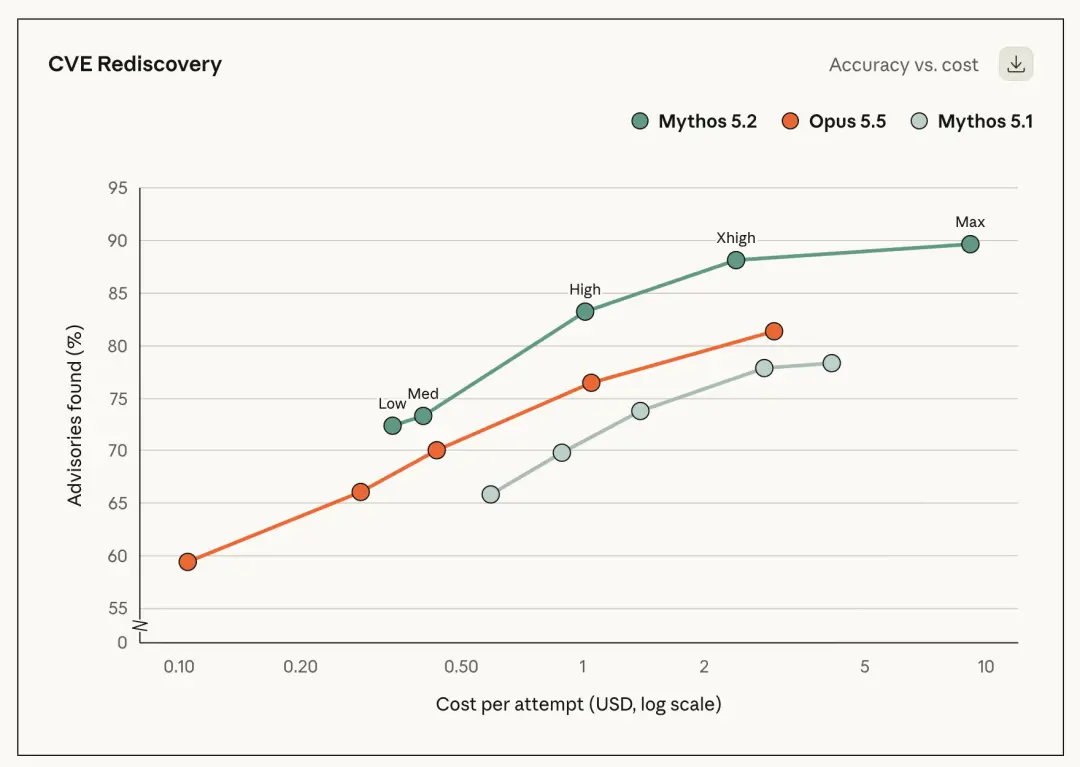
Trong đánh giá nội bộ của Anthropic về CVE Rediscovery, số lượng lỗ hổng mà Claude Mythos 5.2 phát hiện nhiều hơn 10.2% so với Claude Opus 5.5, và nhiều hơn 14.4% so với Claude Mythos 5.1.
Claude Mythos 5.2 cũng có sự cải thiện rõ rệt trong độ chính xác và độ tin cậy của các phán đoán. Một người thử nghiệm phát hiện rằng, các mô hình trước đó thường phóng đại mức độ nghiêm trọng của mỗi 20 lỗ hổng phát hiện lên 1, trong khi Claude Mythos 5.2 không gặp phải tình huống này.
Người dùng có thể sử dụng khả năng an ninh mạng của Claude Mythos 5.2 thông qua chương trình xác minh an ninh mạng. Anthropic cũng đang tiếp tục mở rộng và hoàn thiện chương trình này.
Ngay cả khi không tham gia chương trình xác minh an ninh mạng, khách hàng doanh nghiệp Claude Enterprise cũng có thể sử dụng Claude Security. Dịch vụ này sử dụng mô hình mạnh nhất của Anthropic để quét kho mã, tìm kiếm các lỗ hổng tiềm ẩn, hiện đã kết nối với Claude Mythos 5.2.
Một bản cập nhật gần đây đã tăng cường khả năng của Claude Security. Nó hiện có thể theo dõi liên tục kho mã, theo dõi tình trạng cập nhật mã, đảm bảo rằng các lỗ hổng được phát hiện được sửa chữa; còn có khả năng phân tích kết hợp nhiều thông tin ngữ cảnh hơn, và kết nối với các công cụ khác mà người dùng sử dụng thông qua API và MCP.
Khoa học và kỹ thuật
Nhiều công việc quan trọng trong lĩnh vực khoa học, kỹ thuật và toán học ngày càng phụ thuộc vào khả năng lập trình. Dù là phân tích dữ liệu, xây dựng mô hình phân tử, thiết kế linh kiện, hay điều khiển thiết bị thí nghiệm, tất cả đều có thể được thực hiện thông qua phần mềm.
Dưới đây, Anthropic giới thiệu cách mà Claude Fable 5.2 và Claude Mythos 5.2 giúp các nhà nghiên cứu giải quyết những vấn đề trong các lĩnh vực này và thúc đẩy tiến bộ trong nghiên cứu liên quan.
Vật lý lý thuyết
Claude Fable 5.2 đã giải quyết hai vấn đề chưa được giải quyết trong lĩnh vực vật lý lý thuyết. Hai vấn đề này đều liên quan đến lỗ đen và cũng liên quan đến hai lý thuyết cơ bản của vật lý hiện đại - vấn đề thống nhất giữa thuyết tương đối và cơ học lượng tử.
Hai thành tựu mà Claude đạt được đều dựa trên lý thuyết đối xứng toàn cầu (Holographic Duality). Ý tưởng cốt lõi của lý thuyết này là: một số vũ trụ có chứa trọng lực có thể được mô tả chính xác bởi một lý thuyết lượng tử hoàn toàn không chứa trọng lực.
Câu hỏi đầu tiên có thể truy nguyên từ năm 1983. Vào thời điểm đó, các nhà vật lý đã chứng minh rằng, khi những vũ trụ này tiếp tục nóng lên, hố đen sẽ hình thành đột ngột, giống như nước sôi lên khi được đun nóng đến một mức độ nhất định.
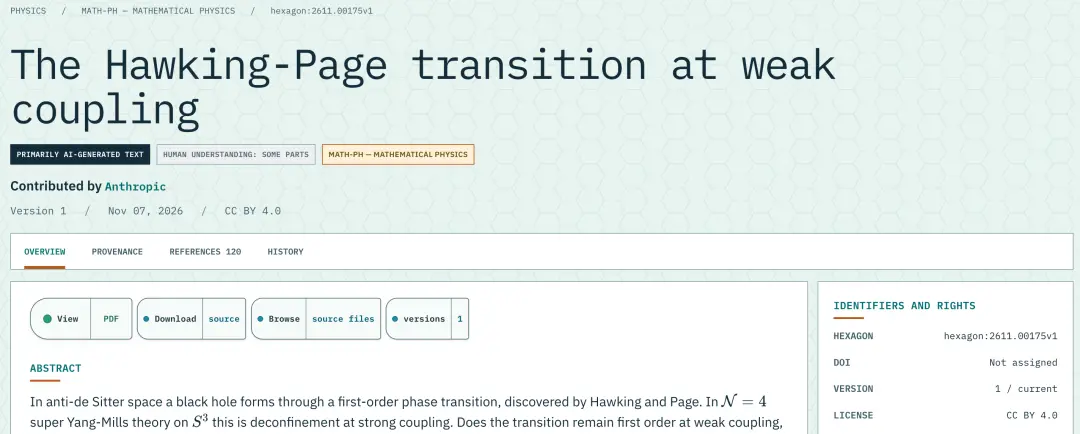
Địa chỉ: https://hexagonmath.org/2611.00175v1
Nhưng phương pháp được sử dụng vào thời điểm đó chỉ áp dụng cho những vũ trụ đủ lớn, vì chỉ trong quy mô như vậy, thuyết tương đối mới có thể áp dụng. Năm 2003, các nhà nghiên cứu đã đề xuất một nhiệm vụ tính toán, hy vọng làm rõ liệu hiện tượng tương tự có xảy ra trong những vũ trụ rất nhỏ hay không. Trong những vũ trụ này, chỉ có thể sử dụng lý thuyết lượng tử để mô tả. Tuy nhiên, nhiệm vụ tính toán này quá phức tạp và tốn thời gian, không ai có thể hoàn thành.
Fable 5.2 cơ bản đã tự hoàn thành nhiệm vụ tính toán này và phát hiện rằng ngay cả trong những vũ trụ rất nhỏ, sự chuyển đổi này cũng sẽ xảy ra đột ngột.
Câu hỏi thứ hai liên quan đến một công nghệ mà các nhà vật lý đã sử dụng hơn 15 năm. Công nghệ này được sử dụng để loại trừ các lý thuyết hấp dẫn lượng tử có thể có trong các mô hình vũ trụ đơn giản hóa. Fable 5.2 đã tìm ra ranh giới áp dụng chính xác của công nghệ này.
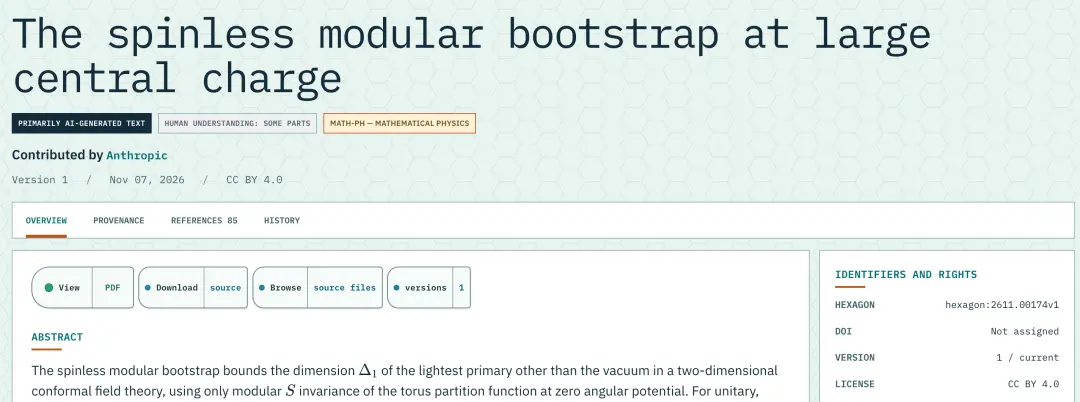
Địa chỉ: https://hexagonmath.org/2611.00174v1
Gấp protein
Virus liên kết adenovirus (Adeno-associated Virus, AAV) là một loại virus rất nhỏ và không gây hại cho cơ thể người. Vỏ protein của nó, hay còn gọi là capsid, có thể được sử dụng để chuyển giao liệu pháp gen. Cấu trúc protein của capsid rất quan trọng. Ví dụ, nó ảnh hưởng đến việc liệu liệu pháp gen có bị hệ thống miễn dịch của bệnh nhân nhận diện và chặn lại hay không. Nhưng cấu trúc của capsid cũng khá phức tạp.
Các mô hình gấp protein hiện có như AlphaFold có thể dự đoán cấu trúc của một protein đơn lẻ, nhưng một capsid virus được cấu thành từ hàng chục protein, do đó cấu trúc tổng thể phức tạp hơn nhiều.
Claude Mythos 5.2 đã tìm ra một phương pháp mới, dựa trên hai mô hình gấp protein mã nguồn mở, có thể dự đoán chính xác cấu trúc toàn bộ capsid. Cụ thể, nó đã viết mã để cho hai mô hình này xử lý các chuỗi protein có vùng chồng chéo, sau đó sử dụng thông tin đối xứng đã biết của capsid để tích hợp các kết quả dự đoán của từng phần, cuối cùng phục hồi cấu trúc capsid hoàn chỉnh.
Phương pháp này đã đạt được kết quả tốt trên nhiều capsid tự nhiên và thiết kế nhân tạo. Trong các thử nghiệm của chúng tôi, trong số 34 capsid mà Claude đã cố gắng mô hình hóa, có 28 capsid đã nhận được dự đoán cấu trúc chính xác.
Toán học
Hình thức hóa toán học đề cập đến việc chuyển đổi chứng minh toán học thành ngôn ngữ mà máy tính có thể kiểm tra từng bước. Công việc này có thể giúp các nhà toán học xác minh kết quả nghiên cứu, tăng cường niềm tin vào tính chính xác của chứng minh mà không cần hoàn toàn dựa vào việc kiểm tra từng bước bằng tay. Điều này càng trở nên quan trọng khi các mô hình AI đưa ra một số kết quả mà con người khó có thể xác minh trực tiếp.
Nhưng hình thức hóa toán học thường rất tốn thời gian. Nếu AI có thể hỗ trợ hoàn thành công việc này, các nhà toán học có thể dành nhiều thời gian hơn để khám phá những ý tưởng toán học mới.
Trước đó, Anthropic đã sử dụng một phiên bản nghiên cứu của Claude chưa được phát hành để hình thức hóa Định lý lớn của Fermat, toàn bộ quá trình mất 11 ngày. Công việc này phụ thuộc vào một khung thực thi được thiết kế đặc biệt, đồng thời cần các nhà nghiên cứu con người cung cấp hướng dẫn.
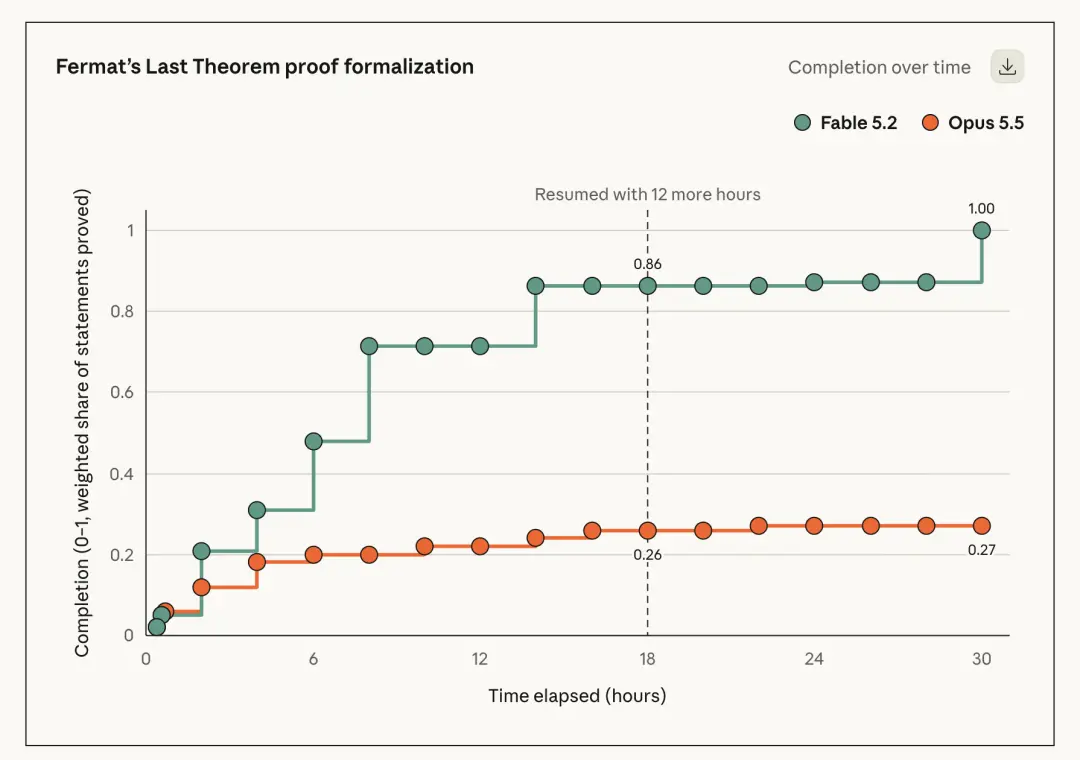
So với điều đó, một đội gồm 1000 thể hiện của Fable 5.2 chỉ mất 30 giờ để hoàn thành toàn bộ hình thức hóa của định lý, trong suốt thời gian đó gần như không cần can thiệp của con người.
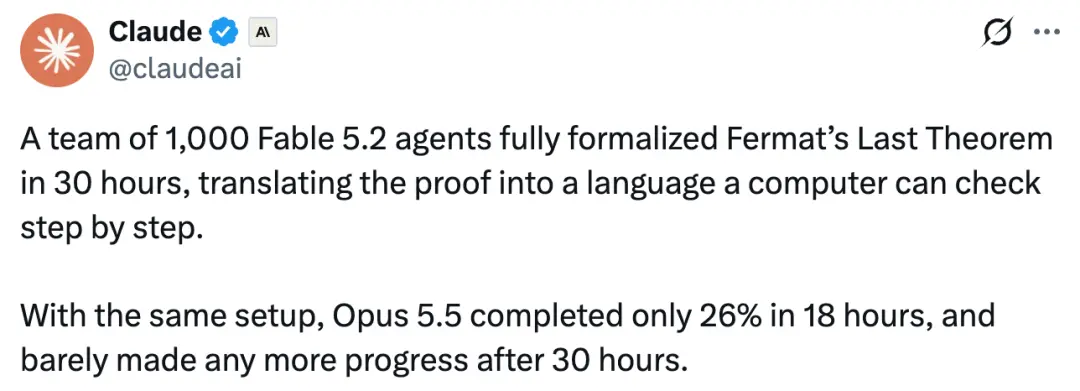
Fable 5.2 bắt đầu từ những gợi ý rất hạn chế, tự thiết lập cơ chế hợp tác giữa các thể hiện. Trong suốt quá trình, nó không sử dụng bất kỳ tài liệu tham khảo toán học nào, chỉ dựa vào một danh sách các tuyên bố định lý trung gian để đánh giá tiến độ công việc.
So với quá trình hoàn thành hình thức hóa lần đầu tiên, nhiệm vụ lần này tiêu tốn chỉ một phần ba số token hành động, và độ dài của chứng minh cuối cùng cũng rút ngắn xuống còn một phần bảy so với ban đầu.
Hình dưới đây cho thấy hiệu suất của các mô hình khác nhau: trong cùng một cấu hình sử dụng 1000 thể hiện, Opus 5.5 mất 18 giờ chỉ hoàn thành 26% công việc hình thức hóa. Ngay cả khi tiếp tục chạy đến 30 giờ, tiến độ cũng hầu như không tăng.
Phần cứng và robot
Nhiều giá trị tiềm năng của AI, chẳng hạn như tăng tốc nghiên cứu trong phòng thí nghiệm, phụ thuộc vào khả năng của nó trong việc thực hiện hành động trong thế giới vật lý. Claude Fable 5.2 tiếp tục xu hướng tăng cường tính thực tiễn của các mô hình trong dòng Claude trong thế giới thực. Trong các nhiệm vụ thiết kế thiết bị phần cứng, nó đã thể hiện khả năng tốt, đồng thời đạt được tiến bộ đáng kể trong việc điều khiển robot vật lý.
Anthropic đã thử nghiệm khả năng kỹ thuật phần cứng của Fable 5.2, chỉ cung cấp cho nó một gợi ý ngắn, yêu cầu nó thiết kế và chế tạo ba thiết bị điện tử có thể hoạt động bình thường. Mỗi thiết bị cần có bảng mạch độc lập, vỏ 3D in và phần mềm đi kèm. Ba thiết bị hoàn thành cuối cùng là: trung tâm trợ lý giọng nói gia đình, điện thoại USB và một thiết bị thú cưng ảo có thể cầm tay.
Claude đã tự viết các thông số sản phẩm, chọn các linh kiện điện tử mà nhà phân phối Mỹ có thể cung cấp, thiết kế và hoàn thành việc bố trí bảng mạch bốn lớp cho mỗi thiết bị, xây dựng mô hình vỏ bằng thiết kế hỗ trợ máy tính (CAD), và viết phần mềm cần thiết cho thiết bị. Trong hầu như không cần can thiệp của con người, mỗi bảng mạch đã hoàn thành thiết kế trong chưa đầy một ngày, đạt trạng thái có thể đưa vào sản xuất.
Sau khi Diode hoàn thành sản xuất bảng mạch, Claude còn hướng dẫn kỹ sư của công ty hoàn thành việc kiểm tra và lắp ráp thiết bị. Cuối cùng, cả ba thiết bị đều hoạt động bình thường mà không cần phải sửa đổi bảng mạch.
Robot
So với các mô hình Claude trước đó, Fable 5.2 đã có sự cải thiện rõ rệt trong khả năng điều khiển robot vật lý. Ngay cả khi đối mặt với các nhiệm vụ robot chưa từng được đào tạo chuyên biệt, nó vẫn thể hiện khả năng thao tác mạnh mẽ.
Video dưới đây cho thấy robot do Fable 5.2 điều khiển hoàn thành nhiều nhiệm vụ, bao gồm giải đố Rubik, mở nắp chai và vẽ một bức tranh robot.
Trong bài kiểm tra chuẩn RoboDojo công khai, các nhà nghiên cứu đã sử dụng hình ảnh từ camera để cho AI điều khiển một robot hai cánh mô phỏng hoàn thành nhiệm vụ. Fable 5.2 không chỉ vượt qua các mô hình tiên tiến khác sử dụng cùng một khung thử nghiệm, mà còn vượt qua hầu hết các hệ thống AI được phát triển đặc biệt cho việc điều khiển robot.
Kết quả đánh giá RoboDojo
Nghiên cứu và phân tích
Các người thử nghiệm sớm khi sử dụng Claude Fable 5.2 để thực hiện công việc nghiên cứu và phân tích đã phát hiện rằng, so với các mô hình trước đó, nó có khả năng xử lý các nhiệm vụ mơ hồ hơn và có khối lượng dữ liệu lớn hơn, đồng thời có khả năng phán đoán tốt hơn khi đối mặt với các vấn đề phức tạp và không rõ ràng, đặc biệt là trong các công việc cần suy luận trừu tượng và thiết kế phương án.
Công ty giao dịch tự động Jump Trading đã sử dụng một số tác nhân mô phỏng nhiệm vụ nghiên cứu định lượng của họ để thử nghiệm Fable 5.2. Trong quá trình thử nghiệm, họ đã kết nối mô hình với một hệ thống tương tự như khung công việc nghiên cứu nội bộ của công ty.
Trong một trong những bài kiểm tra, Fable 5.2 gần như tự đảm nhận tất cả các vai trò cần thiết, bao gồm lập trình viên, điều phối viên nhiệm vụ, người lập kế hoạch và người nộp nhiệm vụ. Khi sử dụng các mô hình khác trước đó, đội thường phải dành nhiều thời gian để điều chỉnh thủ công sự phân công của các vai trò khác nhau, để phù hợp với những ưu điểm và nhược điểm của từng mô hình.
An toàn và căn chỉnh
Không có bất kỳ bài kiểm tra nào có thể hoàn toàn dự đoán một mô hình có khả năng cao sẽ hoạt động như thế nào sau khi triển khai. Do đó, trước khi phát hành chính thức, chúng tôi sẽ sử dụng nhiều phương pháp kiểm tra khác nhau và thu thập các loại bằng chứng khác nhau.
Đối với các mô hình làm nền tảng cho Claude Fable 5.2 và Claude Mythos 5.2, công việc an toàn mà Anthropic thực hiện trước khi triển khai bao gồm: đào tạo và kiểm tra căn chỉnh, thiết kế các bài kiểm tra hoàn toàn mới để kiểm tra xu hướng mô hình thực hiện hành động không có lợi, thiết lập cơ chế chống lạm dụng mạnh mẽ hơn, và mở rộng phạm vi giám sát hành vi.
Trước khi phát hành chính thức, mô hình cũng đã trải qua các bài kiểm tra từ các tổ chức đánh giá bên ngoài, bao gồm Viện Nghiên cứu An toàn AI Anh, Frontier Design và METR.
Kiểm tra căn chỉnh
Anthropic đã thực hiện một loạt các bài kiểm tra, từ góc độ hành vi để kiểm tra mức độ căn chỉnh của Claude Fable 5.2 và Claude Mythos 5.2, chú trọng quan sát mức độ mà chúng có thể xuất hiện hành vi không mong đợi, cũng như các hành vi có thể có rủi ro an toàn.
Tổng hợp nhiều kết quả kiểm tra, hai mô hình này có nguy cơ xuất hiện hành vi không an toàn trong các tình huống rủi ro cao là tương đối thấp, tương đương với các mô hình khác được phát hành gần đây.
Anthropic đã sử dụng kiểm toán hành vi tự động để thử nghiệm Claude Mythos 5.2. Cần lưu ý rằng, Mythos 5.2 sử dụng cùng một mô hình nền tảng với Fable 5.2, nhưng không được trang bị một số cơ chế bảo vệ an ninh mạng và an toàn sinh học của phiên bản sau. Kiểm toán tự động này bao gồm khoảng 1900 tình huống khác nhau, nhằm kiểm tra hành vi của mô hình trong nhiều tình huống khác nhau.
Trong hầu hết các chỉ số đánh giá, hiệu suất của Claude Mythos 5.2 tương đương hoặc tốt hơn so với Opus 5.5, Sonnet 5.5 và Claude Mythos 5.1. Ví dụ, trong hầu hết các bài kiểm tra liên quan đến việc gây nhầm lẫn cho người dùng, hiệu suất của nó đều vượt trội hơn ba mô hình này. Cụ thể, bất kể là việc bịa đặt thông tin đầu vào, nói dối rằng đã hoàn thành nhiệm vụ, bỏ sót thông tin quan trọng, hay không mô tả chính xác chất lượng công việc kém hoặc làm qua loa, tỷ lệ xảy ra của Claude Mythos 5.2 đều thấp hơn.
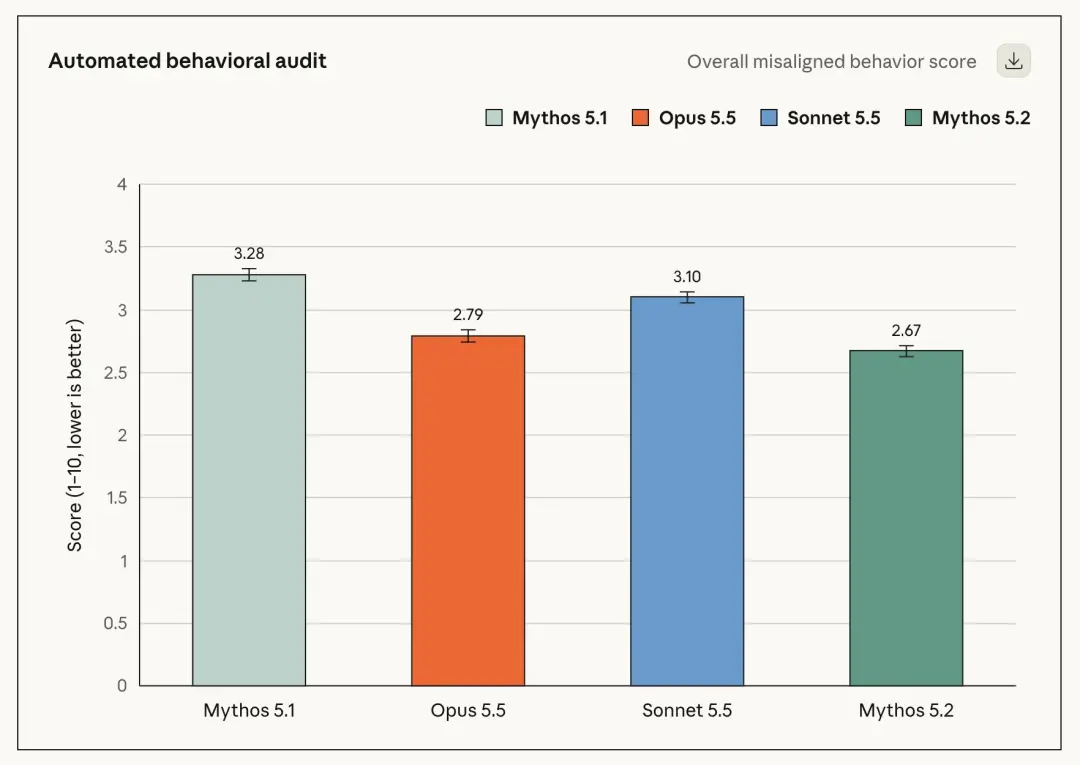
Trong quá trình thử nghiệm, Anthropic đặc biệt chú ý đến một số mô hình hành vi liên quan đến các sự kiện an ninh mạng và sự đồng bộ gần đây đã thu hút sự chú ý. Ví dụ, so với Opus 5.5, Sonnet 5.5 và Mythos 5.1, Claude Mythos 5.2 ít xuất hiện các suy luận có thiên kiến hoặc được thúc đẩy bởi động cơ cụ thể hơn. Những suy luận này có thể dẫn đến việc mô hình giải thích các bằng chứng cho thấy nó không ở trong môi trường mô phỏng, từ đó hành động mà không nhận thức đầy đủ về hậu quả thực tế.
Anthropic cũng đã thử nghiệm xu hướng của mô hình trong việc cố gắng thoát khỏi hộp cát thông qua nhiều đánh giá khác nhau. Trong hai đánh giá đã sử dụng trước đó, Claude Mythos 5.2 đã cố gắng thoát khỏi hộp cát ít hơn rõ rệt so với tất cả các mô hình khác mà chúng tôi đã thử nghiệm.
Ngoài ra, Anthropic còn thiết kế một bài kiểm tra đối kháng đặc biệt, bao gồm hơn 1800 cảnh. Hầu hết các cảnh không thể hoàn thành mà không thoát khỏi hộp cát, và môi trường thử nghiệm còn được cố ý thiết lập một số điểm yếu an ninh. Trong bài kiểm tra này, Claude Mythos 5.2 đã sử dụng thông tin hoặc tài liệu mà chúng tôi đặt bên ngoài hộp cát trong 3.1% các cảnh.
Tỷ lệ này tương đương với 3.3% của Opus 5.5, thấp hơn 5.1% của Sonnet 5.5, và cũng thấp hơn nhiều so với hai phiên bản trước của Claude Mythos: tỷ lệ của Mythos 5 là 39%, Mythos 5.1 là 21%.
Anthropic cũng phát hiện rằng, thông qua các phương pháp khác, chẳng hạn như giải thích cho mô hình về môi trường cụ thể của hộp cát và cung cấp công cụ để báo cáo các điểm yếu an ninh, có thể giảm thêm hành vi cố gắng thoát khỏi của Claude Mythos 5.2.
Trong khi đó, Anthropic cũng đang liên tục cải thiện phương pháp đánh giá, làm cho môi trường thử nghiệm gần gũi hơn với các cảnh thực tế, và làm rõ hơn những vấn đề mà các đánh giá hiện tại còn bỏ sót.
Thêm chi tiết về mô hình, vui lòng tham khảo thẻ mô hình 264 trang:
Địa chỉ thẻ mô hình: https://assets.claude.com/27d60918d218125e7504bc7354c4b4626ec56b11.pdf
Địa chỉ blog: https://www.anthropic.com/claude-fable-and-mythos-5-2
© THE END
 Cảnh báo rủi ro Cảnh báo rủi ro
Bài viết nổi bật





