ついに、DeepSeekが次世代エージェントハーネスの理念を発表しました。
 核心的な視点


 本文はエンジニアリング実践に向けたアーキテクチャの考察であり、DeepSeek Harnessの既存製品機能の紹介ではありません。
原文タイトル:Super-agent デザイン探索:より自律的なエージェントシステムへの道
原文著者:DeepSeek 製品部
1. Super-agent
過去一年間、Coding Agent を代表とする単一タスクエージェントは、モデルがツールを使用して複雑な問題を解決できることを証明し、人間の継続的な監視や段階的な介入がますます少なくなっています。一方で、モデルのマルチエージェント協調能力も向上しており、クロスセッションの組織とスケジューリングが可能になっています。人間の底層実行への関与が減少するにつれて、人間の役割はより高次の意思決定と受け入れに移行しています。
モデル能力のこの向上は、新しいアプリケーション形態を生み出しました。最近、個人アシスタント(Personal Agent)が集中して現れ始め、日常のメッセージ、スケジュール、メール、作業プラットフォームに直接接続し、情報フローを継続的に観察し、業務を処理するのを支援します。このような継続的オンライン、イベント駆動の作業モデルは、個人シーンに限定されず、個人アシスタントはその一つのアプリケーションに過ぎません。ソフトウェア開発などのビジネスシーンでも同様に価値があります。
しかし、既存の主流エージェントデザインは、マルチタスクとチーム協力の規模でこのモデルを支えることが難しいです。エージェントの作業モデルは依然として単一セッションを基本単位としており、異なるセッションは互いに独立しています。ユーザーが複数の作業を並行して進めるとき、手動で切り替え、各セッションのコンテキストを記憶する必要があります。私たちの観察によれば、一人の人間は通常、同時に3から5のアクティブセッションを追跡することができます。このようなデザインでは、単一タスクの上限はモデル能力に依存し、マルチタスクの上限は人間の注意力に依存します。
既存のローカル単一セッションエージェントでCLI、MCP、または外部コネクタを利用して簡単に拡張するだけでは、エージェントは外部メッセージに接続できるものの、単一セッションの同期ブロック、マルチタスクのコンテキスト混乱、ローカルデバイスがオフラインになると停止するなどの問題に制約され、大量の手動メンテナンスが必要です。
これらの制限を突破するには、エージェントと単一手動セッションのバインディングを打破し、セッションを超えてコンテキストを保持し、同時に複数の複雑なタスクを進め、互いに干渉しない連続的な実体にする必要があります。このようなエージェントの形態とそのシステムアーキテクチャを私たちはSuper-agentと呼んでいます。
例えば、私たちの内部でDeepSeek Harnessを基に運用されているSuper-agentインスタンスでは、同じ開発タスクがIMとGitHubの間で連続的に進行できます。このインスタンスは、公共のグループチャットでのフィードバックを継続的に観察し、誰も@しない場合に根本原因を特定し、修正プルリクエストを提出します:
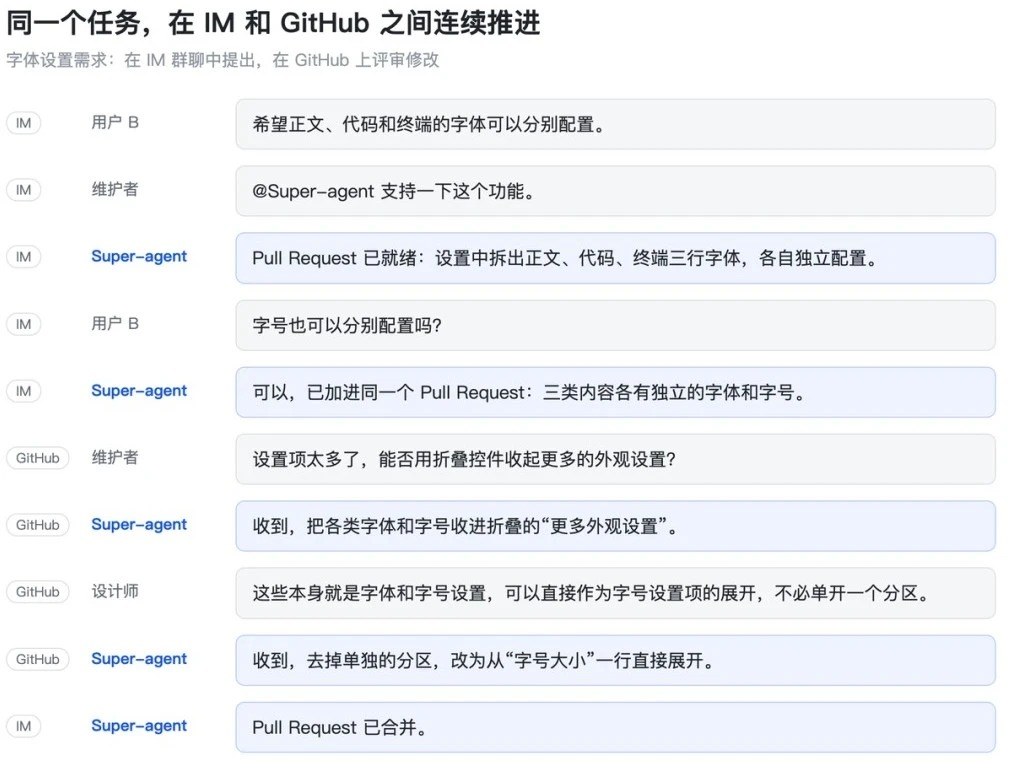
同じタスクがIMグループチャットとGitHubプルリクエストレビューの間で連続的に進行
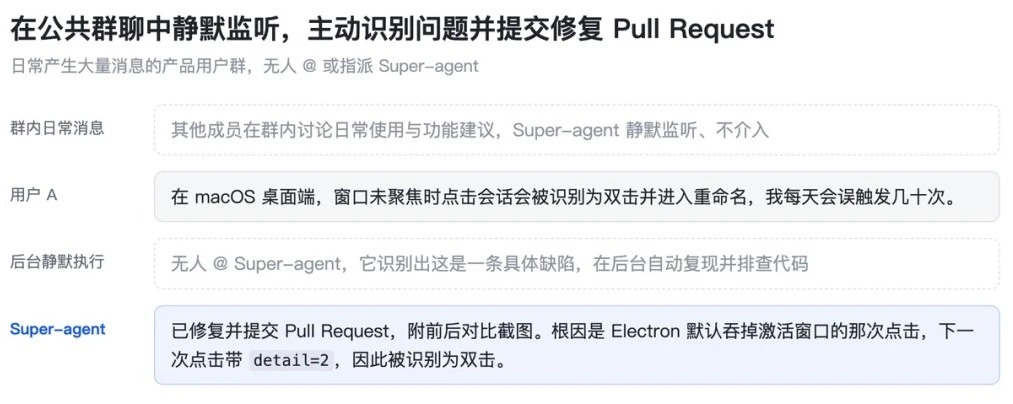
公共のグループチャットを継続的に監視し、誰も@しない場合に欠陥を特定し、修正プルリクエストを提出
具体的には、私たちはSuper-agentが以下の4つの基本的な特徴を備えていると考えています:
連続性:ユーザーはIMチャット、GitHubコメントなどの馴染みのある作業インターフェースで直接やり取りでき、常に1つのエージェントが存在するように感じ、「セッションXのコンテキストにY情報があるかどうか」を考える必要がありません。例えば、ユーザーがIMで方案Aを提案し、その後GitHubプルリクエストのコメントで方案Bに変更した場合、エージェントは理解し、実行方向を調整できます。
効率性:インタラクションの応答が迅速で、同時に複数の複雑なタスクを並行して高品質に完了できます。前のコマンドやタスクが完了するのを待つことなく、次の指示を受け入れることができます。
主動性:ユーザーが逐次指示を出すのを待つ必要がなく、環境のイベントを継続的に観察し、処理すべき事項を自発的に進め、介入が必要ない時は静かにしています。
持続性:常にオンラインで、ユーザーの実際の作業環境に直接接続し、長期間の運用中に異常が発生した場合は自動的に回復します。
単一のReActループでは、上記の4つの特徴を同時にサポートすることはできず、基盤にはそれに対応するアーキテクチャが必要です。類似の設計制約は類似のアーキテクチャ選択を導きます。私たちは、個人向けのアシスタントであれ、ソフトウェア開発などのビジネスシーン向けのエージェントであれ、持続的にオンラインで、環境イベントに並行して応答するシステムを構築することが目標であれば、基盤では近いアーキテクチャが採用される可能性が高いと考えています。また、このプロセスで直面する多くの問題は、従来のコンピュータシステムで長年議論されてきた問題と非常に高い類似性を持っているため、コンピュータシステムにおける多くの古典的な設計思想もここで適用可能です。
具体的な実装において、このアーキテクチャにはさまざまな変種がありますが、私たちは以下の5つのモジュールが上記の4つの基本的な特徴を支える基本フレームワークを構成していると考えています:二層アーキテクチャ(第2節)を通じて連続的なインタラクションと効率的な並行処理を両立し、イベント駆動(第3節)を通じて自発的な応答を実現し、人間に焦点を当てたインタラクション(第4節)を通じてインタラクションプロセスで連続性と効率性を同時に実現し、計算、状態、環境の分離(第5節)およびWatchdog(第6節)を通じてデバイスを超えた持続的な接続と異常自動回復を実現します。
下の図はSuper-agentの全体システムアーキテクチャを示しており、図中の各モジュールの番号[2]から[6]はそれぞれ下文の第2節から第6節に対応しています:
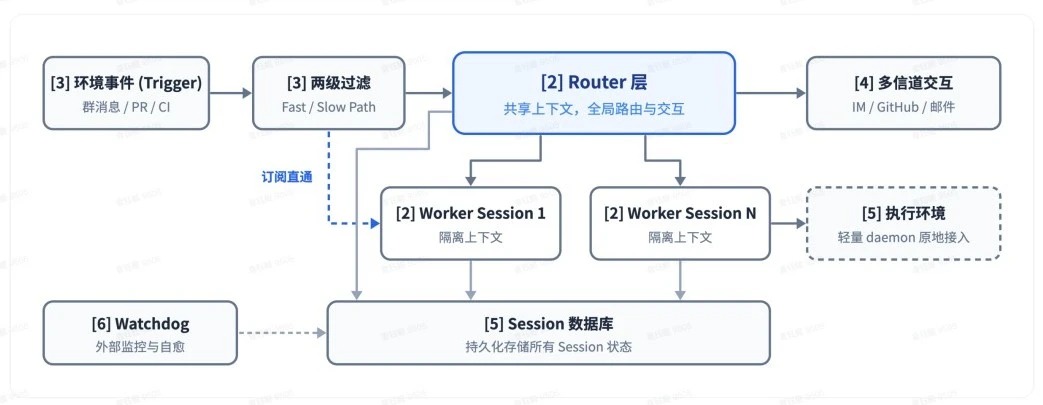
Super-agent全体システムアーキテクチャ、番号[2]から[6]は下文の第2節から第6節に対応
2. 二層アーキテクチャ
クロスチャネルの連続的なインタラクションとマルチタスクの効率的な並行処理を同時に実現するために、システムは底層のセッション組織において連続性とスループットの間の根本的なトレードオフに直面します。
もしすべてのイベントを同じセッションで処理する場合、コンテキストは最も連続的ですが、単一のReActループの直列実行の速度制限に制約され、タスクの完了に時間がかかり、スループットが低くなり、マルチタスクの中間詳細が混在することで完了効果にも影響を与えます。
逆に、すべてのイベントを直接新しい独立したセッションで処理する場合、並行スループットは最高ですが、タスク間が完全に独立していない場合、全体のコンテキストが欠けることで各セッションの結果が互いに切り離され、複数のセッションがそれぞれユーザーに応答することでインタラクションが混乱する可能性があります。
連続性とスループットを両立させるために、「グローバルな連続性の維持」と「高並行実行」を2つの異なるレベルに分けることができます:常駐のルーターレイヤー(2.1節)が人間のインタラクションとグローバルな調整を統一的に受け持ち、コンテキストを隔離したワーカーレイヤー(2.2節)が具体的なタスクを並行して実行します。以下の図に示されています:
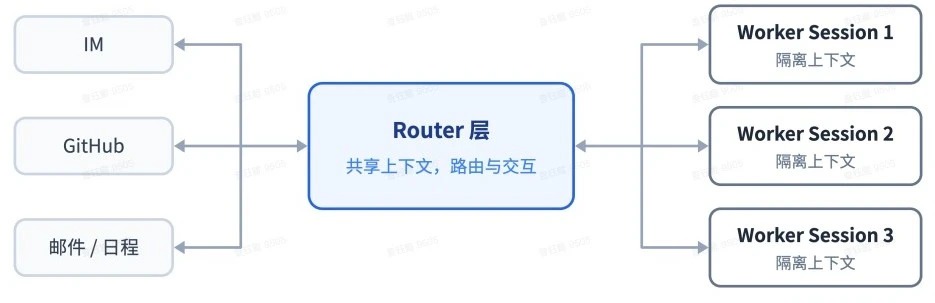
二層アーキテクチャ:ルーターレイヤーがルーティングと対外インタラクションを統一的に担当し、複数のワーカーセッションが隔離されてタスクを並行実行
この二層アーキテクチャにより、システムは底層でコンテキスト管理と並行実行を引き受け、ユーザー側ではセッションの存在を薄め、ユーザーが常に同じSuper-agentに向き合うことができます。この観点から見ると、ユーザーに手動でセッションを管理させることは、かなりの程度で底層のLLM APIから引き継がれた設計の慣性です。セッションはシステムの実装の詳細であり、ユーザーの認知負担であってはなりません。
既存のデザインでは、セッションは技術的なコンテキスト管理とユーザー向けのプロジェクト管理の両方を担っています。製品形態と底層セッションをデカップリングすると、ユーザー向けのプロジェクト管理はもはやセッションの制約を受けず、ユーザーにどのようなインタラクションとタスク管理の方法を提示するかが独立した製品の問題となります。この問題については後述します。
ここでの「二層」は論理的な責任の分担であり、各層は実装上単一のセッションに制限される必要はなく、それぞれの内部構造を持つことができます。以下では、ルーターレイヤーとワーカーレイヤーのデザインについてそれぞれ紹介します。
2.1 ルーターレイヤー
ルーターレイヤーは常駐のグローバルルーティングレイヤーであり、すべての入口の人間のインタラクションを受け持ちます。すべてのタスク間の情報と意思決定はルーターレイヤーで集約され、グローバルなシーケンスポイント、調整ポイント、記憶として機能します。このグローバルノードがシステムの性能ボトルネックにならないように、ルーターレイヤーは設計上具体的なタスクを直接実行せず、人間のインタラクションとタスクの割り当てのみを担当し、Bashツールを装備しないことも可能です。
このように1つの中心ノードが複数の実行ノードを割り当てる構造は、一見すると一般的なエージェントチームに似ていますが、両者の重点は異なります。一般的なエージェントチームは、単一の複雑なタスク内部のステップの分解と役割の協力に主に使用されます。サブステップは通常密に結合されているため、チームリーダーはタスクの詳細を深く理解し、サブタスクを計画し、各メンバーを高頻度で調整する必要があり、自身が重い推論負荷を担います。一方、Super-agentでは、ルーターレイヤーはタスク間の高レベルの関連性と割り当てのみを処理し、単一タスク内部の分解には介入しません。逆に、エージェントチームの主セッションが具体的なタスクを実行せず、対外インタラクションのみを担当し、異なるタスクを各メンバーに独立して進めさせる場合、それもこの二層アーキテクチャと見なすことができます。私たちの実践から見ると、ルーターレイヤーのタスクは想像以上に複雑ではなく、比較的軽量なモデルを使用することで速度と効果を両立できることが多いです。
内部実装においても、ルーターレイヤーは単一のセッションに制限される必要はなく、一部のロジックはLLMを呼び出す必要がない場合もあります。私たちは、最も直接的な単一常駐LLMセッションをルーターレイヤーのコア実装として選択し、それが表面上見えるほどスループットのボトルネックになりにくいことを発見しました。なぜなら、前の推論期間中に到達した環境イベント(つまり第3節のトリガー)は蓄積され、次のラウンドで一緒に処理され、バッチ処理を形成し、合併処理の追加コストは非常に小さいからです:
外部イベントフローが安定している場合、トリガーは1つずつルーターレイヤーに入ります。この時、単一の応答遅延は低くなります;
イベントが集中してRouter Sessionが混雑し始めると、前の推論期間中に蓄積された複数のTriggerが自動的に統合され、次回のLLM呼び出しで一緒に注入されます。Router Sessionは軽量なインタラクションと配信を行い、各ステップは通常、長い入力と短い出力です。蓄積された複数のTriggerを一度のLLM API呼び出しに統合することで、Prefill段階で並行計算が行われ、単一リクエストの処理時間の増加はバッチサイズの増加よりも遅くなります。したがって、一定の範囲内では、蓄積が多いほど、単一の決定にかかる推論時間は低くなります。上限はコンテキストの長さと、モデルが一回の推論で正確に処理できるTriggerの数に依存します。
私たちは7.2節でこのバッチ処理メカニズムの効果を実験的に定量的に示します。さらに、後述するサブスクリプションとダイレクトパスメカニズム、チェーンリコール(3.2、3.3節参照)を加えることで、単一の常駐Router Sessionはコンテキストの連続性を保ちながら、現在のチーム規模で十分に機能します。
規模がさらに拡大し、単一のセッションが実際に対応できなくなった場合、Router層内部は多層フィルタ構造として設計することも可能であり、または水平にシャーディングして複数のセッションに分割することもできます。この場合、Router層の内部設計は本質的に連続性とスループットのトレードオフとなります。分割の粒度が細かくなるほど、Router層の同時スループットは高くなりますが、シャード間の記憶とコンテキストの連続性は低くなります。グローバルメモリの問題が解決されるまで、このトレードオフは常に存在します。
2.2 ワーカー層
ワーカー層は具体的な実行を担当するセッションで構成され、各ワーカーはコンテキストが隔離されており、完全な実行ツールをマウントし、独立したコンテキスト内で単一のタスクに集中して完了します。ワーカーセッションはタスクの結果とコードの品質を直接決定するため、通常は最も能力の高いモデルを設定する必要があります。
ワーカーは人間と直接対話することはなく、その推論プロセスやツール呼び出しは外部チャネルに直接出力されることはなく、Router層に状態を報告し、Router層が統一してユーザーに返信します。これにより、同時実行度と納品品質を保証しつつ、複数のセッションがそれぞれ返信することによる混乱を避けることができます。
複数のタスクを同時に実行する際、各ワーカーは独立してタスクを進め、同じ層のワーカー間で直接通信する必要は通常ありません。複数のワーカーが具体的な実行中に衝突するのは、同じPull Requestなどの共有作業環境で発生することが多いです。彼らがそれぞれ対応するスレッドを購読している限り、同じイベント通知を受け取り(3.2節参照)、衝突を自ら発見し解決する機会があります。少数のタスク間の協調はRouter層を介して行われます。
Router層と同様に、各ワーカーセッションも内部で単一のセッションに制限される必要はありません。複雑な単一タスクを実行する際、ワーカー内部でサブエージェントを作成することもでき、または自体がエージェントチームであることも可能です。これらは上層のRouter層に対して透明性を保ちます。この構造はコード協力シナリオ(複数の独立した問題の再現、Pull Requestのレビュー、機能開発を同時に進めて互いにブロックしない)にも適しており、個人アシスタントシナリオにも適しています。個人アシスタントは通常、インターフェース上で単一のセッションのチャットページを提供しますが、ユーザーが同じ対話ボックスで複数の異なるトピックを同時に議論している場合、フロントエンドの単一のチャットページがインタラクションの連続性を維持し、バックエンドは各トピックに対してワーカーを割り当て、タスクを並行して進め、返信を草案します。
3. イベント駆動
Super-agentに主体性を持たせるためには、まずシステムの駆動方式を変更する必要があります。エージェントを駆動する主な入力は、人間がセッション内で逐次入力するプロンプトではなく、環境内の半構造化イベントです。Super-agentでは、グループチャットメッセージ、メール、スケジュールリマインダー、コードレビューコメント、CI実行結果などの環境イベントはTriggerと呼ばれます。Triggerを監視し応答することで、エージェントはもはや単一セッションモードのように、人間が指示を出すのを待って受動的に一度実行する必要はありません。
環境イベントが入ってから処理されるライフサイクルに関して、以下の4つの進行する問題について順次議論します:大量のノイズをプログラムとモデルの組み合わせによる二段階戦略でフィルタリングする方法(3.1節)、サブスクリプションとダイレクトパスメカニズムを通じてイベントをワーカーにルーティングする方法(3.2節)、Inline & Spillおよびチェーンリコールを利用してモデルに高密度でコンテキストを注入し、必要に応じてリコールする方法(3.3節)、環境信号に基づいてバックグラウンドで事前に行動するために投機的実行を利用する方法(3.4節)。
3.1 イベントフィルタリング
実際のグループチャットとコードプラットフォームに接続すると、環境イベントの流れは顕著な「高ノイズ、低トリガー率」の特徴を示します。ほとんどの通常のメッセージはエージェントの介入を必要としません。各イベントに対して大モデルを呼び出して最初から判断する場合、遅延と計算コストは耐え難いものになります。コンピュータシステムのFast Path / Slow Pathの考え方を借りると、大モデルの推論は柔軟だが高コストのSlow Pathと見なすことができ、すでに明確で安定した高頻度の判断を決定論的なコードとして固定することは、低遅延、低コストのFast Pathを構成します。
したがって、イベントがシステムに入った後の最初のステップはフィルタリングであり、目標は大モデルを呼び出す前に決定論的な戦略を使用してノイズを除外し、意味理解が必要な候補イベントのみをモデルに判断させることです。私たちはプログラム戦略と大モデルを組み合わせた二段階フィルタリングメカニズムを採用します:
プログラム層戦略(Fast Pathとして):イベントの発生源、グループ範囲、ユーザーまたはボットのホワイトリストなどの決定論的条件に基づいて、コードを通じて迅速なアクセスチェックを行います。たとえば、異なる発生源に対して「明確なリクエストにのみ応答」、「候補イベントとして」、「直接無視」などを設定し、モデルを呼び出す前にほとんどの無関係なメッセージをフィルタリングします。
意味層戦略(Slow Pathとして):プログラム層でアクセスが許可された候補イベントをLLMに渡し、提示詞で書かれた戦略とコンテキストに基づいて行動が必要かどうかを判断します。意味層は同時に人間向けの自然言語拡張ポイントとして機能し、いつでも提示詞のスイッチや新しい戦略を追加できるようにします。以下の図に示すように:
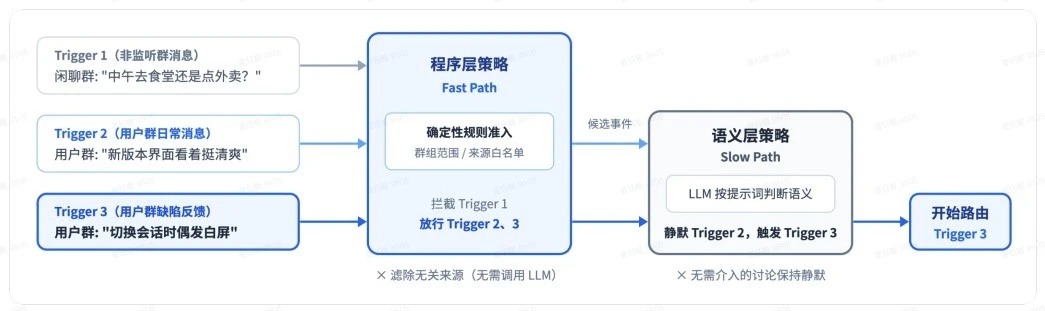
二段階フィルタリング:まずプログラム層戦略でほとんどの無関係なメッセージを除外し、次に意味層戦略で判断します。
3.2 イベントルーティング
第2節で導入されたグローバルRouter層は、クロスチャネルの連続性を維持する役割を果たしますが、割り当てられたタスクの各後続イベントが依然としてRouter層を経由して転送される必要がある場合、このグローバルノードは依然として大量の負荷を受け、システムの応答遅延を高めます。したがって、Fast / Slow Pathはフィルタリングされたイベントルーティングにも適用されます。グローバルRouter層は新しいタスクのコールドスタートとタスク間の調整のみを担当し、すでに帰属関係が確定している後続イベントはプログラムが直接対応するワーカーセッションに送信され、Router層を経由する必要はありません。
実際のワークフローでは、同じGitHub Pull Request、同じIMトピック、または同じ往復メールの連続イベントが一つのイベントフロー、すなわちスレッドを構成します:
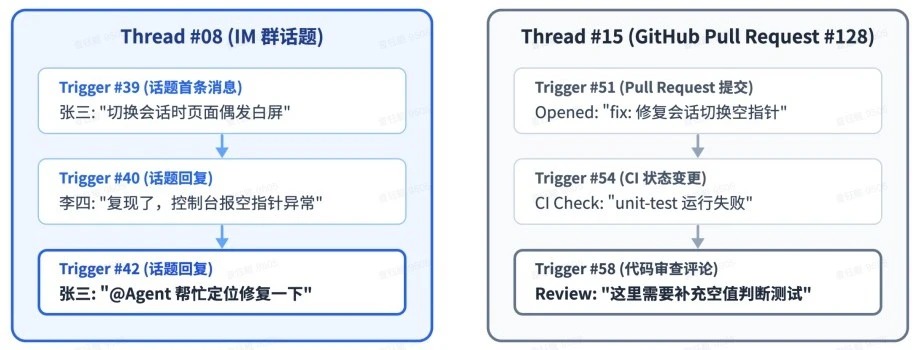
スレッドの例:同じIMトピックまたは同じGitHub Pull Requestの下の連続Triggerが一つのスレッドを構成します。
Router層が特定のスレッドの初期イベントに基づいてワーカーセッションを作成した後、そのワーカーは対応するスレッドを直接購読し、イベントルーティングを以下の図に示す二つのパスに分けます:
購読済み(Fast Path):同一スレッドの後続イベントはプログラムが購読済みのワーカーに直接送信され、Router層が再度ツールを呼び出して転送する必要はありません。新しいイベントが現在のタスクの範囲を超えた場合、ワーカーは購読をキャンセルするか、Router層に返して再配分することもできます。
未購読(Slow Path):Router層はすべてのイベントを観測してグローバル状態を把握できますが、まだ購読されていない新しいイベントの判断と配分のみを担当します。
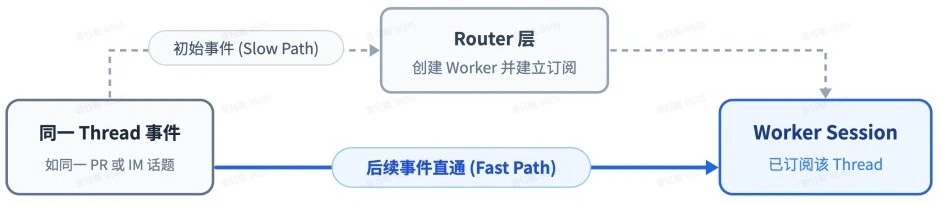
サブスクリプションとダイレクトパス:初期イベントがRouter層を経由してワーカーを作成し、サブスクリプションを確立し、同一スレッドの後続イベントがそのワーカーに直接送信されます。
さらに、スレッドとワーカー間のサブスクリプションは多対多の関係です。1つのワーカーは同時に複数の関連スレッドを購読でき、同じスレッドも複数のワーカーによって購読されることがあります。複数のワーカーが同じ作業環境や議論の中で交差する場合、そのスレッドの新しいイベントはすべての購読ワーカーに同時に直接送信され、彼らはピアツーピア通信を必要とせず、お互いの操作を知る機会があり、衝突を自ら解決することができます。出力側では、ワーカーは依然として重要な結論をRouter層に報告し、Router層が統一してユーザーに返信し、グローバルメモリを同期します。
3.3 コンテキストの組織
イベントがフィルタリングとルーティングを経て、ターゲットセッションに入った後、次の問題はモデルのコンテキストウィンドウにどれだけの情報を注入すべきかです。システム入力が限られた人間のプロンプトから環境が持続的に生成する半構造化イベントに移行したため、ツール呼び出しとイベント注入の構造設計がより重要になりました。情報を注入しすぎるとウィンドウを圧迫し、モデルの注意を希薄化し、注入が少なすぎるとモデルがツールを繰り返し呼び出して読み取ることを強いられ、実行ステップが増加します。コンテキストウィンドウを無駄にすることは、モデルの知能を無駄にすることになります。
そのため、限られたコンテキストウィンドウをキャッシュとして管理することができます。コンパイラ最適化とコンピュータシステムの概念を借りて、コンテキスト注入の設計は二つの基本操作に要約できます。Inlineは、最近使用される可能性が高い情報を現在のコンテキストウィンドウに直接インライン化して、追加のツール呼び出しの往復を省くことを指します。Spillは、ウィンドウの予算を超えた情報や低頻度で使用される完全な情報をコンテキストウィンドウの外に留め、ウィンドウ内には参照や要約のみを保持し、モデルが必要に応じて読み取ることを指します。
コンピュータシステム設計における古典的な局所性(Locality)の考え方を組み合わせることで、Inline & Spillを用いてイベント注入とツール呼び出しを段階的に最適化できます:
最小限の情報から始める:最初は現在のオブジェクトのIDと内容の要約のみを提供します。
局所性を利用して関連情報を段階的にInline化する:最近使用される可能性が高い情報をコンテキストにInlineし、まず密接に関連するオブジェクトのIDを添付し、次に時空的に隣接する内容を添付します。たとえば、内容の前50文字、IMメッセージの前後の隣接メッセージや返信されたメッセージ、またはコードコメントが所在するレビュー討論の隣接コメントなどです。
上限を超えると Spill:すべてをインラインにできない長いコンテンツに対して、より小さな長さの上限を設定し、超過部分をウィンドウの外にスピルします。シンプルで直接的な方法は、超過部分を切り捨てて続きの読み取り入口を保持し、モデルが完全なコンテンツを必要とする際にツールを呼び出して読み取ることです。
さらに、大量の後続イベントがワーカーに直接通過し、システムが長期間の運用で多くの歴史的タスクを蓄積した場合、ルーター層はすべてのタスクの全履歴を自分のコンテキストウィンドウに入れることができず、ユーザーが異なるチャネルで特定の古いタスクを持ち出したときにコンテキストを取り戻す必要があります。インラインとスピルをシステム内のさまざまなオブジェクトに一貫して適用することで、必要に応じて展開される多段階検索メカニズム、すなわちチェーンリコール(Chain of Recall)が得られます。このチェーンリコールプロセスは、ルーター層が長期的に以前の情報を失う問題を緩和します。以下の図に示すように:
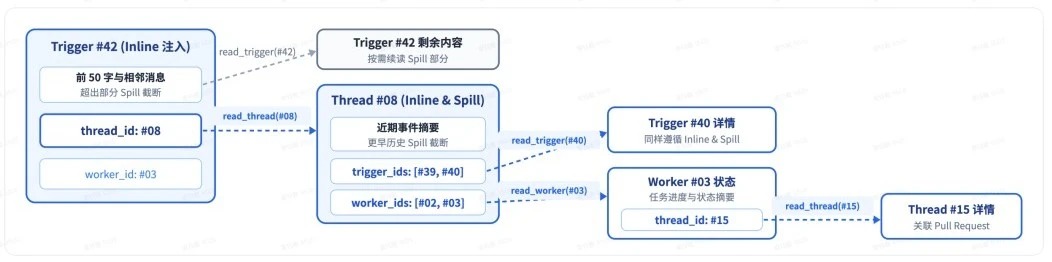
チェーンリコール:各回のリコール対象は、次のジャンプ関連オブジェクトのIDをインラインで持ち、参照関係に沿って逐次的にコンテキストを展開することをサポートします。
具体的には、システムはトリガー、スレッド、ワーカーセッションなどのオブジェクトに一意のIDを付与し、注入時に密接に関連するオブジェクトのIDをインラインで持たせ、これらのオブジェクトが基盤で参照グラフを構成します。ツールを呼び出してリコールするオブジェクト自体もインラインとスピルに従うため、その返結果には次のジャンプ関連オブジェクトの要約とIDがインラインで含まれ、モデルは現在のイベントから出発し、参照関係に沿って逐次的にコンテキストを必要に応じてリコールできます。
例えば、現在のメッセージからそのスレッドを読み取り、スレッドにインラインされたIDを追跡して関連するワーカーセッションを見つけ、さらにそのワーカーに関連する別のコードレビューのスレッドを見つけることができます。
3.4 事前行動
コンピュータシステムの投機的実行(Speculative Execution)の考え方を借りて、エージェントは結果が採用されるかどうかが不確定な場合でも、環境信号に基づいてバックグラウンドで事前に試みることができます。追加のバックグラウンド計算リソースを消費することで、人間の待機と介入コストを削減します。結果が価値あるものであれば納品し、価値がなければ破棄します。
個人アシスタントのシナリオでは、会議の招待メールやタスクメッセージを受け取った際に、エージェントはまずバックグラウンドでスケジュールの衝突を確認し、関連する背景資料を収集し、返信の草稿を準備します。ユーザーが確認した後、すぐに確認して送信できます。研究開発の協力シナリオでも同様です。例えば、私たちは会社のDeepSeek Harness内部ユーザーグループに「静かな再現と修正」戦略を設定しました。グループ内で誰かが問題を報告したり、変更案を議論したりする際、エージェントはまずバックグラウンドで再現を試み、修正案を探します。問題を確認し、簡単な修正案を見つけた場合のみ、結果をユーザーに提供し、それ以外は全過程で静かに保ちます。
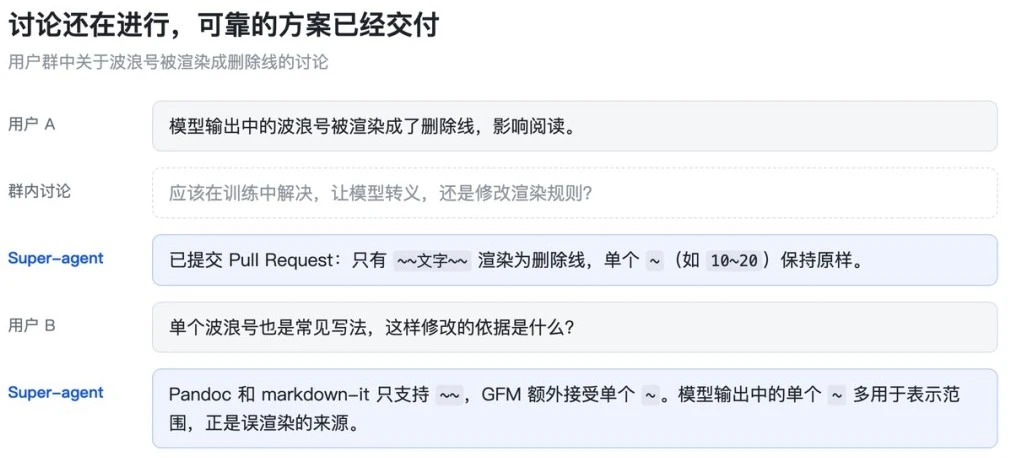
投機的実行の例:グループ内で解決策を議論している間に、スーパーエージェントはバックグラウンドで修正プルリクエストを提出しました。
4. 人に向けたインタラクション
第2節の二層アーキテクチャは、コンテキストの観点からチャネル間の連続性を保証しますが、実際の人間と機械のインタラクション体験において連続性と効率を同時に実現するためには、インタラクションの方法とインタラクションチャネルに関して2つの問題を解決する必要があります。1つは、非同期ReActループを通じてバックグラウンドの時間のかかる操作が前景の対話をブロックしないようにし、セッションが前のコマンドやタスクの完了を待つことなくいつでも新しい指示を受け入れられるようにすること(4.1節)。もう1つは、インタラクションがユーザーに馴染みのある異なる作業チャネルで発生する場合、システムの出力方法が対応するチャネルの帯域幅と人の使用習慣に一致するようにすることです(4.2節)。
4.1 フルデュプレックスインタラクション
クラシックなReActループでは、モデルが同期のrun()ツール呼び出しを開始すると、ループはブロックされ、ツールが完了して最終結果を返すまで、セッションは新しいユーザー入力に応答できません。このブロックを解消するには、対話を一問一答の半二重モードからフルデュプレックスモードに変える必要があります。以下の図に示すように:
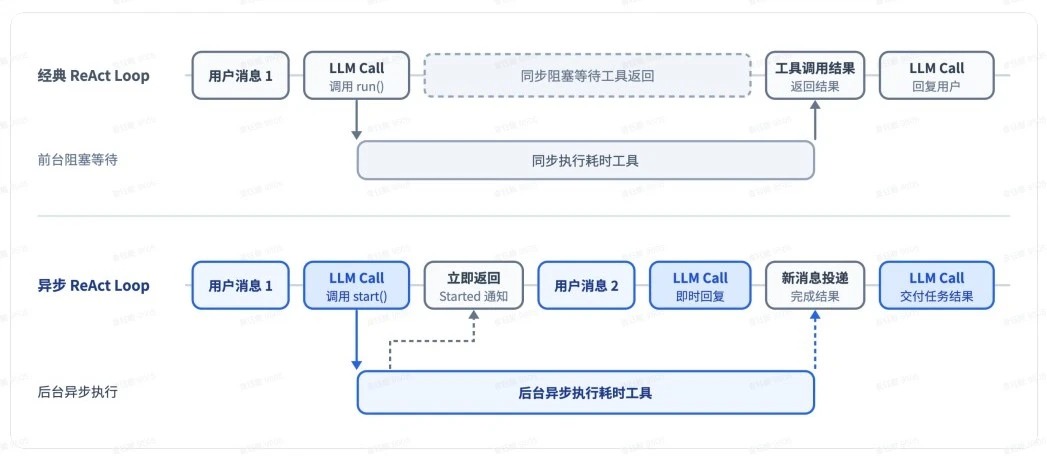
クラシックReActループと非同期ReActループの比較:非同期呼び出しはすぐに「開始(Started)」通知を返し、バックグラウンドツールの実行中でも新しいメッセージに応答できます。
そのため、時間のかかるコマンドとサブタスクのツール呼び出しを非同期のstart()とstop()に変更し、非同期ReActループを構成します。モデルがstart()を呼び出すとすぐに「開始済み(Started)」の返答を受け取り、ループはそのツールを待たなくなります。バックグラウンドツールが実行を完了した後、システムは最終結果を新しいイベントメッセージとしてセッションに配信します。同時に、モデルはコンテキストに基づいてstop()を呼び出し、実行時間が長すぎるバックグラウンドコマンドを積極的に終了させることもできます。
これにより、前景の対話応答とバックグラウンドタスクの実行が分離され、エージェントはバックグラウンドで時間のかかるタスクを実行しながらも人間の入力に応答できます。新しい入力は現在の推論ステップが終了した後に処理され、バックグラウンドツールの完了を待つ必要はありません。
この非同期タスクメカニズムはDeepSeek Harnessで実装されていますが、まだデフォルトでは有効になっていません。
4.2 マルチチャネルインタラクション
異なる作業チャネルは異なる情報密度とインタラクション習慣を持っており、システムの出力はそれに合わせる必要があります。個人端末向けのインタラクション方式をそのままグループチャットに持ち込むと、冗長な推論プロセスや密集したツール呼び出しをそのまま出力することで、複数人の協力において情報過負荷を引き起こす可能性があります。
スーパーエージェントでは、二層アーキテクチャがその一部の問題を解決しています。具体的なタスクにおける冗長な推論プロセスや密集したツール呼び出しはワーカーセッション内部に隔離され、外部チャネルに直接出力されることはなく、ルーター層が対外的なインタラクションを一元的に担当します。この基盤の上に、システムはユーザーの日常的に使用するさまざまな作業環境に接続し、プロンプトを通じて異なるチャネルに対してインタラクション規範をカスタマイズする必要があります:
IMなどの即時通信チャネル:低い干渉の軽量コミュニケーションを重視し、人間の同僚のように意思決定や受け入れが必要なときだけ通知を送信し、直接的な質問をし、短い結論を提供します。私たちが検証したシンプルで効果的な厳格な規定は、一度の返信が100語を超えないことです。
GitHub、メール、文書などの非同期チャネル:構造化された高情報密度の非同期配信を重視します。例えば、プルリクエストを作成または更新する際に、プロジェクトの規範に従って完全な問題の背景、変更の説明、検証結果を記述したり、個人アシスタントのシナリオでは構造化されたメールや文書の要約を直接起草したりします。
5. 計算、状態、環境の分離
既存のローカルエージェントは、エージェントループを推進する計算、永続的に保存する必要のあるセッション状態、コードリポジトリやローカルツールチェーンなどの実行環境を同じデバイスにバインドしています。一度デバイスがスリープ状態になったりオフラインになると、エージェントは実行を停止し、他のデバイス上の環境にアクセスできなくなります。スーパーエージェントが常時接続され、さまざまな実際の作業環境に柔軟に接続できるようにするために、コンピュータシステムの計算とストレージの分離(Compute-Storage Separation)の考え方を借りて、これら三者のバインディングを二段階で解消します。第一段階では、エージェントループを推進する計算と永続化されたセッション状態を分離し、エージェントが単一の機器のライフサイクル制限から解放され、クラウド上で常時接続されることを実現します(5.1節)。第二段階では、クラウド上のエージェントループと重状態の実行環境を分離し、実際の作業環境をその場に留め、デバイス間のアクセスをサポートします(5.2節)。
5.1 計算と状態の分離
エージェントループを推進する計算は無状態にすることができ、永続的に保存する必要があるのはセッション状態です。したがって、第一層の解耦は、エージェントループを推進する計算をクラウド上の無状態の弾力的計算コンテナに配置し、セッションなどの永続化された状態をデータベースに保存することです。無状態の計算コンテナは水平にスケールし、再起動または置き換えが可能であり、セッションとタスクの連続性は永続化ストレージによって保証されるため、エージェントは単一のローカルデバイスのライフサイクル制限から解放され、クラウド上で常時接続されます。
5.2 計算と実行環境の分離
エージェントループとセッション状態が常駐するクラウド上にある場合、次の問題はタスクに必要な実行環境にアクセスする方法です。モデルの作業に必要なコンテキストの大部分は、ツール呼び出しを通じてコードリポジトリ、ローカルファイル、依存サービスなどの実行環境から取得されます。この意味で、広義のコンテキストには実行環境自体も含まれます。
この問題に関する一般的なアプローチは2つあります。1つは、クラウド上でサンドボックスを起動し、コードを引き出して環境を再構築し同期を試みることですが、実際の作業環境には未提出のローカル変更、プライベートな資格情報、内部ネットワークサービスの依存関係、特定のハードウェアやツールチェーンが含まれることが多いため、技術的にこのような環境を同期することは非常にコストが高く、情報の欠落が発生しやすいです。もう1つは、ユーザーにローカル環境を放棄し、クラウドで作業するように要求することですが、多くのユーザーにとって移行コストが高すぎます。
環境自体を複製し同期することが難しいので、実行環境をエージェントループと共にクラウドに持ち上げる必要はありません。第二層の解耦は、エージェントループをクラウド上で実行し、重状態の実行環境をその場に留め、端側にはセッション状態を保存しない軽量デーモンを展開します。このデーモンはコマンドを実行し結果を返すだけの役割を果たし、実行環境をクラウドの外に留め、エージェントが必要に応じてその中のコンテキストを読み取ることを可能にします。
この考え方は、Anthropicが提案した「脳と手の分離」(Decoupling the brain from the hands)と一致しており、ハーネスを無状態に保ち、セッションログをハーネスの外に保存し、統一インターフェースを通じて実行環境に必要に応じて接続します。両者の違いはシナリオにあります。その記事はホスティングサービスを説明しており、主にオンデマンドで作成されるサンドボックスと顧客のVPC内のリソースについて議論しています。ここで最初に接続する必要があるのは、ユーザーの日常的に使用する、間欠的にオンラインの個人マシンであり、未提出の変更やローカルの資格情報が含まれています。したがって、この設計はBYOM(Bring Your Own Machine)をサポートし、ユーザーの日常的に使用する開発機や個人コンピュータをクラウドエージェントに接続することを可能にし、クラウド上のホスティングマシンやオンデマンドで作成された計算環境にも接続をサポートします。
これにより、エージェントは単一のマシンに制限されず、異なる実行デバイス間で切り替え、タスクの必要に応じて環境を選択してコマンドを実行し、環境内のコンテキストを取得できます。ユーザーの特定の個人デバイスが再びオンラインになった後、クラウドエージェントが自動的にトリガーし、そのデバイス上で実行する必要のあるタスクを完了することも可能です。以下の図は、計算、永続化状態、およびさまざまな実行環境が二層で解耦された後の構造を示しています:
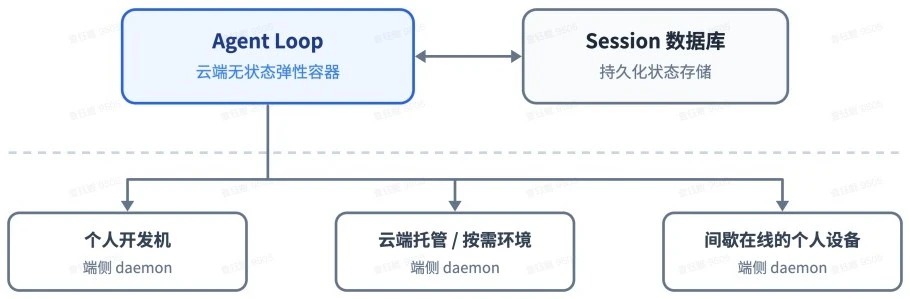
計算とストレージの分離と実行環境のデカップリング:エージェントループと永続状態がクラウドで分離され、エッジ側のデーモンを通じて必要に応じてさまざまな実行環境に接続されます。
6. ウォッチドッグ
常時接続を実現するためには、第5節の計算とストレージの分離に加えて、システムが長期間の運用中に異常から自動的に回復できるようにする必要があります。常時接続の分散システムは、主システム内部のロジックだけでは長期的な信頼性のある運用を保証することが難しく、主システムの外部に独立した外部制御ループ、つまりコントロールループを導入する必要があります。
また、エージェントシステムでは、従来のプロセス生存検出や監視スクリプトだけでは不十分です。なぜなら、多くの異常はプロセスのクラッシュではなく、モデルが実行中に無効なループに陥ったり、目標から逸脱したりするからです。したがって、長期間運用されるエージェントシステムは、基盤となるインフラの生存を監視するだけでなく、タスク自体の進捗も監視する必要があります。
私たちは主システムの外部に独立したウォッチドッグセッションを設定し、定期的なメッセージでそれを駆動し、外部のコントロールループを構成しました。ウォッチドッグは、インターフェースのエラー処理や状態回復の失敗などのインフラ障害を処理するだけでなく、モデルが各ワーカーに実質的な進展があるかどうか、方向が全体の目標から逸脱していないかを判断します。異常を発見した場合には、迅速に介入して修正し、外部の偶発的な障害が発生した場合には、正常に回復するまで継続的に再確認します。
ウォッチドッグ自体も完全なツール機能を備えたエージェントセッションであるため、メンテナンス担当者は自然言語で故障の原因を尋ねたり、主システムの動作をオンラインで修正したりすることができます。たとえば、プロンプトの追加や削除、トリガールールの調整などです。
7. 初期実験
前述のコアスケジューリングとルーティング設計を評価するために、私たちは2つのレベルで初期実験を行いました。まず、エンドツーエンドの実験を通じて、二層アーキテクチャ、サブスクリプションの直通、単一セッションのソリューションを比較しました(7.1節)。次に、ルーターレイヤーのバッチ処理を個別にテストしました(7.2節)。実験は合成負荷と簡略化された環境に基づいているため、一部の設定はさらに厳密にすることができ、以下の結果は初期の参考としてのみご覧ください。
7.1 アブレーション実験
私たちは、グループチャットとGitHub CIメッセージフローを同時に駆動して4つのエンドツーエンドソリューションを実験しました。単一の実験には約300件のメッセージが含まれ、そのうち約20件が作業要求で、残りは雑談、フォローアップ、停止、CIメッセージです。コーディング作業は時間を消費するツールに置き換えたため、実験で測定されるのはシステムのスケジューリングと協力能力であり、単一のタスクの実行能力ではありません。各ソリューションは5回繰り返し実行されました。
比較した4つのソリューションには、スーパエージェント、直通を取り除いたスーパエージェント、そして2つのプロンプト設定下の単一セッション + サブエージェントツールが含まれます。
中立的なプロンプトは「適切な場合に作業のためにサブエージェントを使用してください…」と書かれています。
プロンプト優先委任は「チャットのすべてのメッセージがあなたに届くので、自分で実行する作業は新しいメッセージのために常に停止します。各作業をそのサブエージェントに委任し、自分で行うのは小さなことだけにしてください…」と書かれています。
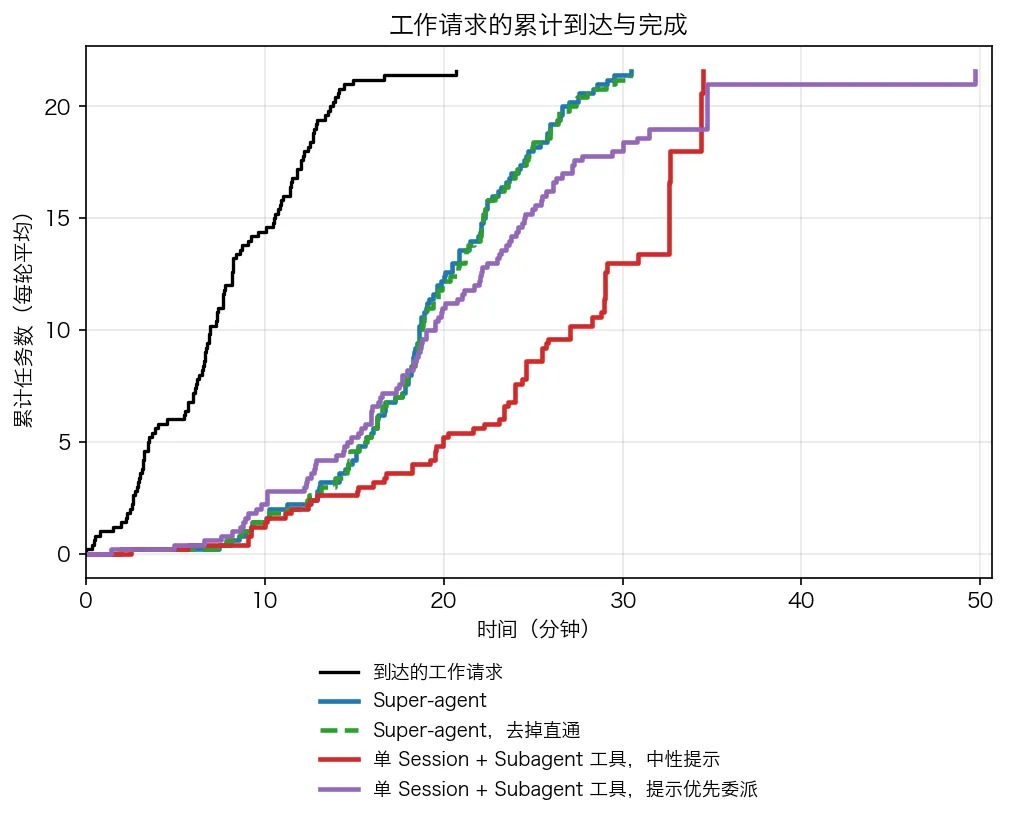
作業要求の累積到達曲線と4つのソリューションの累積完了曲線(5回の実験の平均値;メッセージ間隔と作業時間は1/4にスケーリングされ、モデル呼び出しの所要時間は実際の値)
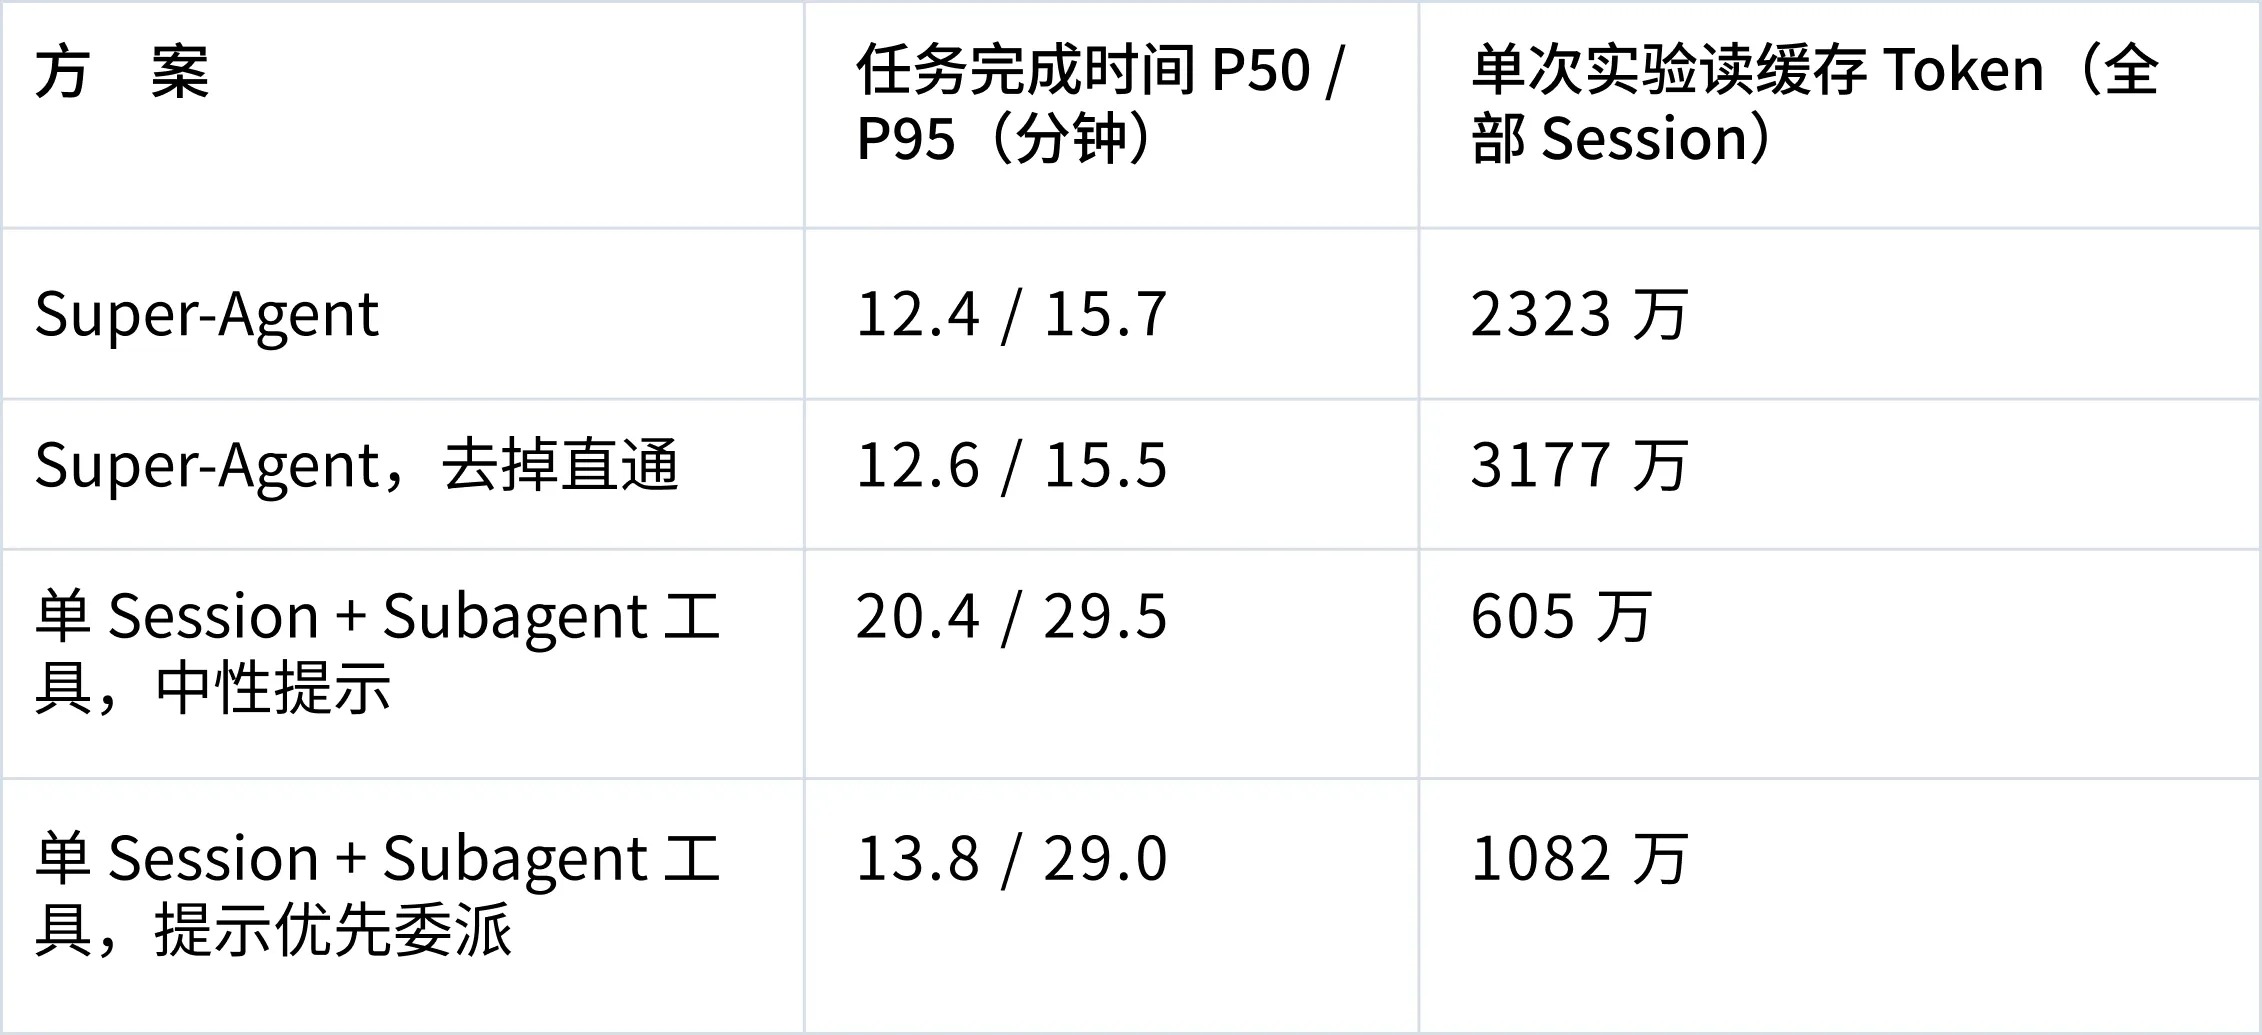
各ソリューションは5回繰り返し実行されました。タスク完了時間は、作業要求から結果メッセージまでの所要時間を指します。
タスク完了時間を見ると、スーパエージェントのp50とp95はそれぞれ12.4分と15.7分で、サブエージェントツールを持つ単一セッションよりも顕著に優れています。その理由は、サブエージェントを持つ単一セッションが実験シナリオの下でプロンプトの影響を大きく受け、主セッションがしばしば自分でタスクを直接実行することを決定し、結果として総完了時間が長く、性能が不安定になるためです。中立的なプロンプトの下では、モデルは5回の実行中に一度もサブエージェントを呼び出さず、すべての作業が主セッション内で行われ、新しいメッセージによって常に中断され、p95は29.5分に達しました。プロンプト優先委任に変更した後、モデルは5回の実行中に4回委任を行い、完了時間は短縮されましたが、全体としては依然としてスーパエージェントより遅く、残りの1回は「非常に小さい」と判断し、自分で実行することを選択し、図の紫色の長尾を形成しました。単一セッション内でプロンプトエンジニアリングとモデルの即時判断に依存するのではなく、二層アーキテクチャはルーターが具体的な作業を直接実行せず、ワーカーがサブスクリプションされたスレッドのメッセージのみを受信することによって、システムレベルでこの問題を緩和しました。
システムのオーバーヘッドを見ると、複数の独立したセッションを維持しているため、スーパエージェントの単一実験の読み取りキャッシュトークンは単一セッションよりも高く、より多くのトークン消費を通じて短く安定した完了時間を得ています。また、スーパエージェント内部で直通メカニズムを取り除いた後、タスク完了時間は完全版とほぼ一致しますが、単一実験中にルーターが行う決定は約30%増加し、総読み取りキャッシュトークンは2323万から3177万に増加し、増加率は約37%です。これは、実験負荷の下で直通メカニズムがタスク完了の質と速度を向上させないが、ルーターセッションにかなりのトークンと推論オーバーヘッドを節約することを示しています。
7.2 ルーターレイヤーのバッチ処理
2.1節での単一常駐ルーターセッションのスループット上限とバッチ処理メカニズムを検証するために、私たちはルーターレイヤーに対してストレステストを行いました。ルーターが実際のモデルを呼び出し、ワーカーがモックモデルを使用し、決定が必要なトリガーの到達速度を毎分約1件から約40件に段階的に引き上げ、平均バッチサイズ、単一リクエストの所要時間、および単一決定の分散推論時間を観察しました。
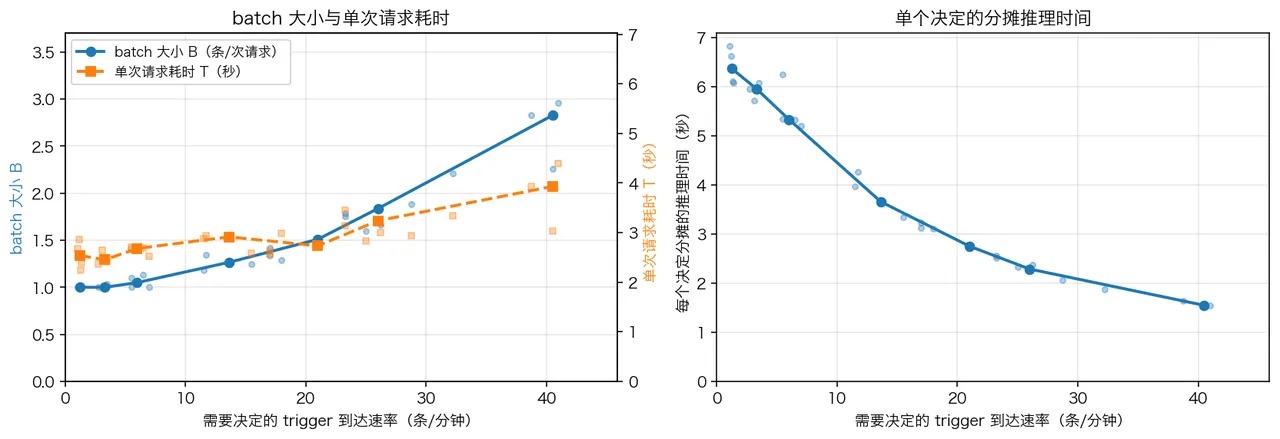
異なるトリガー到達速度におけるルーターセッションのバッチサイズ、単一リクエストの所要時間、および単一決定の分散推論時間
8. オープンな問題
第2節から第6節で紹介した5つのモジュールは、スーパエージェントの運用を支える基本的なアーキテクチャを構成しており、第7節の実験もその中核的なスケジューリングとルーティングメカニズムがマルチタスクの同時実行下での効果を検証しました。このシステムが比較的低い複雑さで運用できる理由は、現在の段階で一連のエンジニアリングとシナリオの簡略化を行ったためです。これらの簡略化の適用範囲を超えると、二層アーキテクチャの拡張(8.1節)、セッションからの脱却後の人間とエージェントの協力(8.2節)、コンテキストの境界とA2A(8.3節)、およびセキュリティとプライバシー(8.4節)において、まだ解決すべき問題がいくつか残っています。
8.1 二層アーキテクチャの拡張方法
前述の「単一常駐ルーターセッション + サブスクリプション直通 + ワーカー間の直接通信なし」という簡略化の組み合わせにより、現在のほとんどの日常タスクを比較的小さなエンジニアリングコストでカバーしました。しかし、タスクの規模が拡大し、結合度が高まると、単一のルーターセッションのキャパシティを超える場合、具体的なレイヤー内の構造には結論がありません。ルーターレイヤーがいつ水平に分割されるべきか、粒度はどのように分けるべきか、同じレイヤーのワーカー間でいつ直接通信を導入し、どのような協力トポロジーを採用するべきかは、より多くのシナリオで検証する必要があります。同時に、システムとモデルの協調設計(Co-design)も探求すべき方向であり、ルーターレイヤーのイベント判別、バッチ配信、コンテキストリコールなどのタスクに特化したトレーニングを行うことで、ルーターレイヤーのスループットと意思決定性能をさらに向上させる可能性があります。
また、前述の常駐ルーターレイヤーは、参照グラフに基づくチェーンリコールと組み合わせて、主に最近のタスクとセッション履歴のオンデマンド検索を解決しています。運用周期が月をまたぐ、あるいはそれ以上の長期間にわたると、長期記憶がスケーラビリティの主要なボトルネックとなります。
8.2 セッションから脱却した後のエージェントとの協力方法
前述の二層アーキテクチャは、基盤となる複数のセッション管理をユーザーに隠し、セッションが製品設計の最優先事項ではなくなりました。しかし、基盤となる実行セッションがユーザーインターフェース上のセッションに直接対応しなくなると、タスクをユーザーに提示し、自然なインタラクションとプロジェクト管理の形式を提供する方法が新たな問題となります。私たちは、チャットウィンドウを中心としたインタラクションがある程度パス依存の結果であると考えています。インタラクションは、特定のドメインに特化したインタラクションインターフェースでより多く発生する可能性があります。たとえば、この記事の例のように、スーパエージェントがGitHubのイシューやプルリクエストで直接作業することができます。セッションはユーザーの使用習慣に基づいてインターフェース上に保持されることもありますが、ユーザーが見るセッションは、基盤では必ずしも単一のセッションに対応しているわけではありません。
また、前述では主に人間がタスクの開始と結果の受け入れ段階でのインタラクションについて議論しました。しかし、モデルの能力が急速に進化する過渡期には、多くのタスクで人間が途中で参加する必要があります。製品設計において、ユーザーが重要な詳細に対して段階的に介入し、バックエンドの自律的な推進の効率を両立させる方法、たとえばユーザーがバックエンドの実行プロセスに随時介入したり、引き継いだり、エージェントとリアルタイムで協力したりすることも探求に値します。
全体として、ユーザーが必要とするプロジェクト管理とインタラクションの形式は、具体的な作業領域や個人のスタイルに密接に関連しており、最終的な形態は高度にカスタマイズされたものになる可能性が高いです。また、DeepSeek Harnessはオープンなアーキテクチャ設計を採用しているため、このカスタマイズをサポートしやすくなっています。
8.3 コンテキストの境界をどのように分け、A2A協力を行うか
前述では常に単一のスーパエージェントインスタンス内部の設計について議論しており、そのサービス範囲内の情報が同じグローバルコンテキストに集約されていると仮定しています。しかし、使用範囲が個人や小チームからより大きな組織に拡大すると、組織がスーパエージェントをどのように配備するかを決定する際には、実際にはコンテキストの共有と隔離の境界を分けることになります。共有コンテキストが必要な範囲は同じインスタンスを共用し、隔離が必要な範囲はそれぞれ独立して配備されます。
さらに見ると、組織内または組織間に複数の相互に隔離されたインスタンスが存在する場合、例えば各メンバーの個人アシスタントとチームで共有されるSuper-agentの間では、この時点での境界を越えた協調はエージェント間通信(A2A、特定のプロトコルを指さない)となります。基盤となるコンテキストを共有せず、それぞれ異なる権限の境界を代表する前提の下で、安全で信頼性のあるA2A通信と協力を実現する方法は、さらに探求する必要があります。
8.4 安全性とプライバシーの確保方法
第3節のイベント駆動設計により、エージェントはより広範な環境によって駆動されることが可能になりますが、信頼できない入力に接触するリスクも増加します。安全性とプライバシーの問題をうまく解決できない場合、Super-agentは非常に小さく信頼できる範囲でしか機能しません。
例えば、第5節ではエージェントループをクラウドにデプロイし、さまざまな実行デバイスに軽量なデーモンをインストールする設計は、クラウドとエッジ環境が互いに信頼されているという前提に基づいています。しかし、クラウドのエージェントループが外部環境のイベントに継続的に接続し、エッジデバイスにプライベートコード、センシティブデータ、ローカル資格情報が存在する場合、このデバイス間接続は重大な安全性とプライバシーのリスクを引き起こします。一度クラウドのエージェントループがサーバー侵入やプロンプトインジェクションに遭遇して破られた場合、その接続されたすべてのエッジデバイスは制御される潜在的なリスクに直面します。
さらに、クラウドが侵害されていない場合でも、エッジ環境内の資格情報がモデルのコンテキストに入ることができれば、通常の実行プロセスにおいても資格情報漏洩のリスクが存在します。したがって、エージェントが資格情報そのものに一切接触せずに資格情報を使用できるようにするための適切なメカニズムを設計する必要があります。このアーキテクチャがより広範な応用に向かうためには、多様な環境からコンテキストを呼び戻すことができると同時に、上記の安全性とプライバシーの問題を解決する必要があります。
9. 結論
全体の設計を振り返ると、私たちは全く新しい理論を提案したわけではなく、コンピュータシステムにおける古典的な工学思想をエージェントシステムの構築に応用したものです。具体的な実装方法は技術の進展に伴って進化しますが、私たちはその背後にあるシステム設計の考え方にはより長期的な参考価値があると考えています。現在、私たちはこの考え方とDeepSeek Harnessに基づいて構築した内部のSuper-agentインスタンスを継続的に運用しており、日常的に問題の再現と修正、コードレビューの応答、DeepSeek Harness自体の反復に参加しています。
冒頭で述べたように、大規模モデルが単一のタスクを実行する際に人間の介入がますます少なくなるにつれて、生産性のさらなる向上を制限するボトルネックは人間の注意力に移行しています。二層アーキテクチャ、イベント駆動、非同期のマルチチャネルインタラクション、ストレージと計算の分離、外部Watchdogを通じて、システムは基盤で煩雑なセッション管理とコンテキストの同期を引き受け、人間が具体的な実行の詳細からより高いレベルの意思決定と受け入れに移行できるようにします。
この形態では、エージェントはもはや指示を待つ受動的な対話ウィンドウではなく、デジタル環境の中で常にオンラインの自律的な協力者へと進化しています。個人に対しては、日常業務を処理するためのデバイス間の協力を行う個人アシスタントとなり、チームに対しては、研究開発のワークフローに統合され、具体的なタスクを引き受けて推進します。私たちは、モデルの能力と基盤システムアーキテクチャの共同進化に伴い、このようなより自律的な作業方式が人間と機械の協力の常態になることを期待しています。
本文の一部の設計はdsh-superagent-prototypeに実装されています。このプラグインは技術的なルートを検証するためのプロトタイプに過ぎず、DeepSeekの正式な製品ではありません。
Author & Acknowledgements
本文はDeepSeek Harnessチームの共同実践に基づいています。Yujia Qiaoがシステムの実装と本文の執筆を担当し、Huanqi Cao、Zui Chen、Xieting Chu、Tianyi Cui、Shiyuan Feng、Yudong Han、Kexin Liu、Shichun Liu、Gesi Luo、Yifan Shi、Tongrui Xiong、C.C. Yu、Ziya Zhang、F. Zhouなどがレビューや議論に参加し、フィードバックを提供しました。システムの実装と記事の形成は、チームの日常的な交流と蓄積なしには成り立ちません。
 リスク警告
 リスク警告