DeepSeek 오픈 소스 추론 프레임워크, 소셜 미디어 측정 추론 총 이익률 또는 95% 초과
 핵심 관점

 DeepSeek 오픈소스 기반 추론 스택 DeepInfer는 각 GPU 시간당 수익이 38달러에 달한다고 발표했으며, 해외 소셜 미디어는 데이터를 통해 단일 카드 하드웨어 총 이익률이 84%에서 96%에 이른다고 추정했습니다. 이 계산은 업계의 공명을 더욱 촉발시켰고, 분석가들은 OpenAI와 Anthropic의 주류 모델 API 총 이익률도 95%에 이를 것이라고 예측했습니다.
DeepSeek 오픈 소스 추론 프레임워크는 대형 모델 산업의 논의를 모델 능력에서 추론 비용으로 더욱 발전시킵니다.
10월 20일, DeepSeek는 내부 추론 프레임워크 DeepInfer와 Token 인코딩 및 디코딩을 위한 deepseek-recipe를 오픈 소스화한다고 발표했습니다. DeepSeek는 DeepInfer가 DeepSeek V4.1-Flash의 대규모 추론을 지원하며, 지연을 줄이는 동시에 처리량을 높이는 것을 목표로 한다고 밝혔습니다. 이 프레임워크는 NVIDIA GPU와 화웨이의 Ascend NPU를 지원하며 Apache-2.0 오픈 소스 라이선스를 채택하고 있습니다.
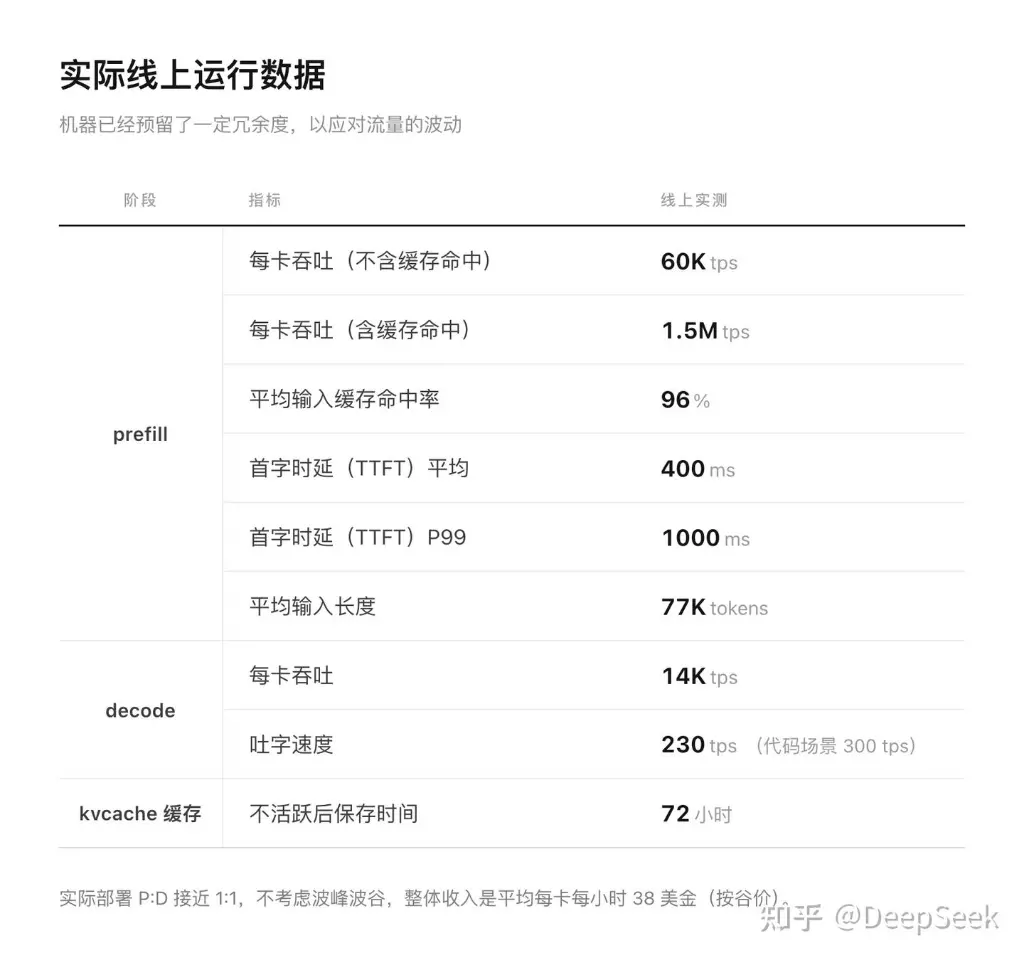
이번 오픈 소스는 DeepSeek가 공개한 추론 서비스 수익과 관련된 배경으로 주목받고 있습니다. DeepSeek가 GitHub에 게시한 배포 Q&A에 따르면, V4.1-Flash 단일 클러스터는 매일 155조 Token을 처리하며, 구글 클라우드의 전력 요금 기준으로 전체 수익은 GPU 시간당 38달러에 달합니다.
소셜 미디어는 캐시 비율, 처리량 및 가격 책정 등의 가정을 바탕으로 추론 총 마진이 최대 84.2%에서 96.1%에 이를 수 있다고 추정합니다. 분석가들은 OpenAI와 Anthropic의 주류 모델 API 총 마진도 95%에 이를 수 있다고 지적했습니다.
이 공개는 외부에서 추론 경제를 관찰할 수 있는 기회를 제공합니다. 그러나 수익 숫자 자체는 이익 수준을 설명하지 않습니다. 시간당 38달러의 수익이 얼마나 많은 총 마진에 해당하는지를 판단하려면 하드웨어 감가상각, 에너지, 네트워크, 캐시 저장 및 운영 비용 등의 정보를 알아야 합니다.
소셜 미디어에서 추정한 총 마진은 96%를 초과
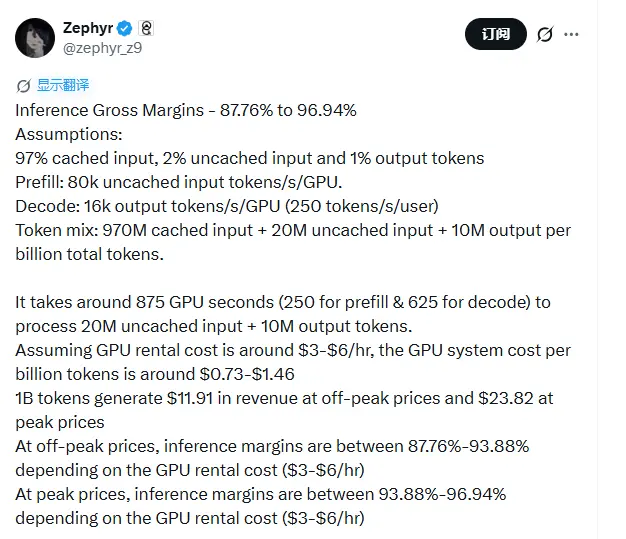
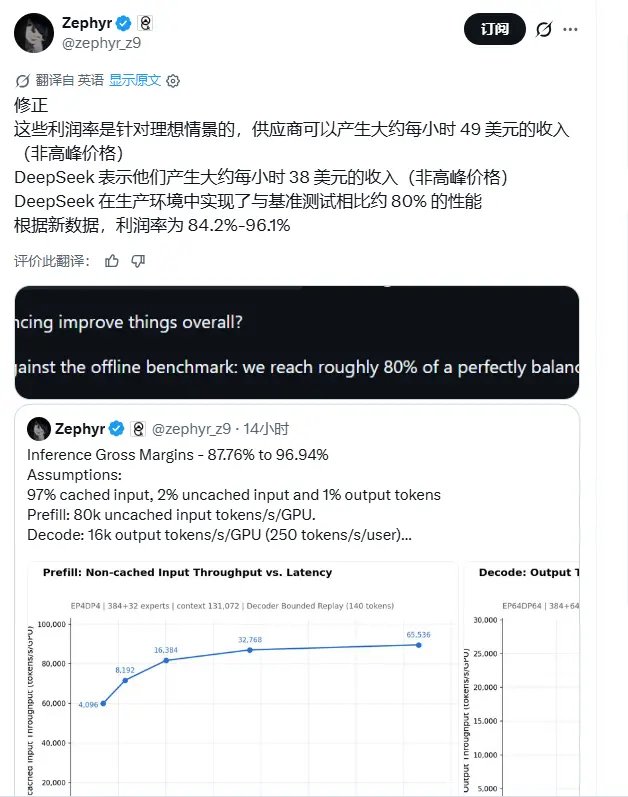
해외 기술 투자 연구원 Zephyr는 소셜 플랫폼 X에서 추정치를 발표하며 DeepSeek가 실제로 "상업 모델 뒤의 핵심 비밀을 공개했다"고 언급했습니다. 그는 DeepSeek의 추론 총 마진이 84.2%에서 96.1%에 이를 수 있다고 추정하며, 이전에 제시된 87.76%에서 96.94%의 범위를 수정했습니다.
그는 전형적인 기본 모델을 설정했습니다: 실제 생산에서 97%의 입력이 캐시 키에 적중하고, 캐시에 적중하지 않은 입력은 2%, 출력은 1%를 차지한다고 가정했습니다.
캐시 입력(Cached Input): 총 Token 양의 97%를 차지하며(단가가 매우 낮고 계산 부하가 매우 가벼움);
미캐시 입력(Uncached Input/Prefill): 총 Token 양의 2%를 차지;
생성 출력(Output/Decode): 총 Token 양의 1%를 차지합니다.
이러한 트래픽 구조에서 Zephyr는 공식 발표된 단일 카드 최대 처리량(프리필 초당 80,000 Token, 디코딩 초당 16,000 Token)을 결합하여 생산 가치를 추정했습니다. 그의 모델에 따르면, 한 대의 GPU가 최대 가동 시 이론적으로 매시간 해당 Token 조합을 처리하고 약 49달러의 수익을 생성할 수 있습니다.
현재 해외 공공 클라우드 시장에서 최상급 GPU(예: NVIDIA H100 또는 유사한 차세대 하드웨어)의 종합 임대 비용은 일반적으로 시간당 1.5에서 4달러로 계산됩니다. 하드웨어 측면의 추론 총 마진 공식은 다음과 같습니다:
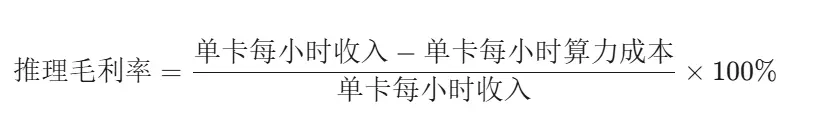
극한 테스트 조건에서(시간당 49달러 생산, 계산 비용 1.5에서 6달러 구간):
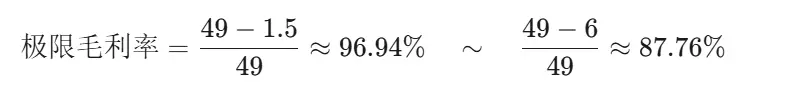
Zephyr는 특정 이상적인 부하에서 해당 프레임워크의 추론 비즈니스 총 마진이 87.76%에서 96.94% 사이에 있다고 밝혔습니다. 그는 트윗에서 "NVIDIA, SGLang 및 vLLM의 공개 성과는 직접적으로 압도당했다"고 언급했습니다.
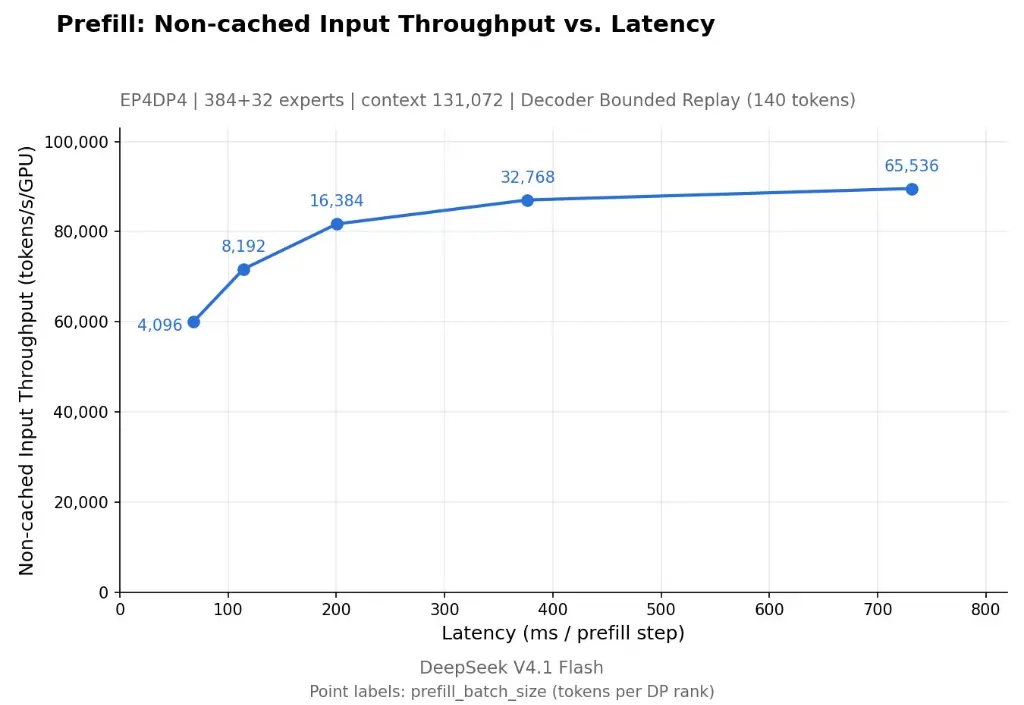
그 후, Zephyr는 DeepSeek가 공식적으로 공개한 실제 운영 세부 사항을 바탕으로 추정 매개변수를 수정했습니다. 그는 "이 극단적인 총 마진은 이상적인 상황을 기반으로 하며, 그 당시 서비스 제공자는 매시간 약 49달러를 생산할 수 있었습니다. DeepSeek는 비피크 시간에 카드당 매시간 약 38달러의 실제 수익을 발표했으며, 생산 환경은 기준 테스트에서 약 80%의 성능을 달성할 수 있습니다. 이러한 최신 숫자를 바탕으로 재평가한 결과, 실제 운영 총 마진은 84.2%에서 96.1% 사이에 위치합니다."라고 덧붙였습니다.
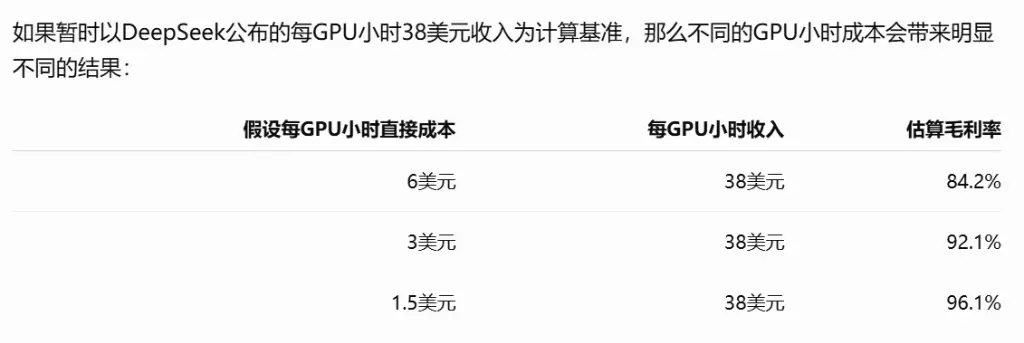
현재 해외 클라우드 서비스 시장에서 최상급 GPU의 임대 비용은 일반적으로 시간당 2에서 4달러 사이입니다. 38달러의 단일 카드 시간당 생산 가치와 단위 계산 비용 간의 큰 차이는 총 마진 추정의 핵심 근거가 됩니다.
산업 수평 추론: 주요 연구소의 총 마진
이 추정치가 발표된 후, 업계에서는 주요 AI 연구소의 실제 수익성에 대한 연쇄 논의가 빠르게 일어났습니다.
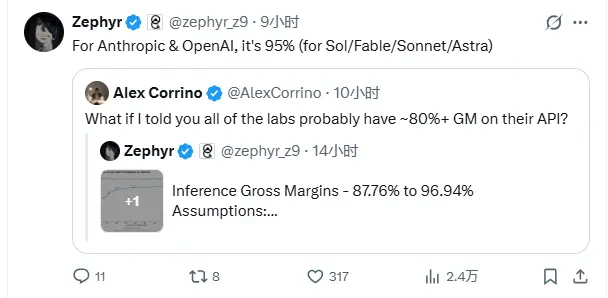
기술 투자 관찰자 Alex Corrino는 위의 추정치를 공유하며 "모든 최상급 AI 연구소의 API 총 마진이 실제로 80% 이상일 가능성이 있다고 말하면 어떻게 하겠습니까?"라고 질문했습니다.
Zephyr는 즉시 해당 트윗을 인용하며 더 공격적인 판단을 내렸습니다: "Anthropic과 OpenAI의 경우, 이 숫자는 실제로 95%입니다(주요 모델인 Sol, Fable, Sonnet, Astra 등에 적용됨)."
Anthropic은 확실히 큰 돈을 벌고 있는가?
업계 전반에 걸쳐 높은 총 마진이 전제된 상황에서, 투자 분석가 Scott은 이 논리를 최종 사용자의 "구독 모델" 경제 모델로 전환하여 해외 주요 기업의 실제 상황을 추론했습니다.
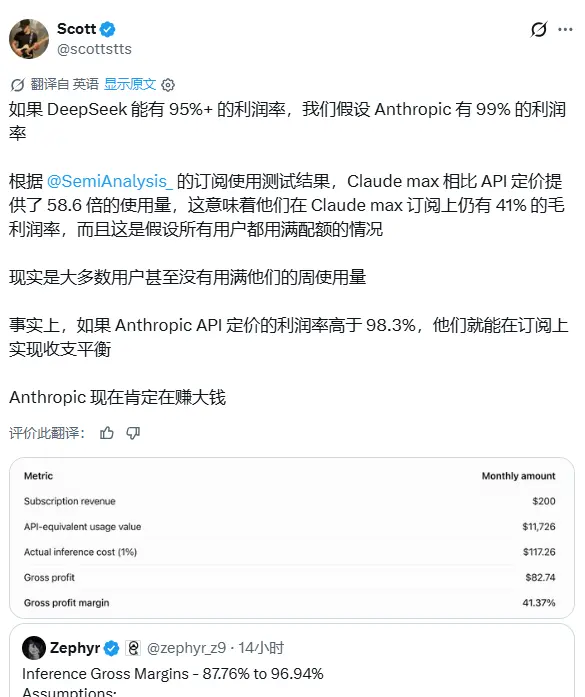
연구 기관 SemiAnalysis의 실측 보고서에 따르면, Anthropic은 고급 회원 "Claude Max"에게 제공하는 실제 사용 가능한 Token 한도가 해당 공식 API 단가의 58.6배에 달합니다. 외부에서는 이로 인해 고용량 구독 사용자가 플랫폼의 이익을 심각하게 잠식하여 손실을 초래할 것이라고 우려했습니다.
Scott은 역추론 공식을 제시했습니다:
기준 전제 설정: Anthropic의 API 하드웨어 총 마진이 99%에 달한다고 가정합니다(비용률은 1%에 불과).
구독 사용량이 극단적으로 가득 찰 때의 비용 역추론: 사용자가 1 단위의 구독료를 지불하면, 이는 58.6 단위 API 가격에 해당하는 계산 용량을 완전히 소모하는 것과 같습니다. 이에 따라 Anthropic이 부담하는 실제 하드웨어 비용은:
실제 하드웨어 비용=58.6×1%=0.586 단위 실제 하드웨어 비용=58.6×1%=0.586 단위
극단적인 상태에서의 구독 총 마진 추론:
Claude Max 극단 총 마진=1−0.5861=41.4%Claude Max 극단 총 마진=11−0.586=41.4%
Scott은 다음과 같이 분석했습니다:
"만약 DeepSeek의 총 마진이 95% 이상에 도달할 수 있다면, Anthropic의 API 총 마진이 99%라고 가정합니다. SemiAnalysis의 테스트에 따르면, Claude Max는 API 가격의 58.6배에 달하는 사용 한도를 제공합니다. 이는 모든 사용자가 할당량을 완전히 소모하더라도, Anthropic은 구독 모델에서 약 41%의 총 마진을 유지할 수 있음을 의미합니다. 실제로 대부분의 사용자는 주간 한도를 전부 사용하지 않을 것입니다."
그는 "실제로 Anthropic의 API 이익률이 98.3% 이상으로 유지된다면, 사용자가 할당량을 전부 소모하더라도 구독 비즈니스는 수익과 비용의 균형을 이룰 수 있습니다. Anthropic은 현재 안정적인 수익 상태에 있습니다."라고 지적했습니다.
기술 분석 계정 Teortaxes도 "주요 연구소의 내부 자체 개발 구조 앞에서, 시장에 있는 모든 공개 기준 테스트는 아무것도 아니다. 이것이 공학을 진지하게 수행했을 때 얻는 결과이며, 추론 비즈니스 자체가 돈을 찍어내는 기계입니다. Dario(Anthropic CEO)가 지금 얼마나 불안할지 상상할 수 있습니다."라고 평가했습니다.
기술 경로의 차이: 소프트웨어 재구성 vs 전용 칩
실제 추론 비용 구조가 드러나면서 업계는 다양한 기술 비용 절감 경로를 재검토하고 있습니다.
하드웨어 아키텍처와 단위 처리 비용 측면에서, 업계는 이 솔루션을 초저지연 칩 제조업체 Groq와 비교했습니다.
업계 관찰자들은 Groq를 대표하는 LPU 맞춤형 하드웨어 아키텍처가 온보드 SRAM에 의존하여 극도의 상호 생성 속도를 얻었지만, 그 칩의 메모리 용량이 매우 작아 주류 대형 모델을 수용하기 위해서는 하드웨어 카드와 대규모 노드 상호 연결을 여러 배로 쌓아야 하며, 이로 인해 단일 Token의 전체 하드웨어 감가상각 및 구매 장벽이 높아진다고 지적했습니다.
반면, DeepInfer는 범용 칩 경로의 또 다른 장부 논리를 보여주었습니다: 범용 GPU 및 Ascend와 같은 상용 NPU에서 소프트웨어 스케줄링을 통해 극도로 동시 처리량을 추출하여 더 낮은 종합 하드웨어 비용으로 대규모 API 서비스의 이익 공간을 확보합니다.
그러나 여러 산업 관찰자들은 논의 중에 위의 80%에서 95%의 총 마진 추정이 주로 "Token 가격과 단일 카드 하드웨어 소비" 간의 직접적인 장부 차이에 집중되어 있다고 지적했습니다. 이러한 미시적 추정은 수억 달러에 달하는 초기 기본 모델의 연구 개발 비용(R&D), 전 세계 노드의 고속 대역폭 네트워크 비용, 그리고 높은 시스템 엔지니어링 팀의 급여를 포함하지 않았습니다.
다음으로 검증해야 할 것은 오픈소스 구현이 다양한 하드웨어와 실제 비즈니스 부하에서 안정적으로 처리량을 증가시키고 각 유효 출력 토큰의 비용을 낮출 수 있는지입니다. DeepSeek 자체에 대해서도 외부에서는 더 많은 비용 및 자원 활용률 데이터가 필요하며, 이를 통해 소셜 미디어에서 추정한 높은 총 이익이 실제 운영 수준에 가까운지 판단할 수 있습니다.
 위험 경고