Углубившись в основы, сможет ли Jev надеть корону "парадигмальных изменений"?
 Ключевые тезисы

 Универсальное суждение требует одновременного использования множества способностей; нельзя считать, что это проще, чем генерация ответа, только потому, что в итоге выводится лишь одна вероятность.
Автор:Боян
Редактор:Сюй Циньян
В технологическом круге циклы хайпа всегда удивительно похожи.
Сентябрь 2026 года, весь Силиконовая долина и сообщество с открытым исходным кодом без ума от модели под названием Jev.
Она утверждает, что это модель «Система Один», которая якобы может принести революционные изменения.
За последние три-четыре года мы привыкли к тем большим языковым моделям (LLM), которые, как многословные писатели, перед тем как ответить на простой вопрос «да» или «нет», сначала генерируют сотни бессмысленных токенов размышлений, а затем медленно выдают заключение в формате JSON.
Но Jev отличается, она обещает сразу дать вам суждение, предоставить вероятность и делает это с поразительной скоростью.
Разработчики без ума от такого «быстрого, точного и жестокого» интерфейса.
В конце концов, когда вы строите сложного AI-агента, вам часто нужно просто спросить его: «Это воспоминание имеет отношение?», «Какой инструмент должен обработать этот запрос?», «Нужна ли ручная проверка этого инцидента?».
Все в бизнесе потратили слишком много токенов и времени на задержки, чтобы заставить универсальную большую модель генерировать текст, объяснения и структурированный код для каждой мелкой проблемы. Jev затронула крайне болезненную точку, исходя из реальных потребностей.
Но действительно ли она обладает достаточной разрушительной силой?
Когда мы исключаем процесс «генерации текста», сколько из оставшихся в этом черном ящике суждений на самом деле является результатом оригинальной большой языковой модели, а сколько — результатом так называемого специализированного обучения команды TypeSafe?
Чтобы ответить на этот вопрос, мы можем поэтапно разобрать упаковку Jev и рассмотреть несколько аспектов.
01
Модель предсказания суждений появилась раньше GPT
Направление, которое представляет Jev, имеет очень долгую историю.
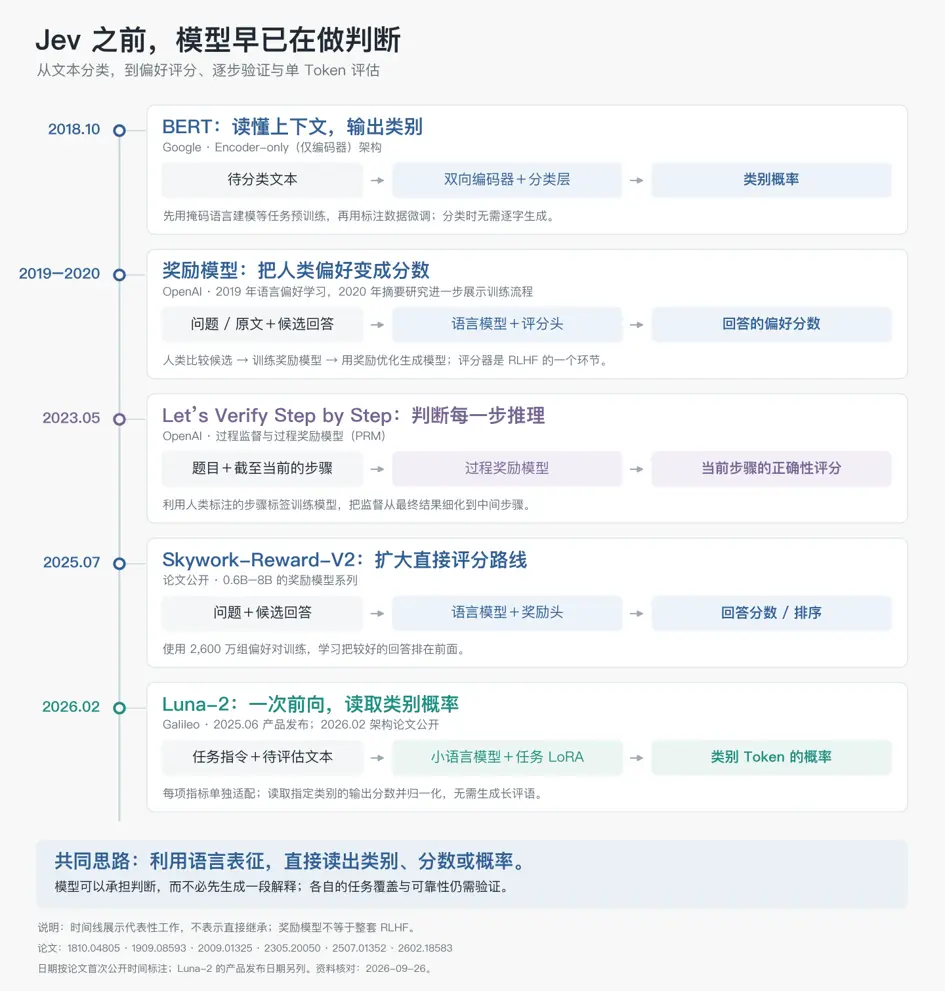
Еще в 2018 году Google выпустил BERT. В отличие от моделей типа GPT, с которыми мы знакомы сегодня, он использует архитектуру только кодировщика (Encoder-only), позволяющую двусторонний обмен информацией, и обучает модель заполнять пропуски.
Хотя позже модели только декодера (Decoder-only), такие как ChatGPT, стали мейнстримом, BERT по-прежнему имеет свои преимущества в четко определенных задачах классификации.
Благодаря возможности видеть всю информацию, BERT может объединять различные позиции текста с учетом контекста, формируя полное представление признаков, а затем, добавив простой классификационный слой и обучив его на размеченных письмах, быстро делать суждения.
На самом деле современные LLM также часто обучаются в роли классификаторов.
В 2019 году OpenAI в статье «Fine-Tuning Language Models from Human Preferences» уже начала пытаться заставить модели учиться на предпочтениях людей к тексту.
К 2020 году в исследованиях по резюме текстов эта технологическая цепочка стала более ясной: человеческие аннотаторы сначала сравнивали два резюме, а затем использовали их для обучения модели вознаграждения, чтобы узнать, какое из них больше нравится людям.
В этом процессе человеческие суждения успешно преобразовывались в функцию оценки. Модель вознаграждения сама по себе не требует написания длинных рецензий, ей нужно лишь прочитать вопрос и ответ, а затем через выходной слой нейронной сети напрямую выдать оценку.
На самом деле это также одна из самых базовых моделей обучения современных моделей, которую Jev резко критикует — RLHF.
Таким образом, «наследовать способность понимания языковой модели, но не генерировать текст» — это не уникальная гениальная идея Jev.
К 2023 году в известной статье «Let's Verify Step by Step» этот надзор был дополнительно уточнен и применен к каждому шагу модели. Модели вознаграждения, валидаторы и оценочные метрики развивались из различных задач и постепенно сформировали несколько незаменимых инструментов суждения в индустрии ИИ.
К 2025-2026 годам связанные исследования продолжают развиваться. В 2025 году Galileo выпустил Luna-2 и в последующих статьях продемонстрировал, как обучить маленькие языковые модели в «одноклассные классификаторы», получая вероятность целевой категории через одно прямое вычисление. А Skywork-Reward-V2 выпустил серию моделей вознаграждения от 0.6B до 8B, оптимизируя прямой путь оценки LLM.
С точки зрения реализации алгоритма это не так уж сложно. Сделать несколько простых изменений в LLM, чтобы она могла напрямую вычислять кандидатные оценки из внутренних скрытых представлений, а не выдавать кучу слов, можно сделать множеством способов.
В последующих экспериментах мы можем увидеть более трех.
Так что же нового принесла Jev в эту волну?
Согласно текущему расшифровке архитектуры и официальным объяснениям, ключевое отличие Jev проявляется в двух измерениях.
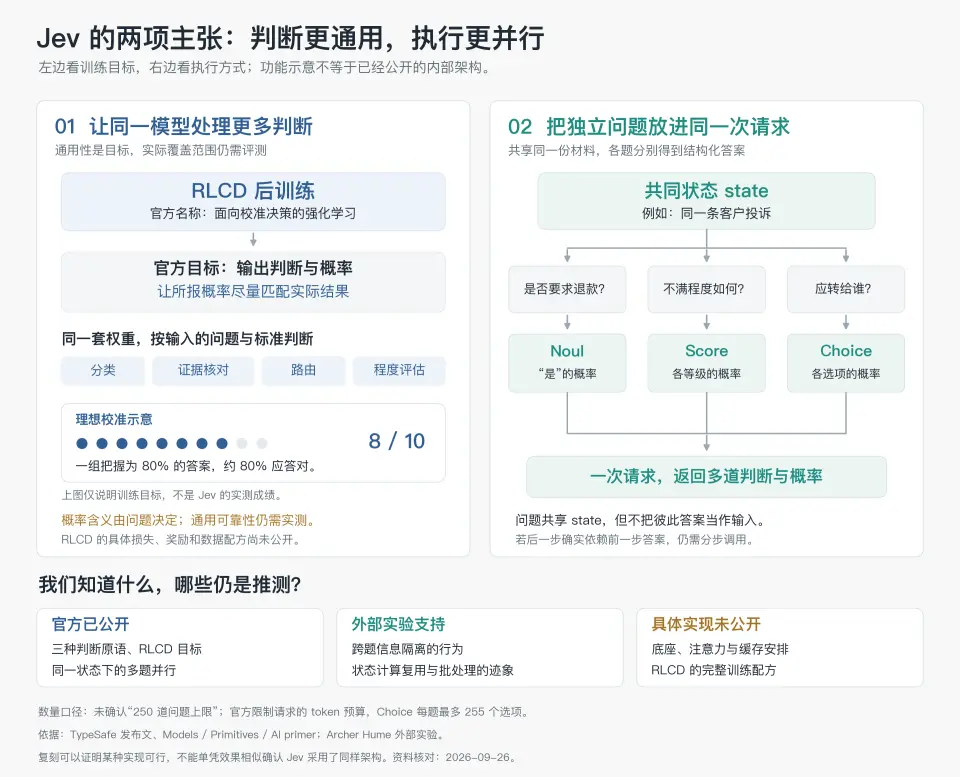
Во-первых, это более универсальное изменение, благодаря его совершенно новому методу постобучения.
Прошлые модели оценки в основном обучались для выполнения одной задачи. Jev больше не ограничивается какой-то конкретной оценкой, а пытается предоставить крайне универсальный интерфейс вероятности.
И этот универсальный интерфейс относится к вероятности фактов, а не к предпочтениям человека.
На этот раз команда TypeSafe поместила «калибровку вероятности» в абсолютный центр цели обучения, они назвали этот метод RLCD (усиленное обучение для калибровки решений). В то время как традиционная модель вознаграждения на основе предпочтений (RLHF) ищет вероятность человеческих предпочтений, а не вероятность событий в реальном мире.
Во-вторых, это экстремальное использование параллельных вычислений в архитектуре.
Jev изменила способ, которым информация проходит через модель. Прошлые модели оценки не вносили много изменений в параллельные ответы, потому что основной целью было обучение плотной модели вознаграждения, чтобы оценивать каждую выходящую токен.
Но теперь Jev может отвечать на 250 вопросов по одному и тому же материалу. Если между этими вопросами нет зависимости в порядке генерации, их можно выполнять в большом масштабе параллельно.
Как это реализовано?
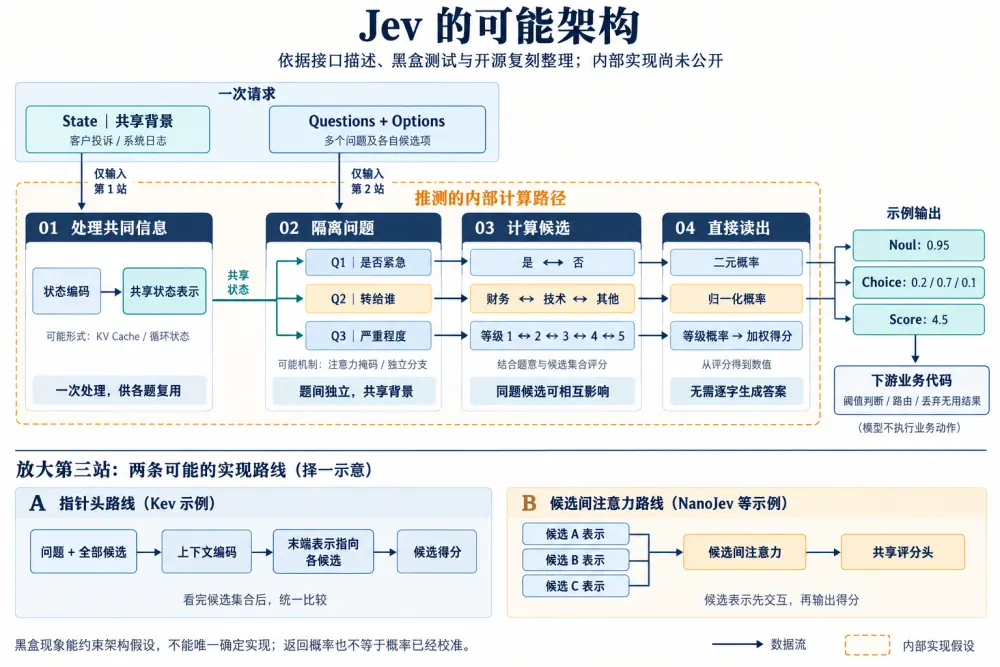
Хотя Jev сама не раскрыла свою архитектуру, исходя из ее фактической производительности и множества попыток восстановить Jev, мы уже можем примерно описать ее контуры.
02
Собирая из тестов и восстановлений, воссоздаем оригинальный облик Jev
Сначала давайте посмотрим, что в настоящее время опубликовала TypeSafe.
За пределами черного ящика TypeSafe четко опубликовала, что это интерфейс. Вы можете предоставить этому интерфейсу две вещи:
State (Состояние): Это соответствует оригинальному тексту длинного чтения (например, длинной записи жалобы клиента или системному журналу).
Questions (Вопросы): По этому оригинальному тексту вы можете одновременно задать несколько вопросов. Вопросы не мешают друг другу. После того как система получит эти независимые ответы, именно вам, как разработчику, решать, как дальше будет развиваться бизнес-логика.
Чтобы стандартизировать вопросы, TypeSafe свела способы задавания вопросов к трем примитивам (Primitives). Включая:
Noul (Вопросы с ответом «да» или «нет»): Спрашивает «да или нет», возвращает вероятность между 0 и 1 (например: это срочно? Вернуть 0.95).
Choice (Выбор): Спрашивает «что выбрать», предоставляет несколько вариантов и возвращает их вероятностное распределение (например: передать в технический отдел 0.8, передать в финансовый отдел 0.2).
Score (Оценка): Спрашивает «насколько», возвращает вероятности различных уровней и окончательную взвешенную оценку (например: индекс гнева клиента 4.5).
Если цель состоит в том, чтобы программа делала распространенные суждения, эти три примитива охватывают большую часть форматов вывода, почти все суждения можно преобразовать в эти три типа вопросов.
Наконец, программа получает числа и принимает меры в соответствии со своими правилами.
Официально обещано, что Jev будет читать State только один раз. Затем все вопросы будут в одном запросе, выполняя параллельные и независимые суждения по этому состоянию.
Независимость означает, что между несколькими вопросами не может быть взаимной ссылки на ответы. Если ваш второй вопрос должен зависеть от результата первого, вам придется отправить запрос дважды.
Поэтому TypeSafe поощряет использование, называемое «Спекулятивное разветвление»: например, обрабатывая жалобу клиента, даже если в конечном итоге выясняется, что это не сбой системы, программа может сразу задать все вопросы: «Это сбой?», «Насколько серьезен сбой?», «Кому передать?». Система параллельно вычисляет все ответы, а затем логика кода на следующем этапе отбрасывает ненужные результаты.
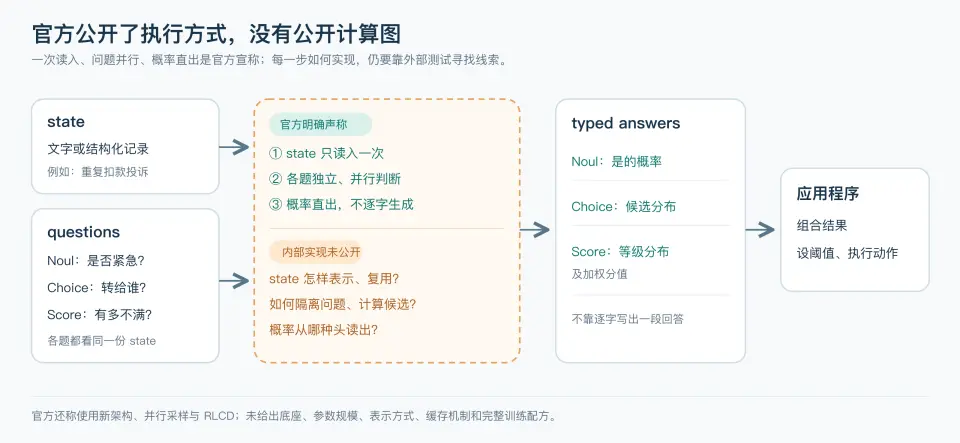
На данный момент это вся основная информация, которую мы знаем из официальных публикаций.
После того как Jev привлек внимание, Арчер Хьюм провел серию черных ящиков тестов, из которых мы можем получить много инсайтов о том, как Jev обрабатывает текст состояния. В то же время открытые проекты восстановления, такие как Kev, NanoJev, minojev и другие, как грибы после дождя, начали появляться.
Сравнив, какие проекты восстановления дают тестовые результаты, наиболее близкие к оригинальному Jev, мы можем косвенно предположить их истинную внутреннюю архитектуру.
Хотя нельзя сказать, что эти восстановления на 100% воспроизводят суть Jev, но в огромных черных дырах, оставленных между официальными документами интерфейса, например, как именно оригинальный текст делится состоянием? Как обычные кандидатные варианты формируют представления признаков? На каком этапе они влияют друг на друга?
Мы также можем увидеть общие контуры через эту призму.
Далее мы используем конкретный запрос, чтобы заново пройти процесс «внутреннего переваривания» этой большой модели черного ящика.
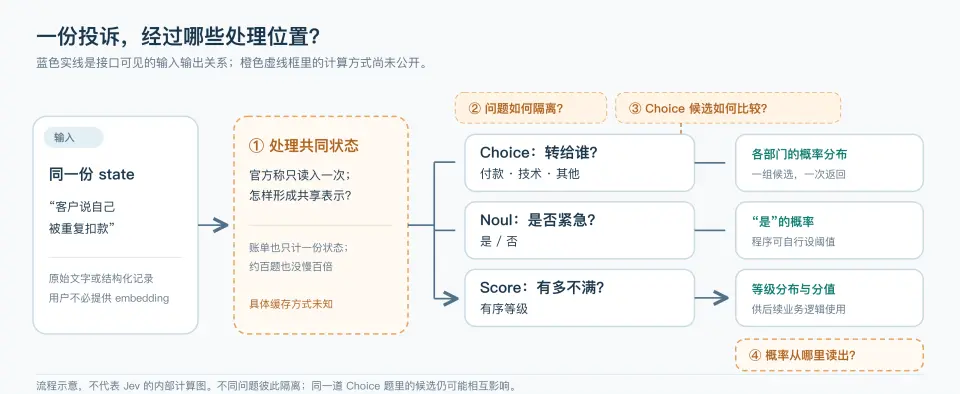
Сначала нам нужно прояснить структуру информации, которую Jev фактически обрабатывает. Полная обработка включает три части: общее состояние (например, длинный текст жалобы), несколько независимо заданных вопросов и соответствующие варианты для этих вопросов.
Первая остановка: обработка общей информации
Если каждый вопрос должен заново прочитать десятки тысяч слов жалобы, чем больше вопросов, тем больше бесполезных вычислений.
Поэтому лучший способ — это позволить всем вопросам прочитать текст только один раз и использовать его.
Чтобы проверить, действительно ли Jev достигла «чтения только один раз», исследователь Арчер Хьюм изучил счета за API и данные о задержках: когда он отправил самый простой вопрос с ответом «да» или «нет», счет показывал 268 входящих токенов; когда количество вопросов увеличилось до двух, он стал 276. Дополнительные токены составляют лишь количество слов, добавленных новыми вопросами, система не повторно учитывает общее состояние.
Одновременно, когда количество вопросов увеличилось до почти ста, время отклика сервера было почти горизонтальной линией.
Хотя правила коммерческого биллинга и пакетного выполнения скрывают реальные вычислительные записи графических процессоров, это в явном виде сильно соответствует официальному заявлению о том, что «общие материалы читаются только один раз, а каждое задание вычисляется пакетно».
Для этой информационной структуры, восстановление проекта с открытым исходным кодом Kev выглядит наиболее ясным.
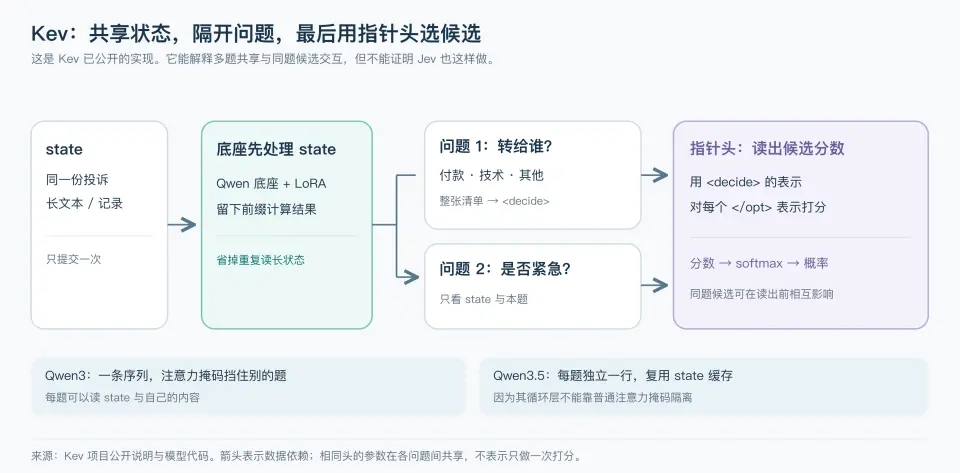
Сначала Kev обрабатывает состояние единовременно, замораживая промежуточные результаты вычислений в Kv Cache. Затем эти 50 вопросов используют этот Kv Cache для дальнейших вычислений, так что не нужно читать каждый вопрос по отдельности.
Вторая остановка: разбиение вопросов
Но другой ключевой вопрос заключается в том, действительно ли эти задания для пакетных вычислений не пересекаются, как утверждает официальная версия?
Арчер Хьюм для этого разработал хитроумный «эксперимент с кодом». Он вставил в вопрос A фразу «код ZEBRA-7741», а затем в вариантах вопроса B заставил модель выбрать «код, упомянутый в другом вопросе». Результаты показали, что вероятность того, что Jev даст правильный код, составляет 0.00. Но если убрать этот код из вопроса A и поместить его в общий текст состояния, вероятность того, что вопрос B даст правильный ответ, мгновенно подскочила до 0.90 и выше.
Это стало сильным доказательством строгой физической изоляции между вопросами: общие материалы видимы для всех вопросов, но соседние вопросы абсолютно не могут «подсматривать» друг за другом.
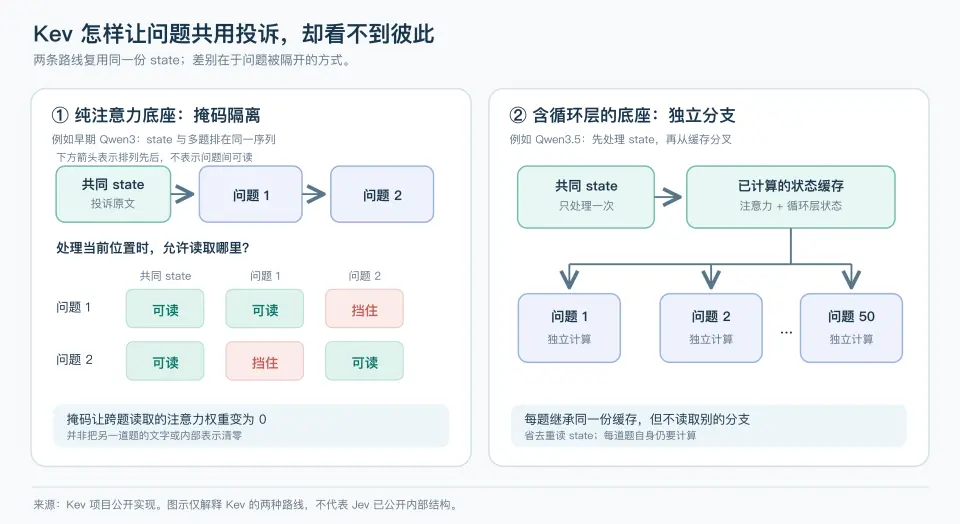
Чтобы гарантировать разделение вопросов, Kev использовал два метода.
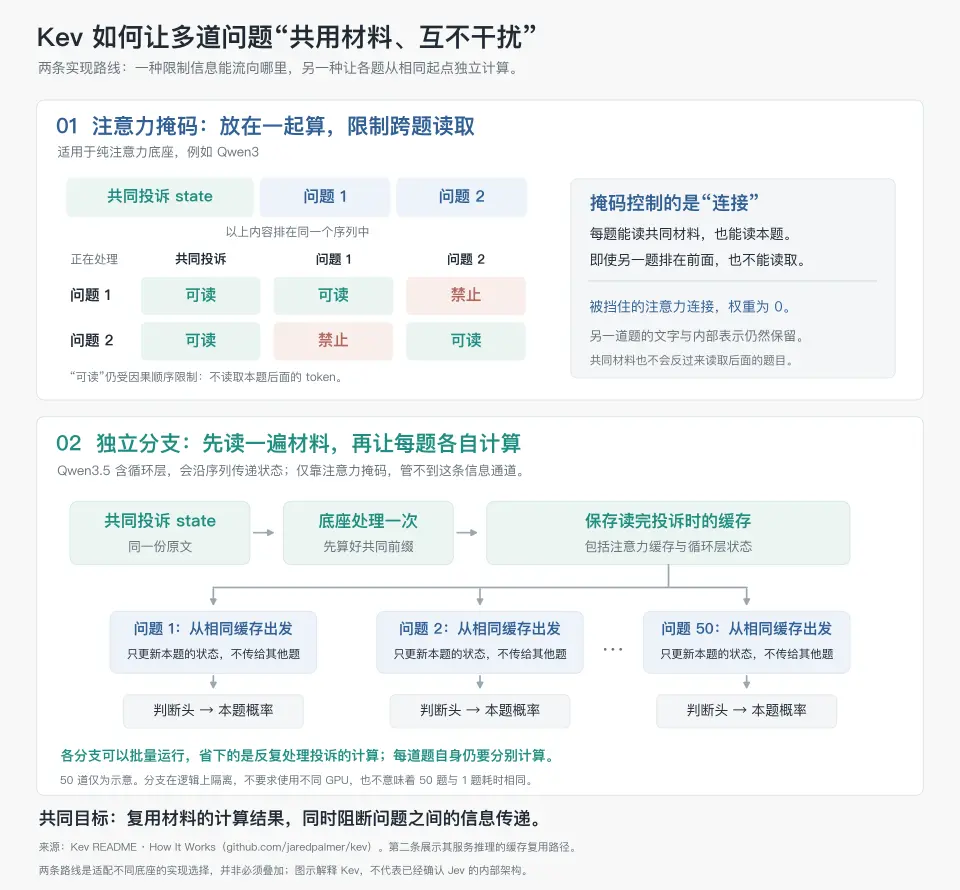
Первый метод — это маска внимания, благодаря которой, когда система вычисляет [замороженный текст жалобы] + [вопрос 1] + [вопрос 2], пока модель обрабатывает вопрос 1, механизм маски заставляет область вопроса 2 принимать значение 0, принуждая ее «обращать внимание» только на общий текст жалобы и на себя.
Второй метод — это независимое ветвление, когда базовая модель имеет циклические характеристики или специфическую архитектуру (например, упомянутую в тексте Qwen3.5), маска внимания не может быть отделена. Поэтому при использовании этих моделей, когда модель завершает чтение текста жалобы, она начинает с этой замороженной памяти и непосредственно разделяет на 50 параллельных высокоскоростных дорог (независимых ветвей).
Поскольку каждая ветвь идеально наследует уже обработанную память о жалобе на главной дороге, они также получают выгоду от того, что не нужно повторно читать оригинальный текст.
Третья остановка: вычисление вариантов
Теперь, когда состояние общее, а вопросы разделены, как модель вычисляет и обрабатывает те варианты внутри одного выбора?
На этот момент перед моделью стоят несколько вариантов, например, «финансы», «технологии». Самый традиционный подход — это линейная голова (Linear Head) плюс Softmax. То есть это модель, которую версия Zefan Open-Jev пыталась воспроизвести, когда пыталась воссоздать Jev.
Вы можете полностью приравнять это к абсолютно закрытому «черному ящику». Участник «финансов» заходит в черный ящик, вы по жесткому рейтинговому руководству (это функция линейной головы) ставите ему 80 баллов, затем «технологии» заходят в черный ящик, вы ставите 90 баллов. Эти два человека никогда не встречаются, и вы никогда не сравниваете их. В конце вы используете Softmax, специальную математическую формулу для расчета процентов, чтобы преобразовать 80 и 90 в шансы на победу.
В этом гипотетическом процессе, если мы вставим в пул вариантов совершенно нелогичный отвлекающий элемент, например, «плохая погода», он в лучшем случае будет служить пушечным мясом в знаменателе, заставляя проценты, которые получают все, немного уменьшиться. Однако, поскольку 80 баллов, которые вы дали финансам, и 90 баллов, которые вы дали технологиям, уже записаны на бумаге, их «относительные шансы» абсолютно не могут измениться из-за добавления одного отвлекающего элемента.
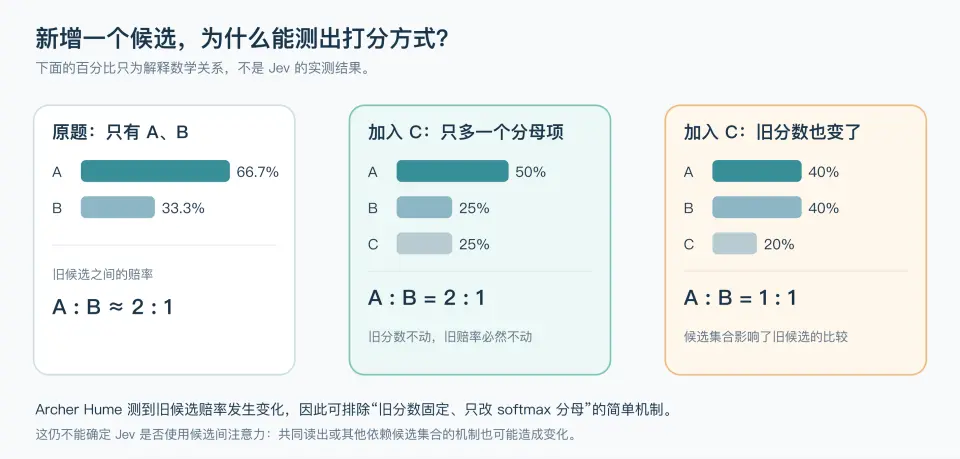
Но тестирование Арчера Хьюма доказало, что добавление новых вариантов действительно влияет на разницу в баллах модели. Он жестко вставил отвлекающий элемент «плохая погода» в набор нормальных вариантов и в десяти случайных тестах обнаружил, что это действительно изменило относительные шансы финансов и технологий. Это прямо приговорило «черный ящик» к смерти.
Поскольку это не слепое тестирование, это означает, что участники определенно «видят друг друга» и создают химическую реакцию до того, как судьи выставят окончательные баллы. Сообщество с открытым исходным кодом предложило два способа реализации этой химической реакции.
Первый метод — это «модель указателя (Pointer Head)», разработанная проектом Kev. Вы можете представить это как «групповое собеседование». Модель больше не запирает участников в черный ящик, а выстраивает «финансы, технологии, плохая погода» в ряд, позволяя судьям увидеть всех сразу.
Когда судья видит последнего участника, у него уже сформировалось общее представление о контексте этого собеседования. Затем судья, стоя на последнем месте, как бы указывая пальцем, по очереди указывает на предыдущих участников, оценивая их по текущему общему впечатлению, это действие называется указателем. Когда судья смотрит на всех, а затем возвращается, чтобы указать, его психология и система отсчета уже изменились, и баллы, выставленные финансам и технологиям, естественно, также изменятся.
Второй метод — это «внутреннее обсуждение жюри», разработанный проектами NanoJev и другими, **модель «модуля внимания между кандидатами (Inter-candidate Attention Module)». На этот раз модель не является чисто слепым тестированием и не является чисто групповым собеседованием. Сначала она позволяет «финансам» и «технологиям» выступить, сжимая их выступления в длинный вектор высокоразмерных чисел, этот термин называется **вектор признаков.
На этом этапе две карточки с оценками все еще изолированы. Но затем отдельная небольшая модель бросает эти две карточки с оценками, вместе с карточкой оценки «плохая погода», в конференц-зал, называемый «модулем внимания».
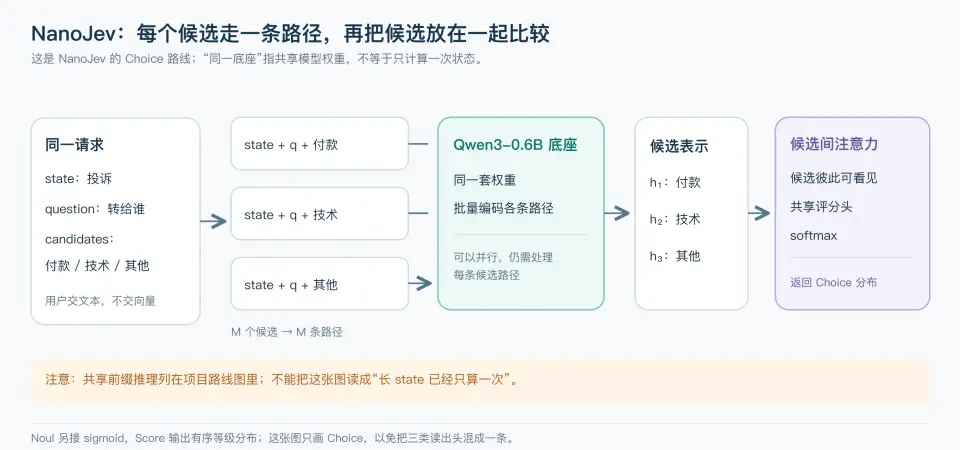
В этом конференц-зале эти группы чисел, представляющих участников (векторы признаков), будут взаимно сравниваться и оцениваться. Изначально финансы и технологии были трудноразличимы, но внезапно карточка «плохая погода» участвует в обсуждении, и фокус обсуждения и вес сравнения всего жюри мгновенно нарушается и перераспределяется.
После этого внутреннего совещания, на котором участники «тянули друг друга вниз», окончательные баллы, конечно, уже не будут такими, как в начале, когда было только два человека.
Почему Jev так старается заставить эти варианты «тянуть друг друга вниз» на уровне базового кода? Это абсолютно не просто для демонстрации навыков, а потому что в реальных сложных бизнесах правильный ответ часто не является абсолютным, а «выявляется» в процессе. Сами варианты на самом деле являются скрытыми подсказками для решения задачи.
Например, спросите, где находится Эйфелева башня? Варианты: A. Европа B. Франция C. Париж. Когда модель одновременно видит эти три варианта, сами варианты становятся скрытыми подсказками для разгадки намерения этого вопроса. Этот вопрос не проверяет приблизительное местоположение, а проверяет максимальную точность географического положения.
Четвертая остановка: выдача результатов
Последний шаг процесса — это получение конкретного балла.
Согласно официальному заявлению TypeSafe, Jev будет напрямую возвращать числовую вероятность, никогда не генерируя текст слово в слово.
Внешние проверки Арчера Хьюма также подтвердили это, когда он увеличил количество вариантов с двух до двухсот, текст ответа API, хотя и стал очень длинным, но время обработки на сервере не увеличилось пропорционально.
Это указывает на то, что большая модель действительно пропустила самый времязатратный шаг саморегрессии (то есть предсказание следующего слова, как в ChatGPT).
Так откуда же берется это окончательное числовое значение вероятности? Этот технический процесс на самом деле разнообразен, в основном зависит от методов, использованных на предыдущем этапе вычисления вариантов.
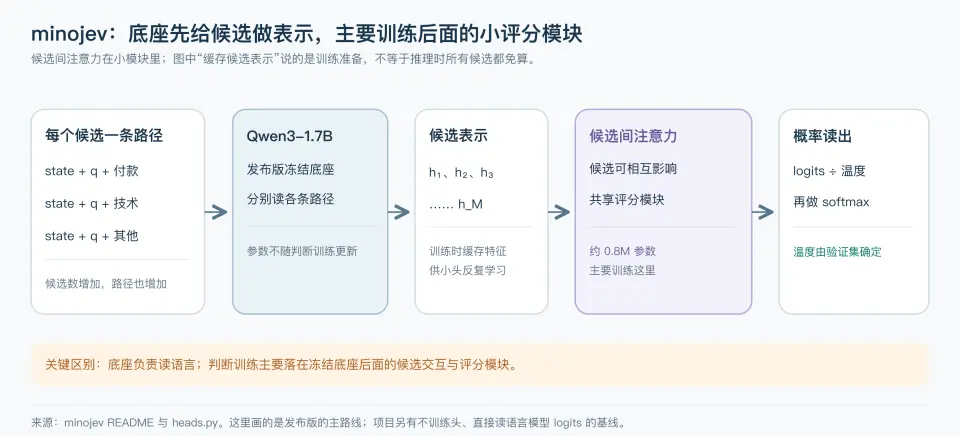
Метод openjev/openjev, который не обрабатывает взаимодействие вариантов специальным образом, просто считывает исходные оценки (Logits) для заданного кандидата в том «месте ответа», где модель должна была бы сгенерировать первый символ.
Kev с указателем полагается на тот указатель, который может охватить всю картину, чтобы напрямую выводить сопоставленные оценки. А миноджев полагается на модуль совместной оценки, чтобы выдавать результаты.
Неважно, какой способ извлечения используется, при правильном проектировании процесса большая модель вполне может отказаться от многословной генерации текста и на конечном этапе вычислений напрямую извлекать точные математические вероятности, завершив системное автоматическое принятие решений.
На этом этапе мы уже можем четко на основе оценок и восстановлений примерно указать архитектурную модель Jev.
Эта архитектура сама по себе не сложна, и в ней трудно найти что-то, что можно было бы назвать парадигмальной революцией. Хотя это действительно отличная инженерная оптимизация для конкретного сценария, но и только.
03
Гарантия точности — это постобучение
Архитектура лишь гарантирует скорость, как же Jev достигает высокой точности?
Это достигается благодаря методу постобучения, который TypeSafe называет RLCD (усиленное обучение с калибровкой решений). Поскольку RLCD является закрытой черной коробкой, мы можем лишь взглянуть на попытки сообщества с открытым исходным кодом, чтобы увидеть его потенциальные задачи и алгоритмические реализации.
Рождение задачи для обучения RLCD
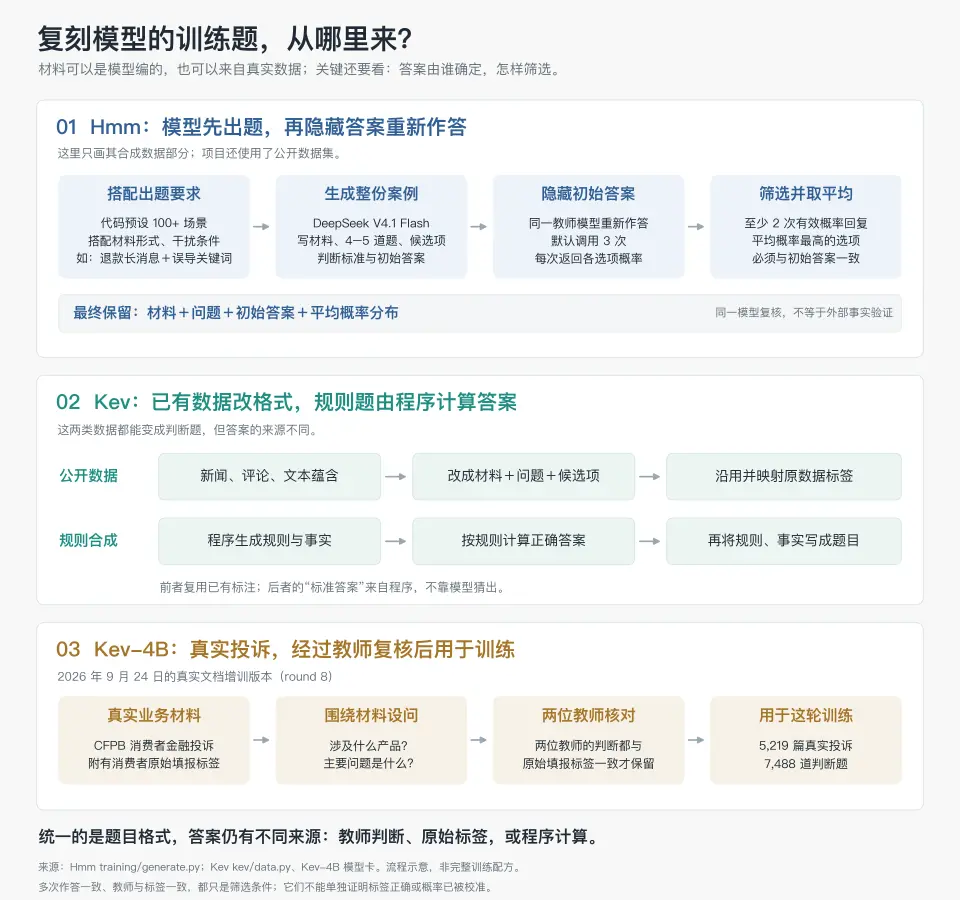
Самый простой способ — это прямой синтез, например, метод, предложенный в версии Hmm.
Исследователи заставили DeepSeek V4.1 перечислить более ста рабочих сценариев в коде, включая обработку возвратов, диагностику неисправностей, поиск релевантности, распределение электронной почты и т. д.
Каждый раз выбирается один сценарий, затем комбинируются формы материалов и требования к заданиям. Например:
Использовать длинное сообщение с не относящимися к делу деталями, чтобы написать несколько примеров возвратов.
Добавить пример, который легко может быть введен в заблуждение ключевыми словами.
Каждый пример сопровождается четырьмя-пятью вопросами на выбор, истинность или уровень.
DeepSeek V4.1 Flash затем генерирует весь материал, вопросы, варианты, критерии оценки и ответы.
Затем тестирование этой задачи на возможность использования зависит от скрытия оригинального ответа, позволяя DeepSeek V4.1 Flash снова ответить, по умолчанию вызывая это трижды и требуя, чтобы каждый раз были даны вероятности вариантов. Код допускает использование только тех задач, которые могут дать как минимум два действительных ответа.
Метод Kev заключается в том, чтобы классифицировать существующие новости, комментарии, эмоциональные оценки и другие наборы данных, преобразуя их в формат «материал + вопрос + кандидатные ответы» по установленным правилам.
Модель затем генерирует правила и факты, вычисляет ответы и записывает их в текстовом формате.
24 сентября Kev-4B также попытался использовать реальную рабочую среду для создания вопросов. Они собрали 5,219 реальных жалоб потребителей на финансовые услуги и составили вопросы на основе «какой продукт затрагивается, какая основная проблема». Вопросы сохранялись только в том случае, если суждения двух разных моделей учителей совпадали с исходными метками, заполненными потребителями.
Чтобы сделать это обучение более эффективным, восстановленные тестовые задания также будут включать специальные парные ловушки.
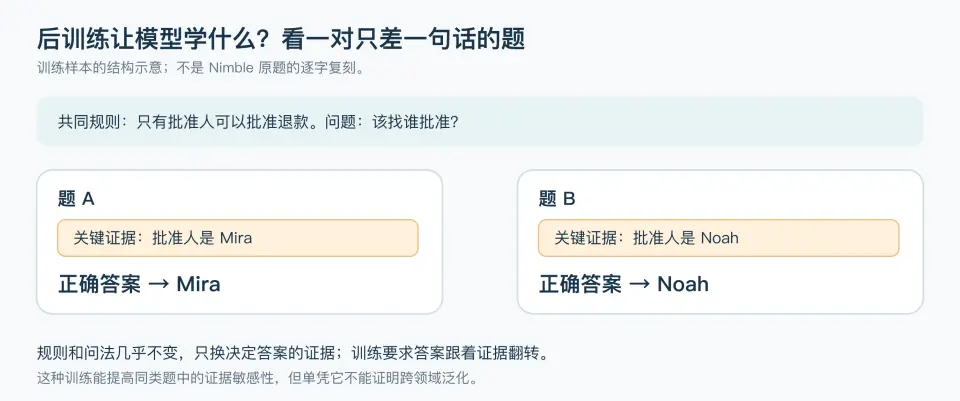
Например, правила двух вопросов абсолютно идентичны, но изменяется одно ключевое имя (например, подписант с правами Mira заменяется на неподписанта Noah), и ответ просто переворачивается. Такие вопросы эффективно предотвращают запоминание ответов моделью через Reward Hacking, заставляя ее честно работать над глубокими представлениями и связями между вопросами и вариантами ответов.
Достаточно ли метода обучения LoRA с дистилляцией?
В настоящее время практически все воспроизведения методов обучения используют комбинацию «LoRA + дистилляция учителя» для повышения вероятности правильного выбора.
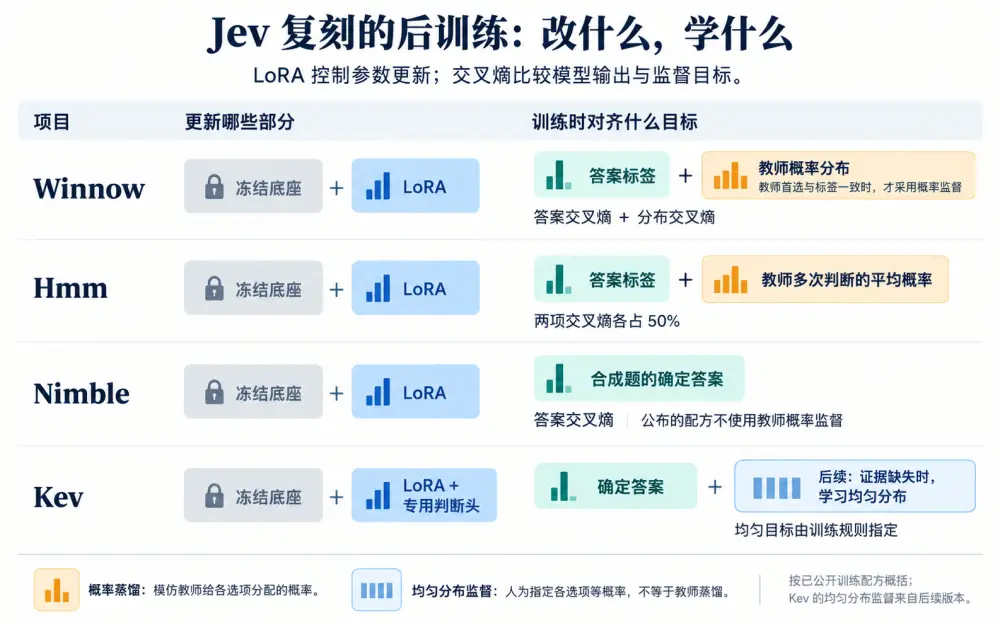
Например, Winnow выбрал провести тонкую настройку LoRA на модели Gemma 4 12B. Действие LoRA заключается в сохранении исходных весов базы, обучая небольшую часть корректирующих параметров, участвующих в вычислениях, что снижает стоимость изменения модели.
Winnow использует два типа надзора. Один предоставляет стандартный ответ, требуя от модели повысить вероятность правильного выбора. Другой предоставляет распределение вероятностей для всех вариантов от учителя, позволяя студенту приближаться к этому распределению. Только когда первый вариант, выбранный учителем, совпадает со стандартным ответом, Winnow применяет второй тип надзора.
Обе меры вычисляют ошибку обучения через кросс-энтропию. Кросс-энтропия здесь отвечает за проверку того, насколько неправильно студент распределил вероятности. Чем ниже вероятность правильного выбора, тем больше наказание.
При использовании распределения учителя обучение будет побуждать студента имитировать распределение учителя по каждому варианту. Например, если учитель распределяет 80%, 15% и 5% для A, B и C соответственно, студенту будет предложено изучить различия между этими тремя вариантами.
В общем, LoRA, дистилляция и кросс-энтропия уже достаточно для задач, где подготовлены вопросы, ответы и эталонное распределение (например, такие задачи, как предсказание вероятности), поскольку они изучают только одну вероятность.
Но дистилляция на самом деле изучает вероятность учителя, а не реальную вероятность, о которой говорит RCLD. Как преодолеть разрыв дистилляции через факты / соотношение учителя, в текущих воспроизведениях нет четкой идеи.
Теоретически, чтобы реализовать утверждение Jev, необходимо большее количество данных и более эффективные методы обучения.
Конечно, если такой маленький модельный судья сможет достичь точности больших моделей, то это будет очень полезно, даже если проблема не решена.
Калибровка, возможно, все еще является секретным оружием
Кроме того, у Jev есть еще одно секретное оружие — это его заявленная способность к калибровке.
Количество правильных ответов модели не всегда соответствует тому, насколько точно она выражает уверенность. Модель может ответить правильно на 70%, но всегда сообщать о 90% уверенности.
Чтобы проверить, не является ли Jev слепо самоуверенным, Арчер Хьюм провел «эксперимент с детектором лжи».
Он сначала дал Jev 1200 вопросов теста MMLU (масштабное многозадачное языковое понимание), а затем разделил все выбранные ответы по вероятности, сообщенной системой, на десять уровней. После сложных взвешенных расчетов, калибровочная ошибка Jev составила всего 0.031.
На 30 простых задачах умножения Jev ответил правильно на 86.7%, а его средняя уверенность составила 83%, что очень близко. Когда вопросы стали сложнее, например, «двухшаговые задачи», его точность резко упала до 32%, что важно, его средняя уверенность также снизилась до 30%.
В этом отношении, методы постобучения действительно могут улучшить вероятностные показатели, но часто делают модель более слепо самоуверенной.
Чтобы восстановить более точную способность калибровки Jev, в воспроизводимой версии были использованы некоторые методы. Например, Kev четко требует от модели снижать уверенность в условиях отсутствия доказательств. Он добавляет в обучающий набор образцы, в которых ключевые доказательства были удалены, а затем снижает их вероятность в ответах, таким образом, модель будет наказана за безосновательное сосредоточение вероятности на каком-либо варианте.
Однако многие воспроизведения просто делают калибровку температуры, что является временным решением.
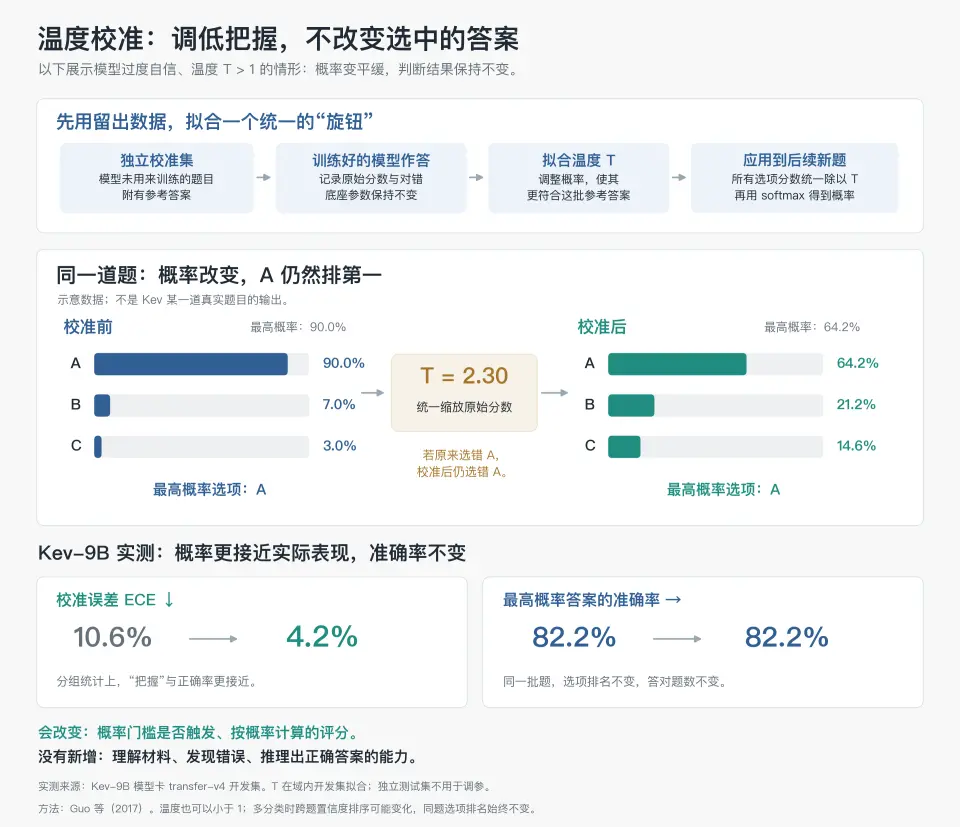
Инженеры берут небольшую партию тестовых вопросов, с которыми модель не сталкивалась, и дают их обученной модели. Если модель оказывается слишком самоуверенной, система вычисляет, насколько следует скорректировать общую уверенность.
Как только ручка настроена, модель будет вынуждена использовать «скромный фильтр» при выводе вероятностей, превращая их в более плавные значения.
Это не изменит порядок вариантов ответов на один и тот же вопрос, поэтому ответ с наивысшей вероятностью останется прежним. Но порог вероятности и оценки, основанные на вероятности, могут измениться.
Этот метод довольно эффективен. Например, после калибровки температуры у Kev-9B калибровочная ошибка снизилась с примерно 10.6 процентных пунктов до 4.2 процентных пунктов, при этом количество правильных ответов не изменилось.
Говоря, что это временное решение, это связано с тем, что оно на самом деле происходит из общего снижения уверенности, а не из более точного различения того, следует ли быть уверенным.
Если предположить, что Jev действительно достиг эффективного повышения уровня калибровки, то, возможно, у них действительно есть некоторые секреты.
04
Каковы границы применения Jev?
Jev, безусловно, имеет практическое значение. Он возвращает задачи, которые изначально требовали быстрой оценки, к самой быстрой оценке.
На протяжении всего процесса Agent, классификация запросов и маршрутизация, сортировка результатов поиска, существует множество четких требований к поэтапной проверке. Все это области, где Jev может проявить свои способности.
Например, распределение клиентских запросов, классификация товаров, анализ отзывов, аннотирование данных — это распространенные высокочастотные сценарии в нашей повседневной работе.
Но насколько велики его границы применения, определяет, является ли он тем, что он утверждает, обладающим парадигмальной ценностью.
Согласно текущим бенчмаркам, он действительно относительно универсален. Команда Nimble протестировала фактическую проверку, маршрутизацию намерений, семантическое содержание, модерацию контента, медицинские вопросы и другие задачи на 13 группах, в общей сложности 3,880 открытых данных, и средняя точность Jev по наборам данных составила 76.0%.
Это говорит о том, что Jev действительно способен выполнять множество оценочных задач.
Но настоящая универсальность сталкивается с двумя препятствиями.
Первое — это сложные задачи. Если он может выполнять только простые оценки, его область применения будет очень ограниченной.
Сначала нам нужно определить, что такое сложность в оценках. Обычно мы считаем, что чем больше шагов, условий и требований к пониманию деталей, тем сложнее задача.
Определить «пользователь хочет вернуть деньги» требует лишь понимания буквального смысла, но оценить «должен ли этот возврат быть одобрен» требует проверки дат, расчета сроков и сравнения приоритетов условий, что явно сложнее. А если для получения результата требуется три шага рассуждений, то третий шаг зависит от результата второго шага, что создает зависимость между многошаговыми процессами. Если на первом шаге была допущена ошибка в политике, последующие расчеты, даже если они абсолютно верны, в конечном итоге приведут к ошибочному решению.
В тестировании сложных вопросов JevBench установил некоторые факторы сложности, связанные с оценочными задачами, включая многоусловные оценки, последовательный поиск доказательств, сравнение дат и чисел. В этой группе вопросов точность многошагового поиска Jev составила 85.7%, точность длинных политических оценок — 60.5%, а точность оценок времени и чисел составила всего 26.7%, что значительно уступает моделям уровня Flash. В сложных вопросах Jev ответил правильно на 74.1%, в то время как DeepSeek V4.1 Flash составил 95.0%, что примерно соответствует уровню человеческих экспертов.
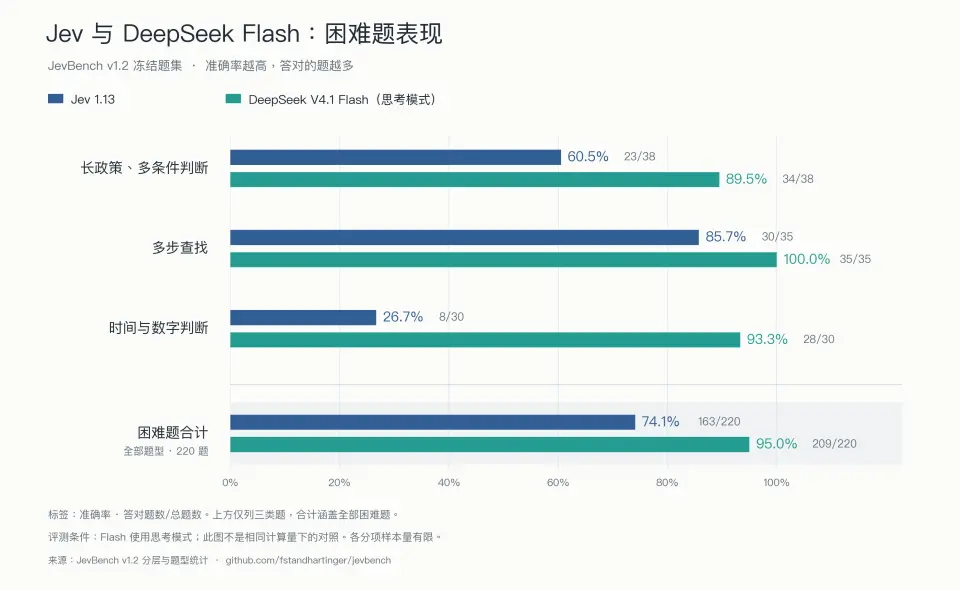
Хотя среднее время обработки соответствующих тестовых запросов составило около 0.67 секунды и 3.15 секунды, скорость Jev была почти в четыре раза быстрее. Но такая большая разница в точности делает выбор очевидным для некоторых оценок, которые сталкиваются со сложными задачами (например, в торговле акциями, как все надеются).
Кроме того, точность многошагового поиска здесь не является многошаговым рассуждением, в основном это связано с поиском. В тестировании Арчера Хьюма Jev показал точность 86.7% в простых задачах умножения, но при переходе к двухшаговым задачам точность резко упала до 32%.
Briantrust провел более детальную оценку, которая также показывает слабые места Jev в сложных вопросах. Он сравнил Jev и модель GPT 5.6 Luna, заставив модель выбрать правильный ответ из двух кандидатных ответов, в итоге сравнив 616 пар действительных вопросов. Разница в знаниях между двумя моделями составила всего 1.6 процентных пункта, в то время как в математике и рассуждениях она увеличилась до 19.3 процентных пункта, а в кодировании — до 20 процентных пунктов.
Таким образом, в отношении сложных оценок Jev трудно утверждать, что он уже преодолел это препятствие.
Другим препятствием является обобщение.
Если Jev действительно универсален, он должен быть способен к хорошему обобщению, повышая точность оценок других вопросов на основе того, что он изучил.
В противном случае он просто будет немного более универсальной «специальной моделью оценки», не отличаясь от предыдущих моделей.
Существующие многофункциональные прямые тестовые доказательства могут подтвердить, что Jev действительно обладает определенной способностью к обобщению, но эта способность крайне нестабильна в пределах области. Как только он выходит за пределы знакомых сценариев, его производительность по-прежнему сталкивается с огромными рисками.
Во-первых, в полностью идентичных задачах и фактах, оценки Jev легко подвержены влиянию способа представления информации. В эксперименте OpenProse, не меняя никаких фактов, вопросов и объема вычислений, когда ключевые отношения сосредоточены в начале текста, точность Jev составила 80.5%, но когда эти отношения переместились в середину, точность резко упала до 40.9%.
Это показывает, что даже без изменения области бизнеса, стабильность представления Jev серьезно недостаточна. Его способность к оценке сильно зависит от того, как внешние программы предоставляют ему данные.
Во-вторых, когда Jev сталкивается с новыми вопросами в рамках одной и той же системы оценки, его производительность также значительно колеблется. В новой версии JevBench v1.4 добавлено 308 закрытых сложных вопросов, и точность Jev упала с 86.6% на открытых вопросах до 36.7%, в то время как для сравнения модель DeepSeek V4.1 Flash, использующая режим размышлений, осталась на уровне 94.8%.
Высокие баллы, которые Jev ранее получил на открытых вопросах, не могут автоматически переноситься на неизвестные сложные тесты.
Когда тестирование продолжает двигаться к реальной бизнес-миграции, результаты Jev также вызывают смешанные чувства. Положительный пример приходит из обнаружения инъекций подсказок в Agent Journal, где точность Jev на исходном тестовом наборе составила 83.65%, а при прямой миграции на другой тестовый набор, содержащий более двух тысяч внешних данных, точность даже повысилась до 95.58%, что значительно превышает традиционные базовые модели.
Это указывает на то, что в некоторых специфических задачах он действительно может адаптироваться к изменениям источников данных.
Но в более сложных логических бизнесах такая обобщаемость часто оказывается неэффективной. Scarif Labs использовал его для определения безопасности обновлений программного обеспечения. Когда модель переносилась из одной программной экосистемы в другую, способность Jev различать безопасные и опасные обновления (AUROC) снизилась с 0.851 до 0.605 (близко к случайному угадыванию 0.5).
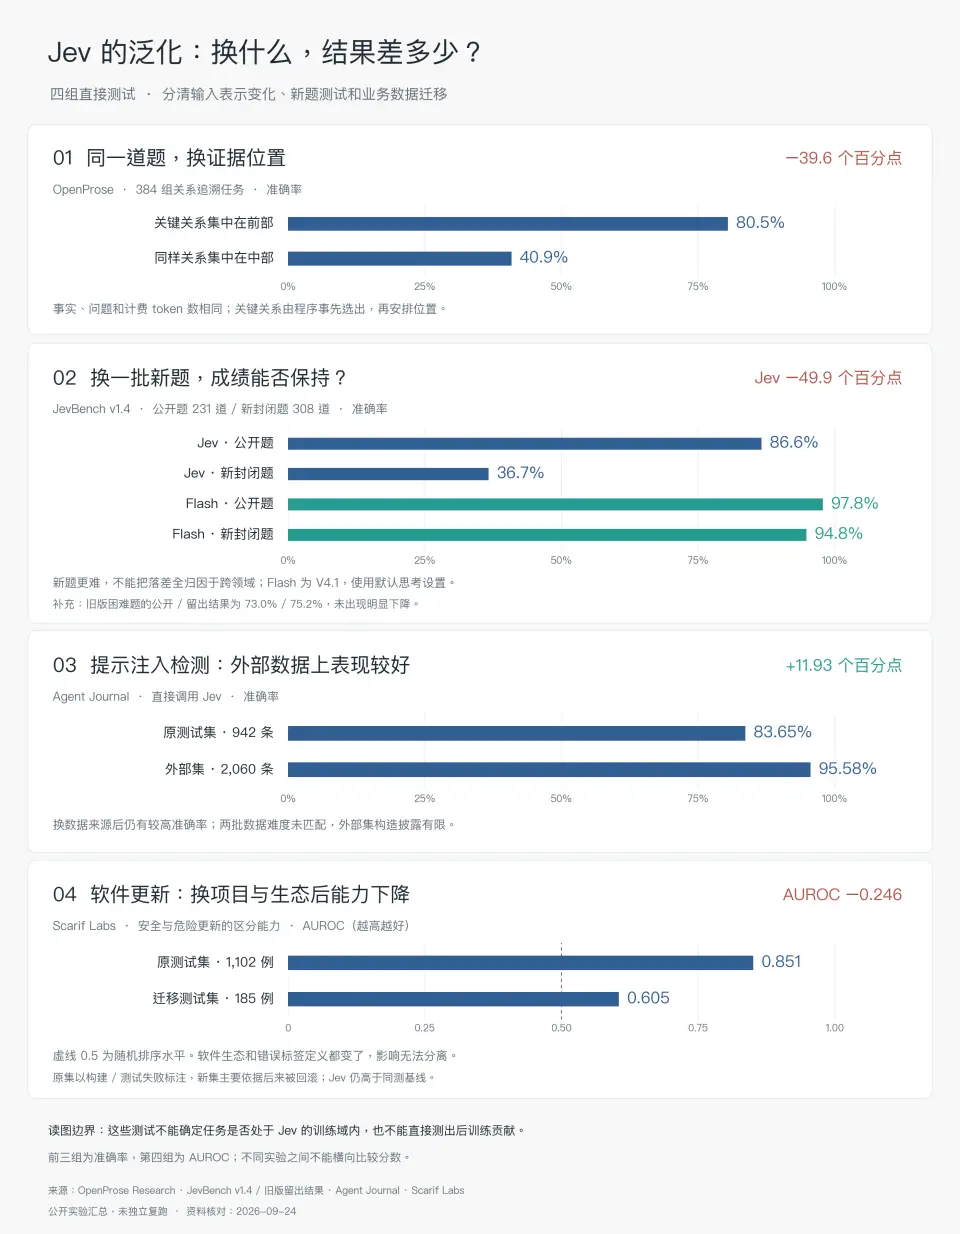
Таким образом, мы можем сказать, что на данный момент обобщаемость Jev должна быть довольно ограниченной и сомнительной. Он все еще далек от стандартов универсальной обобщаемости.
Поскольку Jev не преодолел эти два барьера универсальности, где же мы сейчас можем его использовать?
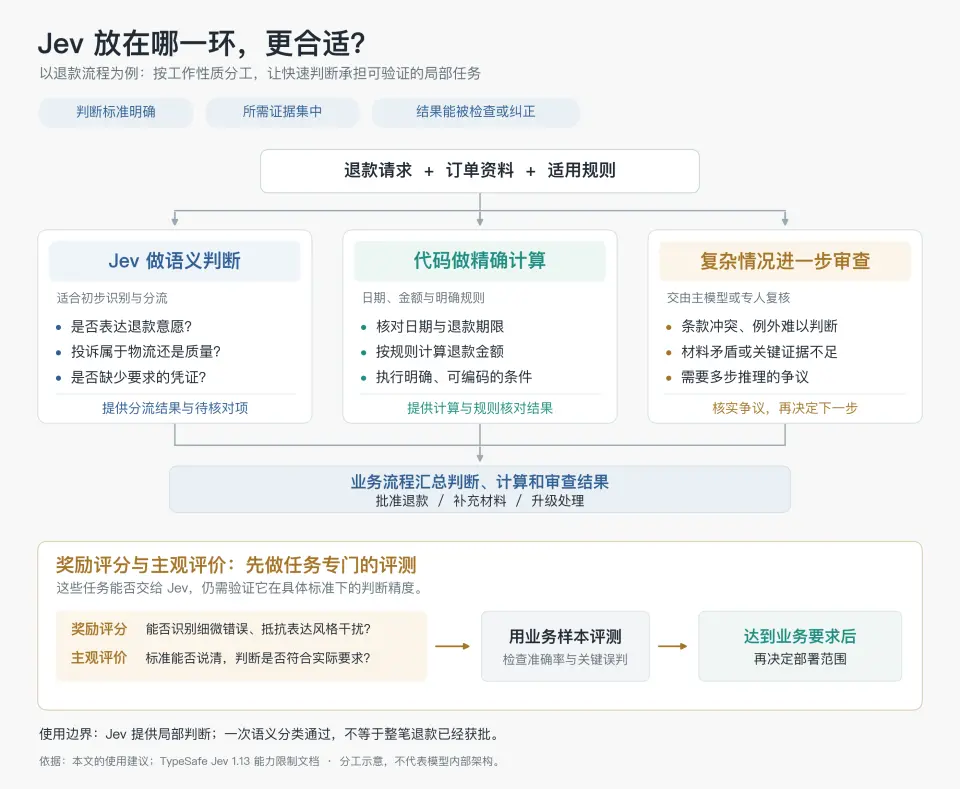
Более подходящая позиция — это разместить Jev в этапах с четкими стандартами, сосредоточенными доказательствами и проверяемыми или корректируемыми результатами.
Все еще используя возврат средств в качестве примера. Определение, выразил ли пользователь желание вернуть деньги, касается ли жалоба логистики или качества товара, нужно ли предоставить дополнительные доказательства — все это можно проверить отдельно. Эти вопросы возникают часто, обычно не требуют генерации объяснений и не нужно каждый раз заставлять основную модель проводить рассуждения. Jev может взять на себя предварительную сортировку.
Но для одобрения возврата ситуация меняется. Нужно ли учитывать срок, необходимо сверить дату и сумму возврата, нужно рассчитывать по правилам, сталкиваться с конфликтами условий или исключительными ситуациями, и проводить дальнейшую проверку. TypeSafe также рекомендует передать математические операции и сравнение дат коду и по возможности минимизировать многослойные зависимости в суждениях.
Такое разделение труда позволяет использовать его скорость в подходящих местах.
Что касается более точных применений, таких как модели вознаграждения, то часто необходимо оценить именно те ответы, которые на первый взгляд разумны, но на самом деле ошибочны. Модель также должна различать тонкие различия и противостоять влиянию стиля выражения.
А для задач, где правила трудно определить, например, содержащих сравнительно субъективные оценки, по крайней мере, стоит сначала протестировать точность Jev, прежде чем развертывать.
В это время Jev может быть кандидатом, но пользователи все равно нуждаются в специализированной оценке задачи.
Кроме того, есть один аспект, который нельзя упустить. Быстрая реакция Jev не означает, что после его добавления весь агент станет быстрее.
Если он может заранее обработать партию простых запросов, позволяя этим запросам не вызывать основную модель, скорость и преимущества по затратам могут реализоваться.
Но если каждый раз сначала вызывать Jev, а затем все равно вызывать ту же основную модель, то новые суждения должны сэкономить достаточно последующей работы, чтобы компенсировать собственные временные и финансовые затраты.
В наборе экспериментов по извлечению памяти агентов на GitHub система внедрила Jev для определения полезности извлеченной информации. Чтобы избежать того, чтобы Jev ошибочно отбрасывал полезную информацию, разработчики были вынуждены многократно корректировать критерии оценки.
Хотя в конечном итоге все 20 обычных случаев были одобрены, цена была ясна: общая задержка системы увеличилась с 649 миллисекунд до 1087 миллисекунд, а стоимость за тысячу вызовов увеличилась более чем в два раза.
Если основная модель уже обладает способностью фильтровать ответы из сложных материалов, то добавление Jev в качестве оценщика не только увеличивает время ожидания, но и несет риск упустить ключевые доказательства из-за ошибочного суждения.
05
Насколько действительно революционен Jev?
В конце обсуждения основной вопрос, который оставляет нам Jev, заключается в том, чему он на самом деле учится?
По идее, модель, предназначенная для суждений, учит представлениям, основываясь на новых фактах, чтобы делать эффективные суждения.
Это почти одно из самых сложных представлений.
Универсальные суждения требуют одновременного использования множества способностей, и нельзя считать, что если в итоге выводится только одна вероятность, это легче, чем генерировать ответы.
Возьмем возврат средств в качестве примера. Увидев «Я хочу вернуть деньги», распознавание намерения возврата в основном зависит от понимания языка. Но когда спрашивают «Согласно этой политике, следует ли одобрить возврат?», модель должна понять политику, сопоставить дату покупки, состояние товара и другие факты с конкретными условиями, а затем обработать исключения.
Это, по сути, базовая способность языковой модели, стоящей за Jev.
Последний вопрос «Поможет ли возврат удержать этого клиента?» требует предсказания последствий поведения. Это именно та часть, которую модель должна обучить.
Ей нужно научиться, какие факты влияют на результат, при каких условиях они влияют, и сохраняются ли эти отношения в другом контексте.
Все три вопроса могут выдавать «вероятность да», но знания и вычисления, необходимые для этого, различаются.
Чтобы преодолеть расстояние от «предсказания того, как другие будут судить» до «надежного предсказания последствий действий», сколько данных и обучения нам на самом деле нужно?
По крайней мере, для человека комплексное суждение — это самая сложная вещь для обучения. Это практически так же сложно, как упомянутые в нашей предыдущей статье вкусы и комплексные утилитарные вычисления.
Поэтому я очень сомневаюсь, что эта раскрытая в статье методология обучения может поддерживать такое сложное представление.
Конечно, мы можем рассматривать Jev как чрезвычайно изобретательный инженерный инструмент.
В четких правилах и с полными материалами бизнес-процессов он может значительно сократить время ожидания и затраты на вычисления, его ценность не вызывает сомнений.
Но прежде чем доказать, что он действительно усвоил какие-то универсальные правила суждения, рано наделять его короной «парадигмальной революции».
 Предупреждение о рисках
 Предупреждение о рисках