구글 제미니 결정 1 발표: 단어별 생성하지 않고, 한 번의 요청으로 1000개의 질문 판별
 핵심 관점

 구글이 첫 번째 의사결정 모델 Gemini Decision 1을 발표했습니다: 단어를 하나하나 생성하지 않고, 한 번의 전방 전파로 최대 1000개의 질문에 점수를 매길 수 있으며, 엔드 투 엔드 지연 시간은 150~250 밀리초, 백만 개의 입력 토큰당 단 0.10 달러입니다; 9개의 벤치마크에서 7개의 1위를 차지했으며, 최고 정확도는 92.2%입니다.
저자|동매(AI 전선)
AI 산업 전체가 누가 더 많은 토큰을 생성할 수 있는지, 누가 더 강력한 추론 능력을 가지고 있는지를 겨루고 있을 때, 구글은 단어별로 답변을 생성하지 않는 새로운 모델을 출시했습니다.
방금 구글은 Gemini Decision 1을 공식 발표하고, 해당 모델로 구동되는 Gemini Decisions API를 출시했습니다. 전통적인 생성형 대모델과는 달리, 이 모델은 빠른 결정을 내리기 위해 설계되었으며, 개별 토큰을 생성할 필요 없이 한 번의 전방 전파를 통해 미리 설정된 후보 답변에 점수를 매깁니다.
구글 CEO 순다르 피차이는 X 플랫폼에 Gemini Decision 1의 주요 능력을 소개하는 글을 올렸습니다. 그는 다음과 같이 썼습니다:
오늘, 우리는 Google AI Studio에서 Gemini Decisions API를 공식 출시하며, 새로운 Gemini Decision 1 모델이 지원합니다.
전통적인 모델이 개별 토큰으로 텍스트를 생성하는 것과 달리, 이 모델은 폐쇄된 옵션 집합 내의 결정 작업을 위해 특별히 설계되었습니다. 이 모델은 한 번의 처리 과정에서 텍스트, 이미지, 오디오, 비디오 및 PDF에서 최대 1000개의 질문에 점수를 매길 수 있습니다.
다음은 주목할 만한 몇 가지 세부 사항입니다:
· 세 가지 결정 유형을 지원합니다: 예/아니오 판단, 다중 선택(최대 255개 옵션), 및 기준에 따른 점수 매기기;
· 백만 개 입력 토큰당 가격은 단 0.10달러이며, 출력 토큰 비용은 없고, 비용은 약 Flash-Lite의 5분의 1입니다;
· 다수의 기준 평가에서 선두를 차지하며, 가장 낮은 보정 오류를 가지고 있습니다.
구글 내부 팀은 이미 이 기술을 사용하기 시작했습니다.
과거에 개발자들이 AI에게 이메일이 스팸인지 판단하거나 특정 작업을 어떤 에이전트에게 맡겨야 하는지를 결정하고자 할 때, 종종 생성형 대모델을 호출한 후 모델이 생성한 텍스트에서 결과를 추출해야 했습니다. Gemini Decision 1은 단어별 디코딩 단계를 생략합니다.
개발자는 입력 내용, 판단할 질문 및 후보 옵션을 제공하기만 하면, 모델은 해당 판단 결과, 확률 및 신뢰도를 직접 반환할 수 있습니다.
이는 본래 분류, 점수 또는 선택 결과만 필요했던 작업에 대해 AI가 전체 텍스트 생성 프로세스를 완료할 필요가 없음을 의미합니다.
구글이 발표한 데이터에 따르면, Gemini Decision 1은 한 번의 요청으로 최대 1000개의 독립적인 질문을 처리할 수 있으며, 텍스트, 이미지, 오디오, 비디오 및 PDF와 같은 다중 모달 입력을 지원하며, 엔드 투 엔드 지연 시간은 단 150~250밀리초입니다.
가격도 상당히 공격적입니다: 백만 개 입력 토큰당 단 0.10달러, 출력 토큰은 무료입니다. 구글이 발표한 동일한 기준 테스트에서, 호출 비용은 Gemini 3.5 Flash-Lite보다 거의 5배 낮습니다.
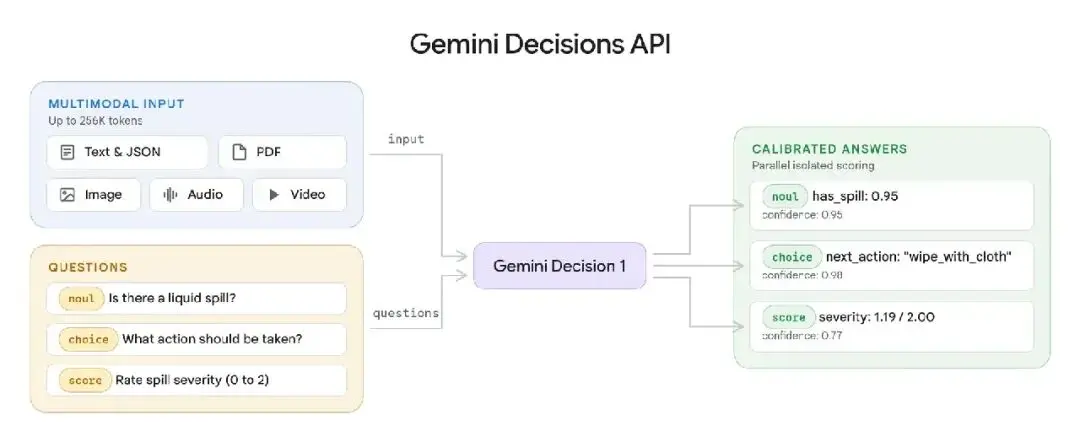
더욱 주목할 점은, 이것이 단순히 선택 질문에 답하기 위한 모델이 아니라는 것입니다. 구글은 이미 AI 모델 라우팅, 에이전트 도구 선택, 제품 설계 및 보안 검사를 포함한 다양한 시나리오에 이를 사용하고 있으며, AI 시스템 내에서 판단 및 결정을 담당하는 기본 구성 요소로 만들고자 하고 있습니다.
한 번에 1000개의 질문 처리, 최대 255개 옵션
구글이 발표한 기술 소개에 따르면, Gemini Decision 1은 세 가지 핵심 결정 능력을 제공합니다.
첫 번째는 예/아니오(이진 판단)입니다. 예를 들어, 이미지에 안전 위험이 존재하는지 판단하거나, 텍스트가 정해진 규칙을 위반하는지 판단합니다. 모델은 해당 조건이 성립할 확률을 제공합니다.
두 번째는 다중 선택입니다. 개발자는 2~255개의 후보 옵션을 미리 설정할 수 있으며, 모델은 가장 조건에 부합하는 답변을 선택할 뿐만 아니라, 각 후보 옵션의 정규화된 확률도 반환합니다.
세 번째는 순서 기준 점수 매기기입니다. 개발자는 서로 다른 등급의 점수 기준을 정의할 수 있으며, 모델은 입력 내용을 평가하고 연속 가중 점수 및 각 등급의 확률을 반환합니다.
세 가지 작업은 한 번의 요청에서 혼합하여 실행할 수 있습니다.
구글은 간단한 예시를 제공합니다: 모델에 사무실 차수대의 사진을 업로드하고, 설명 텍스트를 첨부하여, 테이블에 액체가 흘러넘쳤는지, 어떤 청소 조치를 취해야 하는지, 현장의 심각도를 판단하도록 요청합니다.
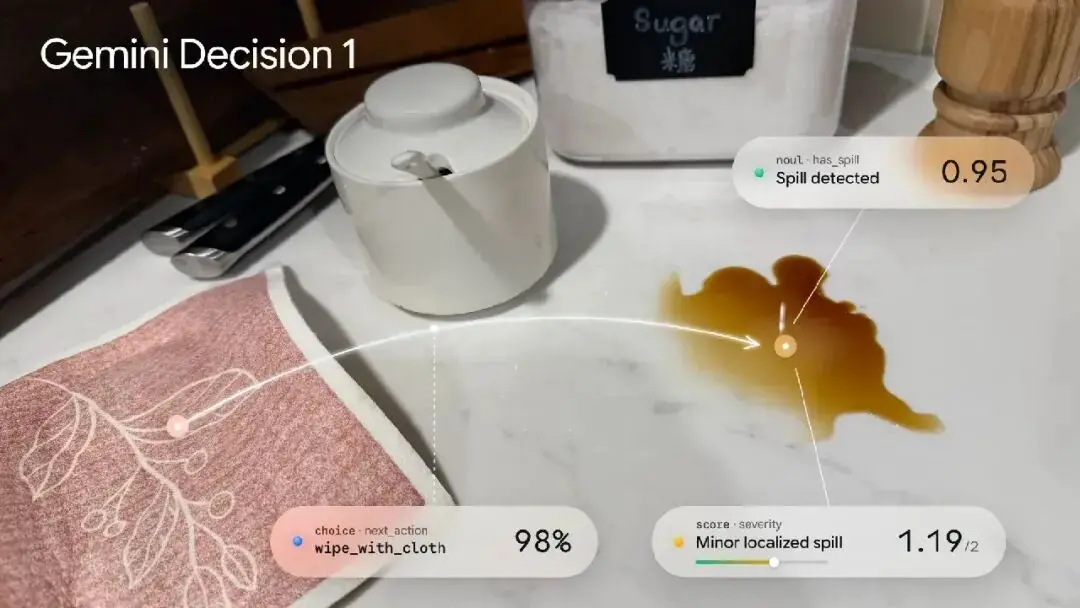
전통적인 방법은 여러 개의 분류기를 설계하거나 생성형 대모델을 통해 다양한 프롬프트 작업을 수행해야 할 수 있습니다. Gemini Decision 1은 한 번의 요청으로 이러한 판단을 완료할 수 있습니다.
또한, 모델은 최대 256K 토큰의 다중 모달 입력 컨텍스트를 지원합니다. 기업 환경에서는 개발자가 통화 녹음과 고객 정보를 함께 분석하거나, 보험 청구 문서와 현장 사진을 결합하여 판단할 수 있음을 의미합니다.
각 결정은 0~1의 신뢰도를 제공하여 시스템이 불확실한 결과를 다른 모델이나 인력 검토에 넘길 수 있도록 합니다.
Gemini Decision 1의 또 다른 경쟁력은 속도와 비용입니다.
구글의 공식 소개에 따르면, 에이전트 라우팅, 추론, 정렬 및 다중 모달 이해를 포함한 기준 평가에서 Gemini Decision 1은 선두를 차지하며, 가장 낮은 보정 오류를 기록했습니다.
16K 토큰을 초과하지 않는 테스트 컨텍스트에서, 모델 계산 단계의 중앙 지연 시간은 50~100밀리초를 유지하며, 엔드 투 엔드 지연 시간은 약 150~250밀리초입니다. 단일 요청에 포함된 질문 수가 1개에서 100개로 증가하더라도 지연 시간은 기본적으로 안정적으로 유지됩니다.
공식적으로 사용되는 공동 기준 테스트 세트에서, Gemini Decisions API의 비용은 Interactions API를 통해 Gemini 3.5 Flash-Lite를 호출하는 것보다 거의 5배 낮습니다.
9개 테스트에서 7개 1위, 정확도 92.2%
구글은 이번에 Gemini Decision 1을 발표하면서 주목할 만한 모델 비교 성적표를 공개했습니다.
일반적으로 범용 대모델과 비교하는 것과는 달리, 구글은 이번에 세 가지 경쟁 제품을 선택했습니다: OpenAI의 GPT-6 Luna, 분류 결정을 위해 특별히 설계된 TypeSafe Jev 1.14, 그리고 자사의 Gemini 3.5 Flash-Lite입니다.
결과를 보면, Gemini Decision 1은 9개 기준 테스트에서 7개 1위를 차지했으며, 확률 보정에서도 선두를 달리고 있지만, 나머지 두 개 테스트와 총 호출 비용에서는 여전히 경쟁자가 더 나은 성과를 보였습니다.
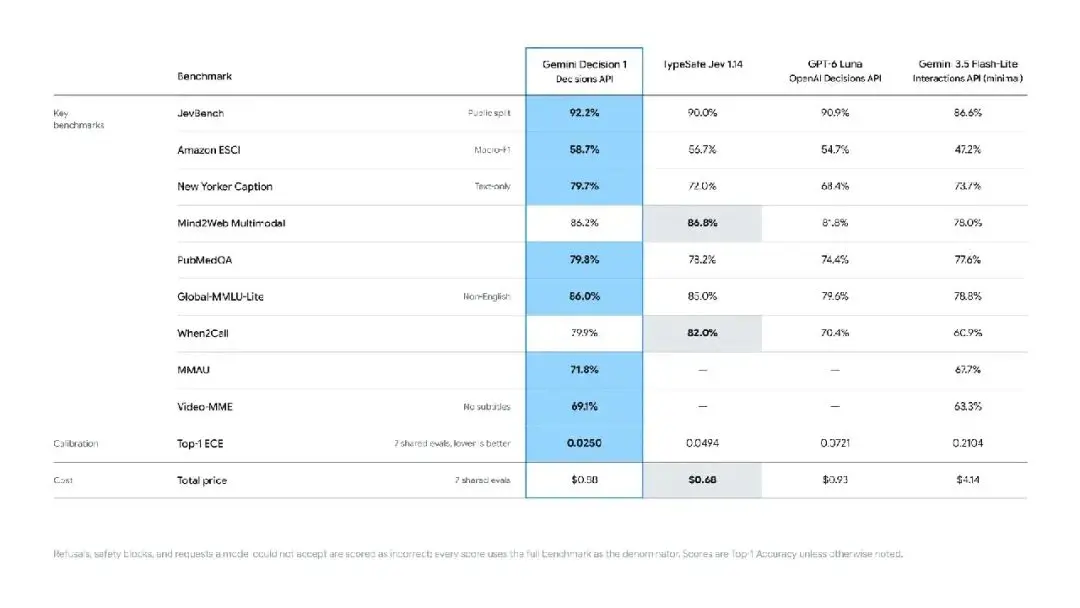
JevBench 테스트에서 Gemini Decision 1은 92.2%의 정확도를 기록하며, GPT-6 Luna의 90.9%, TypeSafe Jev 1.14의 90.0%, Gemini 3.5 Flash-Lite의 86.6%를 초과했습니다.
Amazon ESCI 상품 검색 관련성 테스트에서 Gemini Decision 1은 58.7%의 Macro-F1 점수를 기록하며, GPT-6 Luna보다 4% 포인트 높고, Flash-Lite보다 11.5% 포인트 높습니다.
New Yorker Caption 테스트에서는 차이가 더욱 확대되었습니다. Gemini Decision 1은 79.7%의 성적을 기록했으며, GPT-6 Luna는 68.4%로 두 모델 간의 차이는 11.3% 포인트입니다. 이 테스트는 만화 자막의 이해와 선택을 포함하며, 모델의 맥락 이해 및 후보 내용 판단 능력을 시험합니다.
의학 질문 응답 테스트인 PubMedQA에서도 Gemini Decision 1은 1위를 차지하며, 점수는 79.8%로 GPT-6 Luna의 74.4%를 초과했습니다.
다국어 테스트인 Global-MMLU-Lite의 결과도 유사합니다. Gemini Decision 1은 86.0%를 기록했으며, GPT-6 Luna는 79.6%로 두 모델 간의 차이는 6.4% 포인트입니다.
그러나 구글은 전면적인 우위를 달성하지 못했습니다.
Mind2Web Multimodal 테스트에서 TypeSafe Jev 1.14는 86.8%의 성적으로 1위를 차지했으며, Gemini Decision 1은 86.2%로 0.6% 포인트 뒤처졌습니다.
도구 호출 판단 능력을 시험하는 When2Call 테스트에서는 TypeSafe Jev 1.14의 우위가 더욱 뚜렷해지며, 점수는 82.0%, Gemini Decision 1은 79.9%입니다.
이 결과는 특히 주목할 만합니다. 도구 선택 및 호출 시점 판단은 Gemini Decision 1이 중점적으로 목표로 하는 에이전트 응용 시나리오 중 하나이지만, 이 테스트에서는 전용 결정 모델인 TypeSafe Jev가 여전히 우위를 점하고 있습니다.
또한, 오디오 이해 테스트인 MMAU와 비디오 이해 테스트인 Video-MME에서 Gemini Decision 1은 각각 71.8%와 69.1%를 기록하며, 모두 Flash-Lite보다 높습니다.
정확도보다 더 주목할 점은 구글이 이번에 특별히 강조한 확률 보정 능력입니다.
Top-1 ECE(예상 보정 오류) 테스트에서 Gemini Decision 1의 보정 오류는 단 0.0250이며, GPT-6 Luna는 0.0721, TypeSafe Jev 1.14는 0.0494, Flash-Lite는 0.2104에 달합니다.
다시 말해, 이 평가 그룹에서 Gemini Decision 1의 보정 오차는 GPT-6 Luna보다 약 65% 낮고, Flash-Lite보다 약 88% 낮습니다.
이 지표는 에이전트 시스템에 특히 중요합니다.
예를 들어, 에이전트가 특정 코드에 보안 취약점이 있는지 판단해야 할 때, 모델이 제공하는 결과는 단순히 "존재" 또는 "존재하지 않음"뿐만 아니라 확률 값도 포함될 수 있습니다. 시스템은 확률과 실제 정확도 간의 관계에 따라 자동으로 행동을 취할지, 아니면 인력에게 추가 검토를 맡길지를 결정할 수 있습니다.
구글이 이미 사용 중: 에이전트 라우팅 지연 최대 40% 감소
일부 새로운 모델이 단순히 기준 성적을 보여주는 것과 달리, 구글은 이번에 Gemini Decisions API가 내부 제품에서 어떻게 사용되는지를 공개했습니다.
가장 주목할 만한 것은 Gemini Notebook입니다.
구글은 Decisions API를 실시간 모델 라우터로 활용하여 사용자 요청의 복잡성에 따라 적절한 모델 등급과 사고 강도를 선택하고 있습니다. 일상적인 간단한 문제에 직면했을 때, 시스템은 비용이 낮고 응답이 빠른 모델을 우선 호출할 수 있습니다; 복잡한 추론 작업이 발생하면 요청을 더 강력한 모델에 전달합니다.
구글은 이러한 동적 라우팅 방식을 통해 일상적인 쿼리의 지연을 최대 40%까지 줄일 수 있다고 밝혔습니다.
이러한 설계는 현재 에이전트 시스템의 발전 추세와 밀접한 관련이 있습니다. 에이전트가 작업을 완료할 때, 종종 다음 단계의 행동을 지속적으로 판단해야 합니다. 예를 들어 어떤 도구를 선택할지, 어떤 모델을 호출할지, 또는 인력 개입이 필요한지를 결정해야 합니다.
모든 간단한 결정을 대형 생성 모델에 맡기면 시스템은 추가적인 지연과 비용을 감당해야 합니다. 전문적인 결정 모델은 또 다른 선택지를 제공합니다: 상대적으로 간단하고 옵션이 명확한 판단을 저지연 모델에 처리하게 하고, 복잡한 작업은 범용 대형 모델에 맡기는 것입니다.
Gemini Notebook 외에도 구글은 다른 세 가지 응용 방향을 공개했습니다.
Google Stitch에서는 새롭게 출시된 Rapid Canvas 실험 기능이 Decisions API를 활용하여 몇 초 만에 상호작용 가능한 제품 프로세스 와이어프레임을 생성하고, 사용자가 음성이나 클릭으로 보낸 수정 지시에 빠르게 응답합니다. 사용자가 디자인 방향을 확인한 후, 페이지를 완전한 Stitch 작업 흐름으로 전환하여 추가 개선을 진행할 수 있습니다.
Google Labs의 CC 제품에서는 Decisions API가 200개 이상의 이모지 옵션 중에서 적절한 감정 반응을 빠르게 선택하는 데 사용됩니다. Google Search 내부에서는 구글이 이 API를 활용하여 MCP 도구의 보안 검사 레이어를 구축하고, 잠재적인 적대적 행동 및 콘텐츠를 식별합니다.
참고 링크: Gemini Decisions API 공식 블로그
 위험 경고 위험 경고