








Только что DeepSeek объявила концепцию следующего поколения agent harness
 Ключевые тезисы


 Данная статья является обсуждением архитектурных идей, ориентированных на инженерную практику, и не является представлением существующих функциональных возможностей продукта DeepSeek Harness.
Исходное название: Исследование дизайна Super-agent: Путь к более автономным системам агентов
Исходный автор: Продуктовый отдел DeepSeek
1. Super-agent
За последний год одноцелевые агенты, представленные Coding Agent, доказали, что модели могут использовать инструменты для решения сложных задач, и все меньше нуждаются в постоянном мониторинге и вмешательстве человека. В то же время способности моделей к многопользовательскому взаимодействию также улучшаются, что делает возможной организацию и планирование между сессиями. С уменьшением участия человека в базовом исполнении, его роль постепенно перемещается на более высокий уровень принятия решений и проверки.
Это улучшение способностей модели также породило новые формы применения. В последнее время начали активно появляться персональные помощники, которые напрямую подключаются к повседневным сообщениям, расписаниям, электронной почте и рабочим платформам, постоянно наблюдая за потоком информации и помогая в обработке дел. Эта постоянная онлайн-работа, основанная на событиях, не ограничивается личными сценариями; персональные помощники — лишь один из типов приложений; в коммерческих сценариях, таких как разработка программного обеспечения, они также имеют большую ценность.
Тем не менее, существующий основной дизайн агентов все еще не может поддерживать эту модель на уровне многозадачности и командного взаимодействия. Рабочая модель агента по-прежнему основывается на единой сессии, и разные сессии независимы друг от друга. Когда пользователь параллельно продвигает несколько задач, ему необходимо вручную переключаться и запоминать контекст каждой сессии, а, по нашим наблюдениям, один человек обычно может одновременно отслеживать только 3-5 активных сессий. В таком дизайне предел одноцелевой задачи зависит от возможностей модели, а предел многозадачности — от внимания человека.
Если просто расширить существующий локальный одноразовый агент с помощью CLI, MCP или внешних соединителей, агент, хотя и сможет подключаться к внешним сообщениям, все равно будет ограничен проблемами синхронной блокировки одноразовой сессии, путаницы контекста многозадачности и остановки работы при отключении локального устройства, что требует значительного ручного обслуживания.
Чтобы преодолеть эти ограничения, необходимо разорвать связь между агентом и одноразовой ручной сессией, сделав его непрерывным объектом, который может поддерживать контекст между сессиями, одновременно продвигая несколько сложных задач без взаимных помех. Мы называем эту форму агента и его системную архитектуру Super-agent.
Например, в нашем внутреннем экземпляре Super-agent, работающем на DeepSeek Harness, одна и та же задача разработки может непрерывно продвигаться между IM и GitHub; этот экземпляр также будет постоянно наблюдать за отзывами в публичном чате, активно определяя коренные причины и отправляя исправляющий Pull Request, даже если никто не упоминает его:
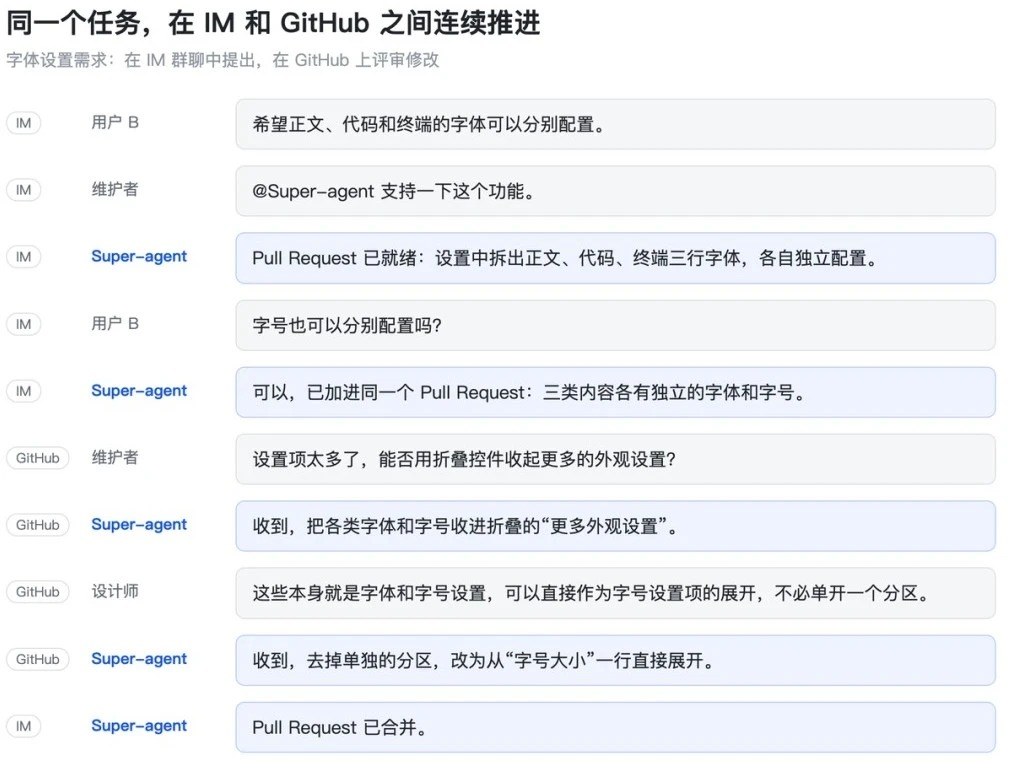
Одна и та же задача непрерывно продвигается между IM-чатом и рецензией Pull Request на GitHub
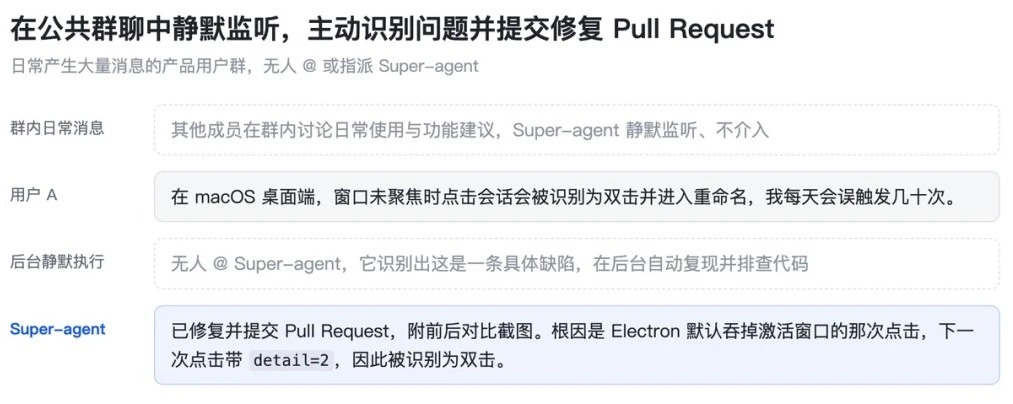
Постоянно следит за публичным чатом, активно идентифицируя дефекты и отправляя исправляющий Pull Request, даже если никто не упоминает его
Конкретно, мы считаем, что Super-agent обладает следующими четырьмя основными характеристиками:
Непрерывность: Пользователь может взаимодействовать с ним напрямую в знакомых рабочих интерфейсах, таких как IM-чат и комментарии на GitHub, ощущая, что существует только один агент, не задумываясь о том, есть ли информация Y в контексте «Сессии X». Например, если пользователь сначала предлагает использовать вариант A в IM, а затем меняет его на вариант B в комментарии Pull Request на GitHub, он сможет понять и скорректировать направление выполнения.
Эффективность: Ответы на взаимодействия быстры, и одновременно могут выполняться несколько сложных задач с высоким качеством. Не нужно ждать завершения предыдущей команды или задачи, чтобы принять следующую инструкцию.
Активность: Не дожидаясь, пока пользователь выдаст команды по одной, он может постоянно наблюдать за событиями в окружении и активно продвигать важные дела, оставаясь тихим, когда вмешательство не требуется.
Долговечность: Всегда онлайн, напрямую подключается к реальной рабочей среде пользователя и автоматически восстанавливается при возникновении аномалий в процессе длительной работы.
Один ReAct Loop не может одновременно поддерживать все четыре характеристики; на базовом уровне требуется соответствующая архитектура. Похожие ограничения дизайна приведут к схожим архитектурным решениям. Мы считаем, что независимо от того, предназначен ли агент для личного использования или для коммерческих сценариев, таких как разработка программного обеспечения, если цель состоит в создании системы, которая постоянно онлайн и реагирует на события окружающей среды, то на базовом уровне может быть использована схожая архитектура. Кроме того, многие проблемы, с которыми сталкивается этот процесс, имеют высокую степень схожести с проблемами, которые долго обсуждались в традиционных компьютерных системах, поэтому многие классические идеи дизайна в компьютерных системах также применимы здесь.
В конкретной реализации эта архитектура может иметь разные варианты, но мы считаем, что следующие пять модулей составляют основную структуру, поддерживающую вышеуказанные четыре основные характеристики: через двухуровневую архитектуру (раздел 2) обеспечивается непрерывное взаимодействие и эффективная параллельность, через событийный подход (раздел 3) достигается активный ответ, через взаимодействие, ориентированное на человека (раздел 4), одновременно достигается непрерывность и эффективность, а через разделение вычислений, состояния и окружения (раздел 5) и Watchdog (раздел 6) реализуется кросс-устройство постоянное присутствие и самовосстановление.
Ниже показана общая системная архитектура Super-agent, номера модулей [2] до [6] соответствуют разделам 2 до 6:
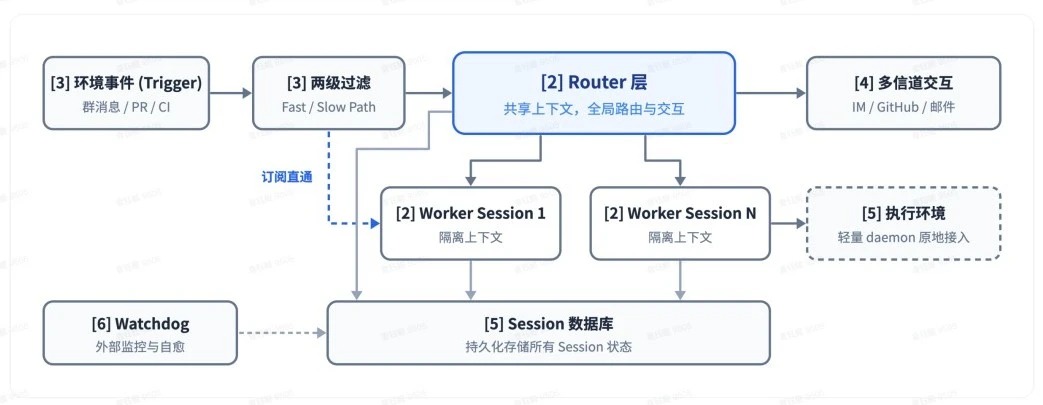
Общая системная архитектура Super-agent, номера [2] до [6] соответствуют разделам 2 до 6
2. Двухуровневая архитектура
Чтобы одновременно реализовать непрерывное взаимодействие между каналами и эффективную параллельность многозадачности, система на базовом уровне сталкивается с фундаментальным компромиссом между непрерывностью и пропускной способностью (Trade-off).
Если каждое событие обрабатывается одной и той же сессией, хотя контекст будет наиболее непрерывным, но ограничено максимальной скоростью последовательного выполнения одного ReAct Loop, что приводит к длительному времени выполнения задач и низкой пропускной способности, а также к смешиванию промежуточных деталей многозадачности, что также повлияет на качество выполнения.
С другой стороны, если каждое событие обрабатывается в новой независимой сессии, хотя параллельная пропускная способность будет максимальной, но если задачи не полностью независимы, отсутствие глобального контекста приведет к разрыву результатов каждой сессии, а также к путанице в взаимодействии, когда несколько сессий отвечают пользователю.
Чтобы учесть непрерывность и пропускную способность, мы можем разделить «поддержание глобальной непрерывности» и «высокую параллельную производительность» на два разных уровня: постоянный уровень Router (раздел 2.1) будет отвечать за взаимодействие с человеком и глобальную координацию, а уровень Worker (раздел 2.2) с изолированным контекстом будет параллельно выполнять конкретные задачи, как показано на рисунке ниже:
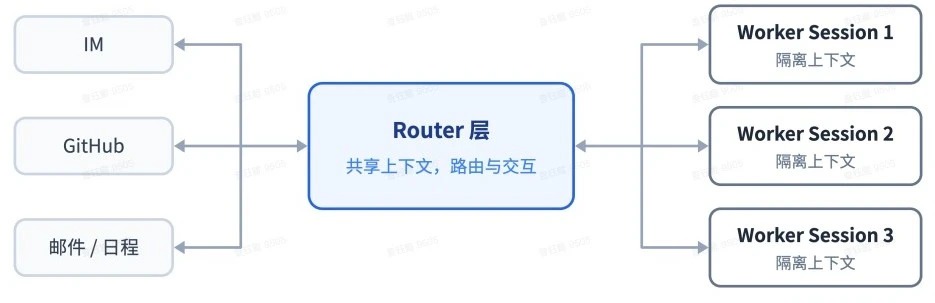
Двухуровневая архитектура: уровень Router отвечает за маршрутизацию и внешнее взаимодействие, несколько сессий Worker изолированно и параллельно выполняют задачи
С помощью этой двухуровневой архитектуры система на базовом уровне берет на себя управление контекстом и параллельное выполнение, тем самым уменьшая присутствие сессий для пользователя, который всегда взаимодействует с одним и тем же Super-agent. С этой точки зрения, заставлять пользователя вручную управлять сессиями в значительной степени является наследием дизайна, перенесенного с базового LLM API; сессия должна быть реализацией системы, а не когнитивной нагрузкой для пользователя.
В существующем дизайне сессия одновременно несет ответственность за управление контекстом с технической стороны и управление проектом с пользовательской стороны. После декомпозиции продуктовой формы и базовой сессии управление проектом с пользовательской стороны больше не будет ограничено сессиями, и то, как предоставить пользователю взаимодействие и управление задачами, станет независимой продуктовой задачей. Мы обсудим этот вопрос позже.
Здесь «двухуровневая» — это логическое разделение обязанностей, каждая из уровней не обязательно должна ограничиваться одной сессией, а может иметь свою внутреннюю структуру. Далее будут представлены дизайн уровня Router и уровня Worker.
2.1 Уровень Router
Уровень Router — это постоянный глобальный уровень маршрутизации, отвечающий за все входящие взаимодействия с человеком. Вся информация и решения между задачами собираются на уровне Router, который выступает в роли глобальной точки последовательности (Sequence Point), координации и памяти. Чтобы избежать превращения этой глобальной точки в узкое место производительности системы, уровень Router по дизайну не выполняет конкретные задачи, а отвечает только за взаимодействие с человеком и распределение задач, даже может не иметь Bash инструментов.
Такая структура, при которой один центральный узел распределяет несколько исполнительных узлов, на первый взгляд похожа на обычную команду агентов, но акценты у них разные. Обычные команды агентов в основном используются для разбиения шагов и координации ролей внутри одного сложного задания, поскольку подзадачи обычно тесно связаны, руководитель команды часто должен глубоко понимать детали задания, планировать подзадачи и часто координировать участников, что создает значительную нагрузку на рассуждения. В Super-agent уровень Router обрабатывает только высокоуровневые связи и распределение задач, не вмешиваясь в разбиение внутри одной задачи; наоборот, если ограничить основной сеанс команды агентов с помощью подсказок, чтобы он не выполнял конкретные задачи, а только отвечал на внешние взаимодействия и распределял разные задачи для независимого продвижения участников, это также можно рассматривать как такую двухуровневую архитектуру. На основе нашего опыта, задачи уровня Router часто не так сложны, как предполагается, и использование более легких моделей часто может обеспечить баланс между скоростью и эффективностью.
Внутренне уровень Router также не обязательно должен ограничиваться одной сессией, и даже часть логики может не требовать вызова LLM. Мы выбрали наиболее прямую реализацию уровня Router в виде одной постоянной сессии LLM и обнаружили, что она не так легко становится узким местом производительности, как может показаться, потому что события окружающей среды, поступающие во время предыдущего цикла вывода (то есть триггеры из раздела 3), будут накапливаться и обрабатываться вместе в следующем цикле, образуя пакетную обработку (Batching), а дополнительные затраты на объединение обработки очень малы:
Когда поток внешних событий стабилен, триггеры поступают по одному в сессию Router, и в этот момент задержка ответа на одно событие невысока;
Когда события интенсивно поступают и в сессии маршрутизатора начинается очередь, несколько триггеров, накопившихся за предыдущий период вывода, автоматически объединяются и инъецируются в следующий вызов LLM. Сессия маршрутизатора выполняет легкие взаимодействия и распределение, каждый шаг обычно представляет собой длинный ввод и короткий вывод. Объединение нескольких накопленных триггеров в один вызов API LLM будет параллельно вычисляться на этапе предварительной загрузки, и увеличение времени одного запроса будет значительно медленнее, чем размер пакетной обработки. Поэтому в определенных пределах, чем больше накоплено, тем ниже время вывода на одно решение; верхний предел зависит от длины контекста и от того, сколько триггеров модель может точно обработать за один раз.
Мы количественно продемонстрируем эффект этой пакетной обработки в разделе 7.2. В дополнение к механизмам подписки и прямой передачи, которые будут представлены позже, а также цепочечному вызову (см. разделы 3.2 и 3.3), одна постоянная сессия маршрутизатора уже достаточно для поддержания непрерывности контекста в рамках текущего размера нашей команды.
Когда масштаб будет дальше увеличен и одна сессия действительно не сможет справиться, уровень маршрутизатора также может быть спроектирован как многоуровенная фильтрационная структура или горизонтально разделен (шардинг) на несколько сессий. В этом случае внутренний дизайн уровня маршрутизатора по сути представляет собой компромисс между непрерывностью и пропускной способностью. Чем мельче гранулярность разделения, тем выше параллельная пропускная способность уровня маршрутизатора, но память и непрерывность контекста между фрагментами будут ниже. Этот компромисс всегда будет существовать, пока проблема глобальной памяти не будет решена.
2.2 Уровень рабочих
Уровень рабочих состоит из сессий, ответственных за конкретное выполнение, каждая рабочая сессия изолирована по контексту, имеет полный набор инструментов для выполнения и сосредоточена на выполнении одной задачи в независимом контексте. Поскольку сессия рабочего напрямую определяет результаты задач и качество кода, обычно требуется настроить наиболее мощную модель.
Рабочие не взаимодействуют напрямую с людьми, их процесс вывода и вызовы инструментов не выводятся напрямую на внешние каналы, а сообщают о состоянии на уровень маршрутизатора, который централизованно отвечает пользователю, тем самым обеспечивая параллелизм и качество доставки, избегая путаницы, вызванной ответами нескольких сессий.
При параллельном выполнении нескольких задач каждый рабочий независимо продвигает задачи, и обычно рабочие одного уровня не нуждаются в прямом общении друг с другом. Конфликты между несколькими рабочими часто возникают в одной и той же среде совместной работы, такой как Pull Request; если они подписаны на соответствующий поток, они получат одинаковые уведомления о событиях (см. раздел 3.2), что дает им возможность самостоятельно обнаруживать и решать конфликты, а небольшое количество межзадачной координации осуществляется через уровень маршрутизатора.
Подобно уровню маршрутизатора, каждая сессия рабочего также не обязана ограничиваться одной сессией: при выполнении сложной одноразовой задачи внутри рабочего можно создать Subagent или сам по себе быть командой агентов, что остается прозрачным для верхнего уровня маршрутизатора. Эта структура подходит как для сценариев совместной работы с кодом (одновременное продвижение нескольких независимых вопросов, рецензирование Pull Request и разработка функций без блокировок), так и для сценариев личного помощника: хотя личный помощник обычно предоставляет только одну страницу чата с одной сессией, когда пользователь обсуждает несколько различных тем в одном и том же окне чата, фронтенд отвечает за поддержание непрерывности взаимодействия, в то время как нижний уровень может назначать рабочих для каждой темы, параллельно продвигая задачи и подготавливая ответы.
3. Событийный драйв
Чтобы Super-agent обладал проактивностью, необходимо изменить способ управления системой. Основным вводом, управляющим агентом, больше не являются подсказки, вводимые человеком в сессии, а полуструктурированные события в окружающей среде. В Super-agent групповые сообщения, электронные письма и напоминания о расписании, комментарии к коду, результаты CI и другие события окружающей среды называются триггерами. Слушая и реагируя на триггеры, агент больше не должен, как в модели одной сессии, ждать, пока человек даст команду, чтобы выполнить действие.
Вокруг жизненного цикла события из окружающей среды, от его поступления до обработки, далее будут обсуждены четыре последовательных вопроса: как с помощью двухуровневой стратегии фильтрации программ и моделей отфильтровать большое количество шума (раздел 3.1), как с помощью механизмов подписки и прямой передачи маршрутизировать события к рабочим (раздел 3.2), как использовать Inline & Spill и цепочечный вызов для высокой плотности инъекции и по требованию вызова контекста (раздел 3.3), а также как использовать спекулятивное выполнение для предварительных действий на основе сигналов окружающей среды (раздел 3.4).
3.1 Фильтрация событий
После подключения к реальным группам чата и платформам кода поток событий окружающей среды демонстрирует заметные характеристики «высокий шум, низкая частота срабатывания», подавляющее большинство повседневных сообщений не требует вмешательства агента. Если для каждого события вызывать большую модель для оценки, задержка и вычислительные затраты будут непомерными. Заимствуя идею Fast Path / Slow Path из компьютерных систем, вывод большой модели можно рассматривать как гибкий, но дорогостоящий Slow Path, в то время как уже определенные и стабильные высокочастотные суждения, закрепленные в детерминированном коде, составляют низкозадерживающий, низкосточный Fast Path.
Поэтому первым шагом после поступления события в систему является фильтрация, цель которой — использовать детерминированные стратегии для отсеивания шума перед вызовом большой модели, передавая на оценку только те кандидаты-события, которые требуют семантического понимания. Мы используем двухуровневую фильтрационную механику, сочетающую программные стратегии и большую модель:
Программный уровень стратегии (как Fast Path): в зависимости от источника события, диапазона группы, белого списка пользователей или роботов и других детерминированных условий, быстро проверяется доступ через код, например, устанавливаются разные правила для разных источников: «отвечать только на явные запросы», «как кандидаты-события» или «прямо игнорировать», отсекая большинство нерелевантных сообщений перед вызовом модели.
Семантический уровень стратегии (как Slow Path): кандидаты-события, прошедшие проверку на программном уровне, передаются LLM, которая решает, нужно ли действовать, основываясь на стратегии и контексте, написанных с помощью подсказок. Семантический уровень также служит точкой расширения для естественного языка, удобной для включения или добавления новых стратегий в любое время с помощью подсказок, как показано на следующем изображении:
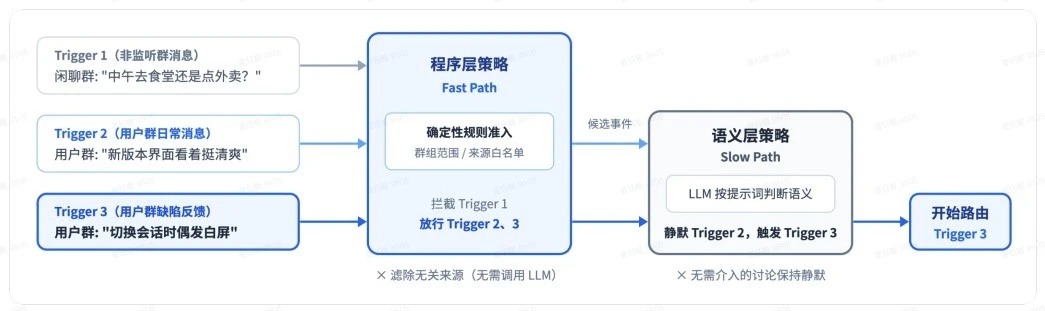
Двухуровневая фильтрация: сначала программный уровень стратегии отсекает большинство нерелевантных сообщений, затем семантический уровень стратегии принимает решение.
3.2 Маршрутизация событий
Глобальный уровень маршрутизатора, введенный в разделе 2, отвечает за поддержание непрерывности между каналами, но если каждое последующее событие, которому назначена задача, все еще должно передаваться через уровень маршрутизатора, этот глобальный узел все равно будет испытывать большую нагрузку, увеличивая задержку системы. Поэтому Fast / Slow Path также применимы к маршрутизации событий после фильтрации. Глобальный уровень маршрутизатора отвечает только за холодный старт новых задач и координацию между задачами, в то время как последующие события с установленными отношениями принадлежности отправляются напрямую в соответствующие сессии рабочих без необходимости повторной передачи через уровень маршрутизатора.
В реальном рабочем процессе последовательные события, происходящие в одном и том же Pull Request на GitHub, одной и той же теме IM или одной и той же цепочке электронных писем, составляют поток событий, то есть поток:
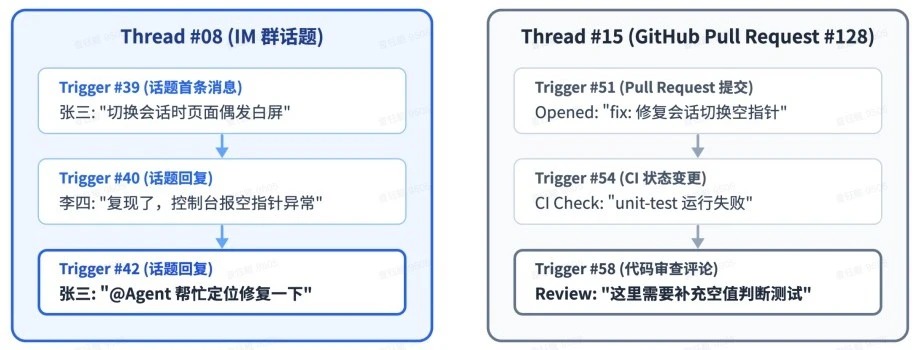
Пример потока: последовательные триггеры в одной и той же теме IM или одном и том же Pull Request составляют поток.
После создания сессии рабочего на уровне маршрутизатора на основе начального события потока, этот рабочий будет напрямую подписан на соответствующий поток, тем самым маршрутизируя события по двум путям, как показано на следующем изображении:
Подписанный (Fast Path): последующие события в одном и том же потоке передаются программе напрямую подписанному рабочему, без необходимости повторного вызова инструментов на уровне маршрутизатора. Если новое событие выходит за рамки текущей задачи, рабочий также может отменить подписку или вернуть ее на уровень маршрутизатора для повторного распределения.
Не подписанный (Slow Path): уровень маршрутизатора все еще может наблюдать все события для понимания глобального состояния, но отвечает только за оценку и распределение новых событий, которые еще не были подписаны.
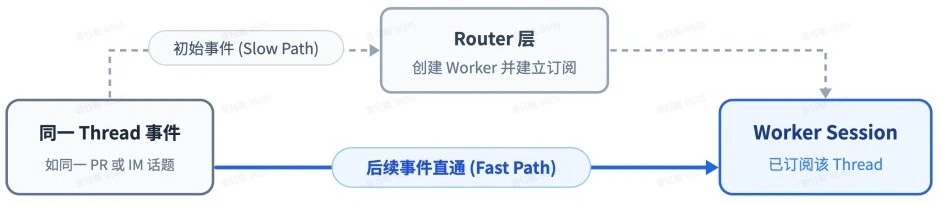
Подписка и прямая передача: начальное событие создает рабочего через уровень маршрутизатора и устанавливает подписку, последующие события в одном и том же потоке напрямую отправляются этому рабочему.
Кроме того, подписка между потоками и рабочими является отношением многие ко многим. Один рабочий может одновременно подписываться на несколько связанных потоков, и один и тот же поток также может быть подписан несколькими рабочими. Когда несколько рабочих пересекаются в одной и той же рабочей среде или обсуждении, новые события в этом потоке будут одновременно переданы всем подписанным рабочим, позволяя им избежать точечного общения и иметь возможность узнать о действиях друг друга и самостоятельно решать конфликты. На стороне вывода рабочие все равно будут сообщать ключевые выводы на уровень маршрутизатора, который централизованно отвечает пользователю и синхронизирует глобальную память.
3.3 Организация контекста
После фильтрации и маршрутизации событий и их поступления в целевую сессию, следующим вопросом является, сколько информации следует инъецировать в контекстное окно модели. Поскольку ввод системы изменился с ограниченных подсказок от человека на полуструктурированные события, постоянно генерируемые окружающей средой, структура вызовов инструментов и инъекций событий становится более важной. Слишком большое количество инъекций будет занимать окно и разбавлять внимание модели, в то время как слишком малое количество заставит модель многократно вызывать инструменты для чтения, увеличивая количество шагов выполнения. Трата контекстного окна — это трата интеллекта модели.
Для этого мы можем управлять ограниченным контекстным окном как кэшем. Заимствуя концепции оптимизации компиляции и компьютерных систем, дизайн инъекции контекста можно свести к двум основным операциям. Inline означает, что информация, которая, вероятно, будет использована в ближайшее время, инъецируется непосредственно в текущее контекстное окно, чтобы избежать дополнительных вызовов инструментов. Spill означает, что полная информация, превышающая бюджет окна или используемая с низкой частотой, остается за пределами контекстного окна, сохраняя только ссылки или резюме внутри окна для модели по мере необходимости.
С учетом классической идеи локальности (Locality) из дизайна компьютерных систем, мы можем постепенно оптимизировать инъекцию событий и вызовы инструментов с помощью Inline & Spill:
Начать с минимальной информации: изначально предоставляется только ID текущего объекта и резюме содержимого.
Постепенно инъецировать связанную информацию, используя локальность: инъецировать информацию, которая, вероятно, будет использована в ближайшее время, в контекст, сначала добавляя ID тесно связанных объектов, а затем сопутствующее содержимое, например, первые 50 символов содержимого, соседние сообщения IM и сообщения, на которые отвечают, или соседние комментарии в обсуждении рецензирования кода.
Превышение лимита приводит к Spill: для длинного контента, который нельзя полностью встроить в текст, устанавливается меньший лимит длины, и избыточная часть Spill выносится за пределы окна. Простым и прямым решением является обрезка избыточной части с сохранением точки продолжения чтения, когда модели требуется полный контент, она снова вызывает инструмент для чтения.
Кроме того, когда большое количество последующих событий проходит через Worker, и система накапливает много исторических задач в процессе длительной работы, уровень Router не может поместить всю историю всех задач в свое контекстное окно, но ему нужно восстановить контекст, когда пользователь поднимает старую задачу через разные каналы. Применив Inline & Spill последовательно ко всем объектам в системе, мы получаем механизм многоуровневого поиска по запросу, известный как цепочка воспоминаний (Chain of Recall). Этот процесс цепочки воспоминаний смягчает проблему потери предыдущей информации на уровне Router в долгосрочной перспективе, как показано на рисунке ниже:
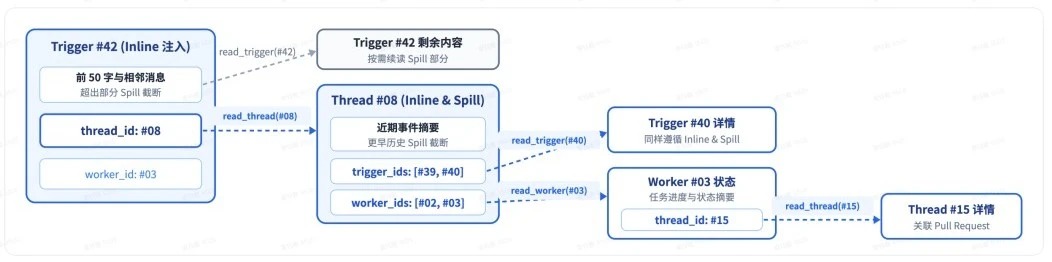
Цепочка воспоминаний: каждый объект, который вызывается, встраивает ID следующего связанного объекта, поддерживая последовательное раскрытие контекста по ссылочным отношениям.
Конкретно, система присваивает уникальные ID объектам, таким как Trigger, Thread и Worker Session, и при инъекции встраивает ID тесно связанных объектов, создавая таким образом ссылочную графику на нижнем уровне. Поскольку каждый объект, вызываемый инструментом, также следует принципам Inline & Spill, его возвращаемые результаты будут содержать краткое содержание и ID следующего связанного объекта, что позволяет модели начинать с текущего события и постепенно по запросу восстанавливать контекст по ссылочным отношениям.
Например, можно прочитать Thread из текущего сообщения, затем по встраиваемому ID Thread отследить соответствующую Worker Session, а затем найти другой Thread кода, связанный с этим Worker.
3.4 Предварительные действия
Заимствуя идею спекулятивного выполнения (Speculative Execution) из компьютерных систем, Agent может заранее попытаться выполнить действия в фоновом режиме, основываясь на сигналах окружения, даже если еще не уверены, будет ли результат принят, тем самым снижая время ожидания и вмешательства человека за счет использования дополнительных вычислительных ресурсов в фоновом режиме. Если результат имеет ценность, он передается, если нет — отбрасывается.
В сценарии личного помощника, когда поступает электронное письмо с приглашением на встречу или сообщение о задаче, Agent может сначала в фоновом режиме проверить наличие конфликтов в расписании, собрать соответствующую информацию и подготовить черновик ответа, который можно будет сразу подтвердить после просмотра пользователем. В сценарии совместной разработки это также актуально, например, в нашей внутренней группе пользователей DeepSeek Harness мы настроили стратегию «тихого воспроизведения и исправления»: когда кто-то в группе сообщает о проблеме или обсуждает изменения, Agent сначала пытается воспроизвести и найти решение в фоновом режиме, и только после подтверждения проблемы и нахождения простого решения передает результат пользователю, иначе остается в тишине.
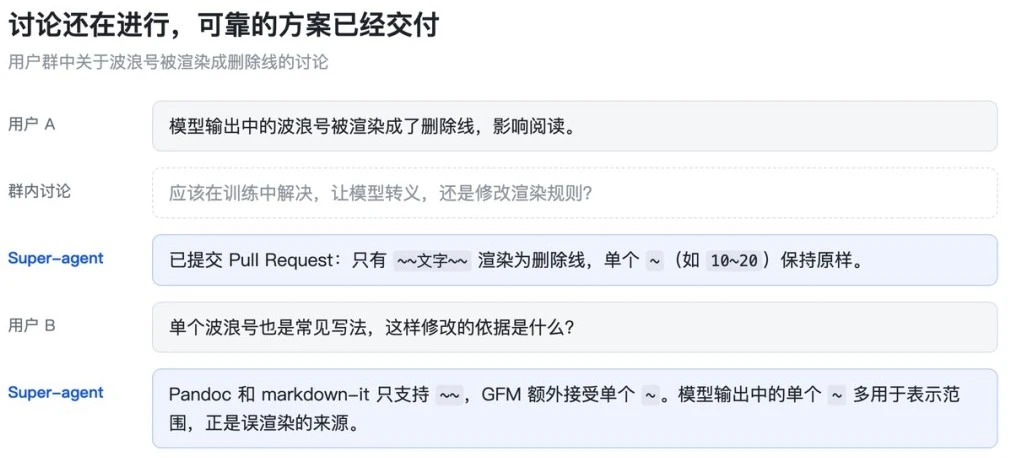
Пример спекулятивного выполнения: пока в группе обсуждаются решения, Super-agent уже в фоновом режиме подал Pull Request на исправление.
4. Взаимодействие с людьми
Двухуровневая архитектура из раздела 2 обеспечивает непрерывность между каналами, но для достижения как непрерывности, так и эффективности в реальном взаимодействии человека и машины необходимо решить две проблемы в способах и каналах взаимодействия: во-первых, как устранить блокировку фоновых операций, требующих времени, для переднего диалога с помощью асинхронного ReAct Loop, чтобы сеанс мог принимать новые команды в любое время без ожидания завершения предыдущей команды или задачи (раздел 4.1); во-вторых, как сделать так, чтобы способ вывода системы соответствовал пропускной способности и привычкам пользователей, когда взаимодействие происходит в различных рабочих каналах, с которыми пользователь знаком (раздел 4.2).
4.1 Полудуплексное взаимодействие
В классическом ReAct Loop после того, как модель инициирует синхронный вызов run (), цикл блокируется до завершения выполнения инструмента и возврата конечного результата, в течение этого времени сеанс не может реагировать на любые новые пользовательские вводы. Чтобы устранить эту блокировку, необходимо изменить диалог с полудуплексного режима вопрос-ответ на полудуплексный режим, как показано на рисунке ниже:
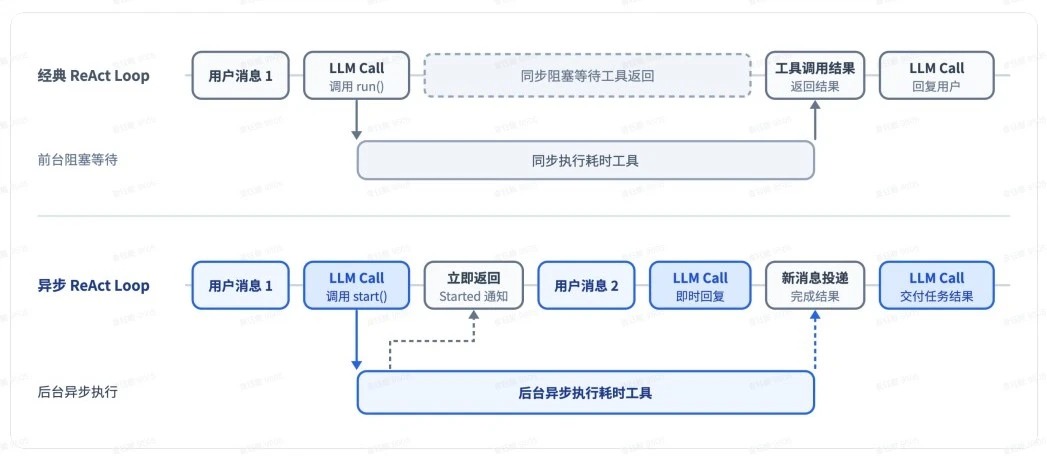
Сравнение классического ReAct Loop и асинхронного ReAct Loop: асинхронный вызов немедленно возвращает уведомление о начале, в то время как фоновый инструмент может продолжать реагировать на новые сообщения.
Для этого мы изменили временные команды и вызовы подзадач на асинхронные start () и stop (), создав асинхронный ReAct Loop. После вызова start () модель немедленно получает ответ «Запущено (Started)», цикл больше не ждет этот инструмент; после завершения выполнения фонового инструмента система отправляет конечный результат как новое сообщение события в сеанс; одновременно модель может также по контексту вызвать stop (), чтобы активно завершить выполнение фоновых команд, которые занимают слишком много времени.
Таким образом, отклик переднего диалога и выполнение фоновых задач были разъединены, Agent может реагировать на ввод человека, одновременно выполняя временные задачи в фоновом режиме. Новый ввод обрабатывается сразу после завершения текущего шага вывода, не дожидаясь завершения фонового инструмента.
Этот асинхронный механизм задач уже реализован в DeepSeek Harness, но пока не включен по умолчанию.
4.2 Многоканальное взаимодействие
Разные рабочие каналы имеют различную плотность информации и привычки взаимодействия, вывод системы должен соответствовать этому. Если перенести способ взаимодействия, ориентированный на одного пользователя, в групповой чат, выводя длинные процессы вывода и плотные вызовы инструментов, это может легко привести к избытку информации в многопользовательском сотрудничестве.
В Super-agent двухуровневая архитектура уже решила часть этих проблем: длинные процессы вывода и плотные вызовы инструментов в конкретных задачах изолированы внутри Worker Session и не выводятся напрямую во внешние каналы, а Router слой отвечает за внешнее взаимодействие. На этой основе система также должна интегрироваться с различными рабочими средами, которые пользователь использует ежедневно, и настраивать нормы взаимодействия в зависимости от различных каналов с помощью подсказок:
IM и другие каналы мгновенных сообщений: акцент на легком общении с низким уровнем вмешательства, отправка уведомлений только тогда, когда требуется решение или подтверждение, задавать прямые вопросы и давать краткие выводы. Мы проверили одно простое и эффективное жесткое правило: одно сообщение не должно превышать 100 слов.
GitHub, электронная почта и документы и другие асинхронные каналы: акцент на структурированной, высокой плотности информации асинхронной доставке, например, при создании или обновлении Pull Request следует писать полное описание проблемы, объяснение изменений и результаты проверки в соответствии с проектными стандартами, или в сценарии личного помощника сразу составлять структурированные резюме для электронных писем и документов.
5. Разделение вычислений, состояния и окружения
Существующий локальный Agent по умолчанию связывает вычисления, продвигающие Agent Loop, состояние сеанса, которое необходимо сохранять, и среду выполнения, такую как кодовые репозитории и локальные инструменты, на одном устройстве. Как только устройство переходит в спящий режим или отключается, Agent прекращает работу и не может получить доступ к среде на других устройствах. Чтобы Super-agent оставался постоянно онлайн и гибко подключался к различным реальным рабочим средам, мы можем заимствовать идею разделения вычислений и хранения (Compute-Storage Separation) из компьютерных систем, разъединив эти три компонента в два этапа: на первом этапе мы отделяем вычисления, продвигающие Agent Loop, от состояния сеанса, которое необходимо сохранять, позволяя Agent избавиться от ограничений жизненного цикла одного устройства и реализовать постоянное онлайн-состояние в облаке (раздел 5.1); на втором этапе мы отделяем облачный Agent Loop от среды выполнения с тяжелым состоянием, позволяя реальной рабочей среде оставаться на месте и поддерживать доступ через разные устройства (раздел 5.2).
5.1 Разделение вычислений и состояния
Вычисления, продвигающие Agent Loop, могут быть без состояния, а то, что необходимо сохранять, — это состояние сеанса. Таким образом, первый уровень разъединения заключается в том, чтобы поместить вычисления, продвигающие Agent Loop, в облачный без состояния эластичный вычислительный контейнер, а состояние, такое как Session, сохранять в базе данных. Без состояния вычислительные контейнеры могут горизонтально масштабироваться, перезапускаться или заменяться, а непрерывность сеанса и задач обеспечивается за счет постоянного хранения, что позволяет Agent избавиться от ограничений жизненного цикла одного локального устройства и реализовать постоянное онлайн-состояние в облаке.
5.2 Разделение вычислений и среды выполнения
После того как Agent Loop и состояние сеанса находятся в облаке, возникает дальнейшая проблема: как получить доступ к среде выполнения, необходимой для задач. Большая часть контекста, необходимого для работы модели, должна быть получена через вызовы инструментов из кодовых репозиториев, локальных файлов, зависимых сервисов и других сред выполнения, в этом смысле широкий контекст также включает в себя саму среду выполнения.
Существует два распространенных подхода к этой проблеме: один из них заключается в запуске песочницы в облаке, загрузке кода и попытке воссоздать и синхронизировать среду, но поскольку реальные рабочие среды часто содержат незавершенные локальные изменения, частные учетные данные, зависимости внутренних сетевых сервисов и специфическое оборудование или инструменты, технически синхронизация такой среды не только очень затратна, но и может привести к потере информации; другой подход — это прямое требование от пользователей отказаться от локальной среды и перейти на работу в облаке, но для многих пользователей стоимость миграции слишком высока.
Поскольку трудно воспроизвести и синхронизировать именно среду, нет необходимости переносить среду выполнения в облако вместе с Agent Loop. Второй уровень разъединения заключается в том, чтобы позволить Agent Loop работать в облаке, а среде выполнения с тяжелым состоянием оставаться на месте, развернув на стороне клиента легкий демон, который не сохраняет состояние сеанса, он отвечает только за выполнение команд и возврат результатов, что эквивалентно оставлению среды выполнения вне облака, позволяя Agent по запросу считывать контекст из нее.
Этот подход согласуется с концепцией «разделения мозга и рук» (Decoupling the brain from the hands), предложенной Anthropic, также позволяя harness оставаться без состояния, сохраняя журналы сеансов вне harness и подключаясь к среде выполнения по запросу через единый интерфейс. Разница между ними заключается в сценарии. В той статье описывается управляемый сервис, в основном обсуждаются песочницы, создаваемые по запросу, и ресурсы внутри клиентского VPC; здесь в первую очередь необходимо подключить личные машины пользователей, которые они используют ежедневно и которые могут быть периодически онлайн, на которых есть незавершенные изменения и локальные учетные данные. Таким образом, этот дизайн поддерживает BYOM (Bring Your Own Machine), позволяя подключать используемые пользователями рабочие или личные компьютеры к облачному Agent, а также поддерживает подключение облачных управляемых машин или вычислительных сред, создаваемых по запросу.
Таким образом, Agent больше не ограничен одним устройством, а может переключаться между различными устройствами выполнения, выбирая среду для выполнения команд и получения контекста из нее в зависимости от задач. Он даже может поддерживать периодически онлайн-устройства, например, после повторного подключения какого-либо личного устройства пользователя, облачный Agent может автоматически инициировать и завершить задачи, которые необходимо выполнить на этом устройстве. На рисунке ниже показана структура после разъединения вычислений, состояния и различных сред выполнения на два уровня:
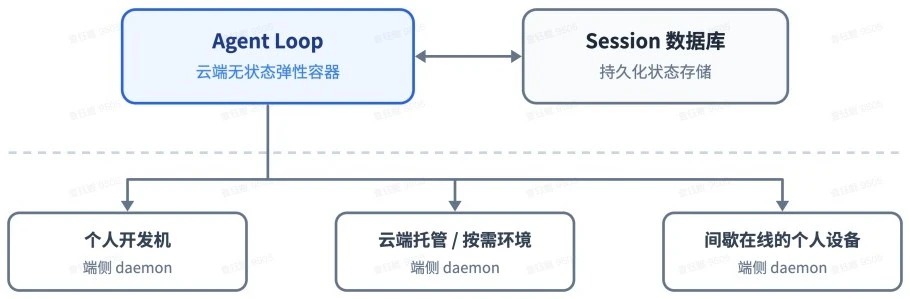
Разделение хранения и вычислений и декомпозиция среды выполнения: цикл агента и постоянное состояние отделены в облаке и подключаются к различным средам выполнения по мере необходимости через демон на стороне клиента.
6. Сторожевой пёс
Для достижения постоянного подключения, помимо разделения хранения и вычислений, описанного в разделе 5, необходимо, чтобы система могла автоматически восстанавливаться от аномалий в процессе длительной работы. Распределённые системы с постоянным подключением трудно поддерживать надёжными только за счёт внутренней логики основной системы; необходимо вводить независимый внешний контрольный контур, то есть контрольный цикл.
В то же время в системе агента полагаться только на традиционное обнаружение живости процессов или скрипты мониторинга недостаточно, поскольку многие аномалии не связаны с крахом процессов, а возникают, когда модель застревает в неэффективном цикле или отклоняется от цели. Поэтому долгосрочные системы агентов должны не только отслеживать живучесть инфраструктуры, но и контролировать ход выполнения задач.
Мы настроили независимую сессию сторожевого пса вне основной системы, управляемую периодическими сообщениями, чтобы сформировать внешний контрольный цикл. Сторожевой пес, помимо обработки ошибок интерфейса, сбоев восстановления состояния и других инфраструктурных неисправностей, также будет определять, есть ли у каждого рабочего реальный прогресс и отклоняется ли направление от общей цели. При обнаружении аномалий он вовремя вмешивается для исправления, а в случае внешних случайных сбоев продолжает проверять до восстановления нормальной работы.
Поскольку сам сторожевой пес также является сессией агента с полными инструментальными возможностями, администраторы могут задавать ему вопросы о причинах сбоев на естественном языке, а также позволять ему вносить онлайн-изменения в поведение основной системы, например, добавлять или удалять подсказки, настраивать правила срабатывания.
7. Предварительные эксперименты
Чтобы оценить основные механизмы планирования и маршрутизации, описанные ранее, мы провели предварительные эксперименты на двух уровнях: сначала с помощью экспериментов от конца до конца сравнили двухуровневую архитектуру, прямую подписку и одноразовую сессию (раздел 7.1), затем отдельно протестировали пакетную обработку на уровне маршрутизатора (раздел 7.2). Поскольку эксперименты основаны на синтетической нагрузке и упрощённой среде, некоторые настройки могут быть более строгими, и приведённые результаты служат лишь предварительной справкой.
7.1 Абревиатурные эксперименты
Мы одновременно использовали групповой чат и поток сообщений GitHub CI для управления четырьмя схемами от конца до конца: одноразовый эксперимент содержал около 300 сообщений, из которых около 20 были рабочими запросами, остальные — это разговоры, последующие действия, остановки и сообщения CI. Работы по кодированию выполнялись с помощью инструмента, который только тратит время, поэтому эксперименты измеряли способности системы к планированию и сотрудничеству, а не к выполнению отдельных задач. Каждая схема повторялась 5 раз.
Сравниваемые четыре схемы включают Super-agent, Super-agent без прямой подписки, а также две схемы с конфигурацией подсказок для одноразовой сессии + Subagent.
При этом нейтральная подсказка была записана как "Используйте подагента для выполнения работы, когда это уместно…"
Подсказка с приоритетом делегирования была записана как "Каждое сообщение чата доходит до вас, поэтому работа, которую вы выполняете сами, постоянно прерывается новыми сообщениями. Предпочитайте передавать каждую часть работы своему подагенту и выполняйте только небольшие задачи сами…"
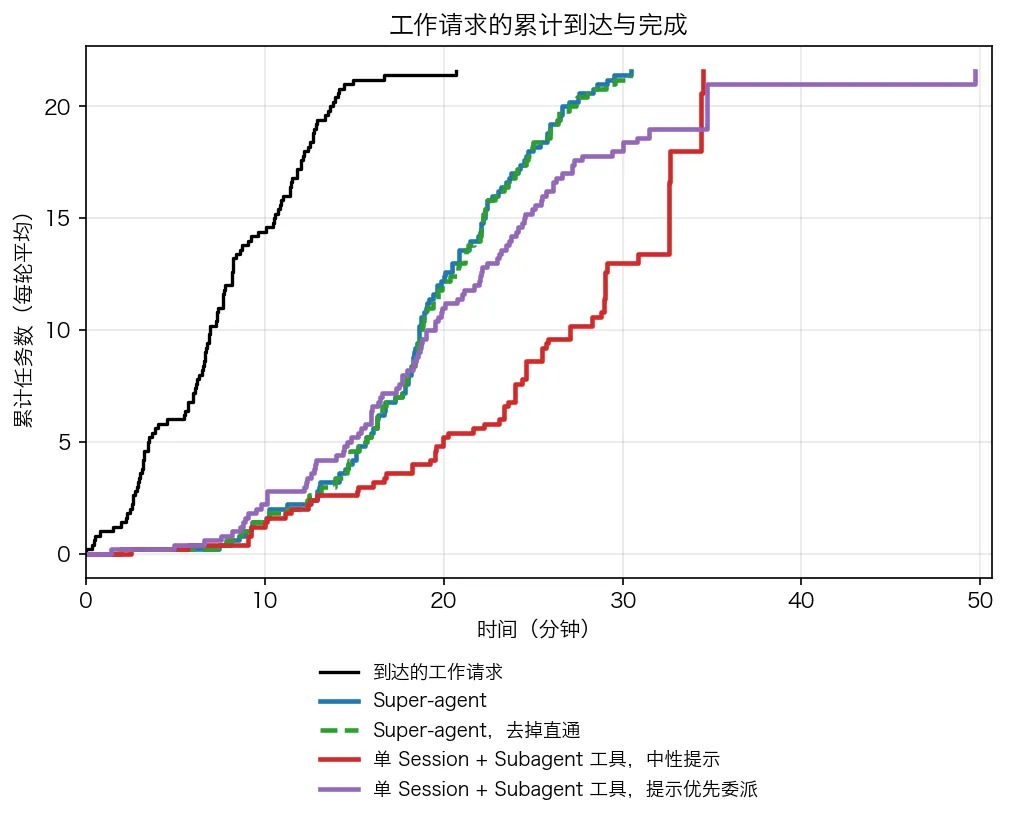
Кумулятивная кривая поступления рабочих запросов и кумулятивная кривая завершения для четырёх схем (средние значения 5 запусков эксперимента; интервалы сообщений и продолжительность работы уменьшены в 1/4, время вызова модели — реальные значения)
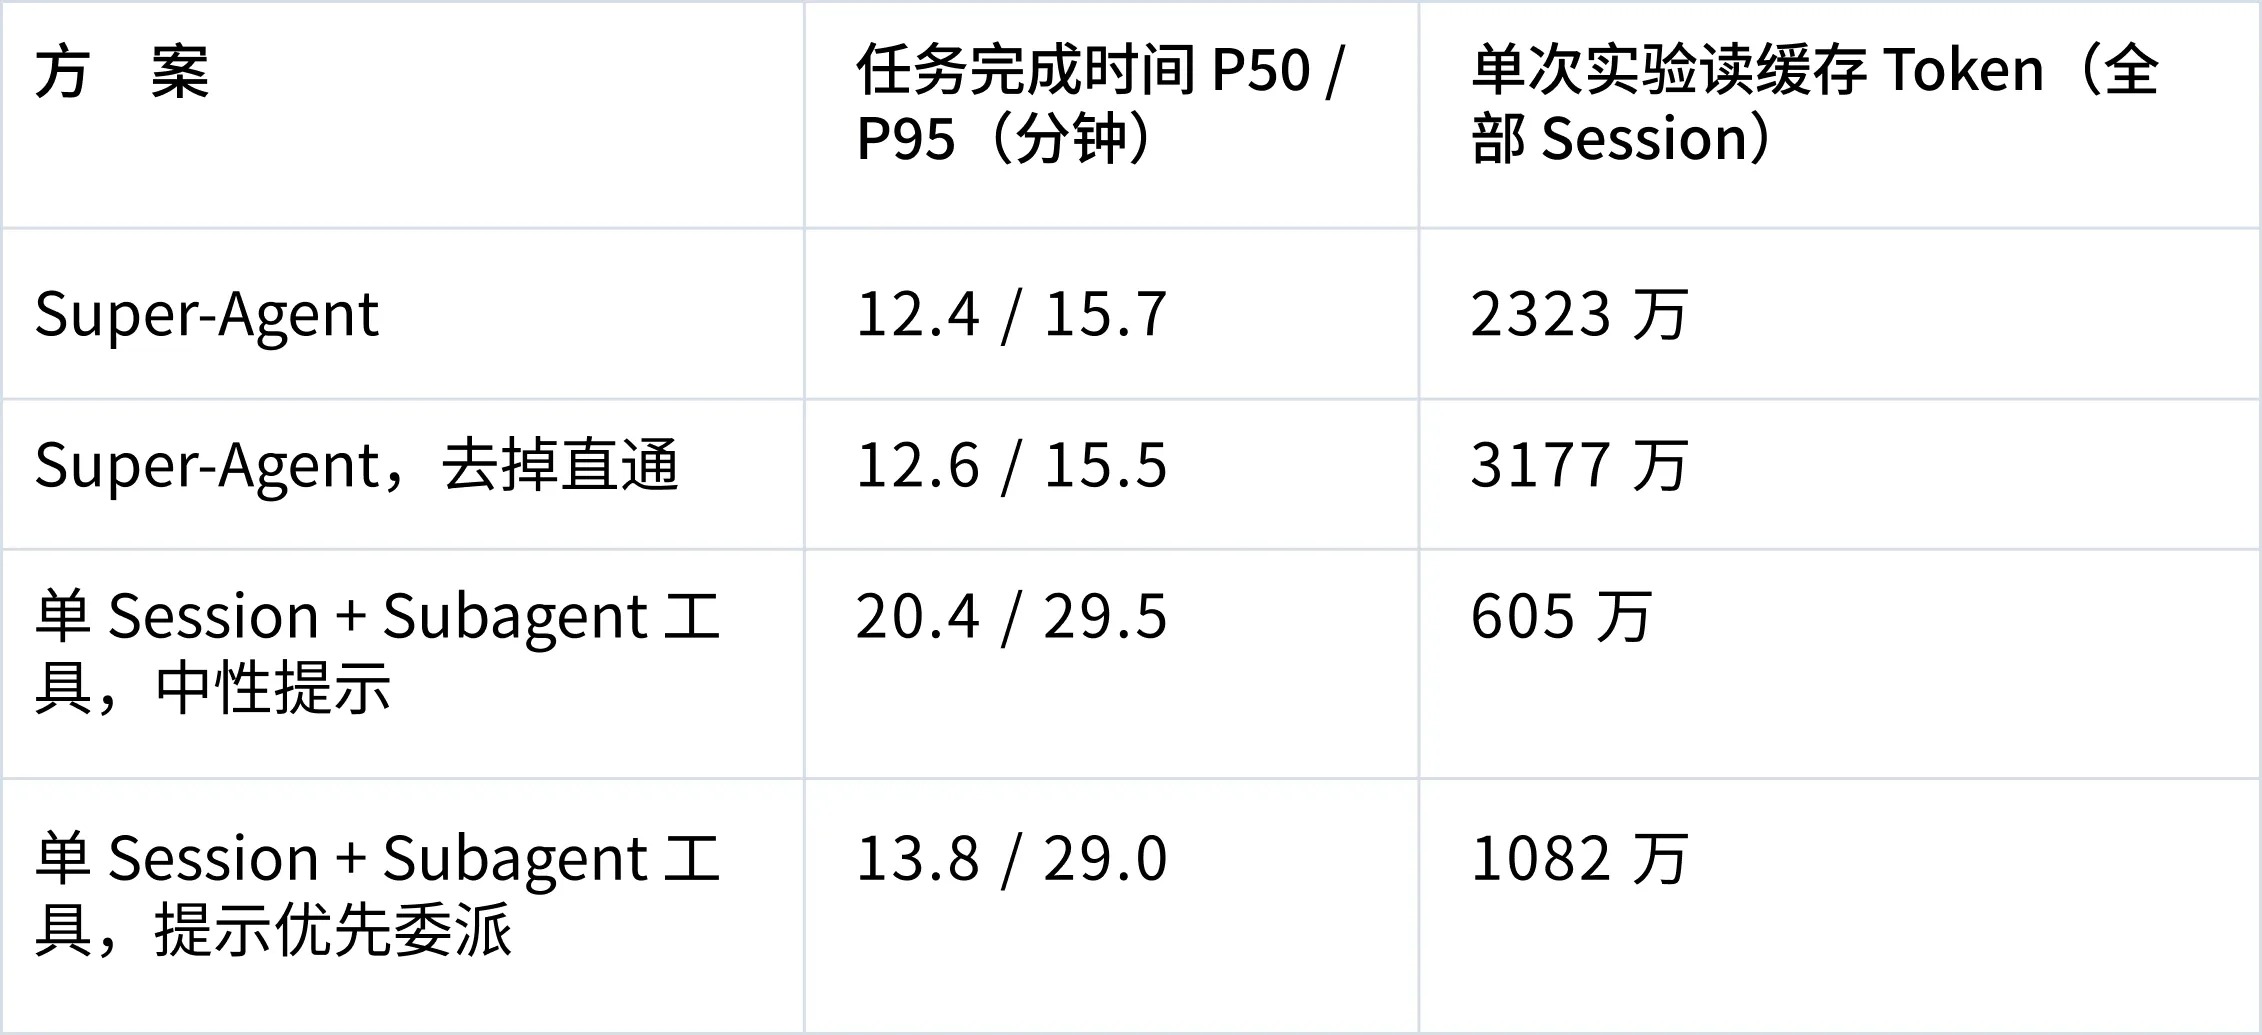
Каждая схема повторялась 5 раз; время завершения задачи указывает на время от рабочего запроса до сообщения с результатом.
С точки зрения времени завершения задач, p50 и p95 для Super-agent составляют 12.4 минуты и 15.7 минуты соответственно, что значительно лучше, чем у одноразовой сессии с инструментом Subagent. Это связано с тем, что одноразовая сессия с Subagent в экспериментальных условиях сильно зависит от подсказок, и основная сессия часто решает выполнять задачи самостоятельно, что приводит к более длительному общему времени завершения и нестабильной производительности. При нейтральной подсказке модель ни разу не вызывала Subagent за 5 запусков; вся работа выполнялась в основной сессии и постоянно прерывалась новыми сообщениями, p95 достигло 29.5 минут; после изменения на подсказку с приоритетом делегирования модель 4 из 5 запусков делегировала задачи, время завершения сократилось, но в целом всё ещё было медленнее, чем у Super-agent, и в оставшемся 1 случае она решила, что работа "очень мала", и выбрала выполнить её самостоятельно, что сформировало фиолетовый хвост на графике. В отличие от зависимости от подсказок и моделей в одноразовой сессии, двухуровневая архитектура смягчила эту проблему на системном уровне, позволив маршрутизатору не выполнять конкретные задачи, а рабочим получать только сообщения из подписанных потоков.
С точки зрения системных затрат, поскольку поддерживались несколько независимых сессий, количество токенов в кэше чтения для Super-agent в одном эксперименте было выше, чем для одноразовой сессии, что привело к более короткому и стабильному времени завершения за счёт большего расхода токенов. После удаления прямой подписки внутри Super-agent время завершения задач стало практически таким же, как и в полной версии, но количество решений, которые должен был принимать маршрутизатор в одном эксперименте, увеличилось примерно на 30%, общее количество токенов в кэше чтения увеличилось с 23.23 миллиона до 31.77 миллиона, что составляет увеличение примерно на 37%. Это показывает, что в условиях экспериментальной нагрузки прямая подписка не повышает качество и скорость завершения задач, но экономит значительное количество токенов и затрат на вывод для сессии маршрутизатора.
7.2 Пакетная обработка на уровне маршрутизатора
Чтобы проверить предельную пропускную способность одного постоянного маршрутизатора и механизм пакетной обработки, мы отдельно провели нагрузочное тестирование на уровне маршрутизатора: позволили маршрутизатору вызывать реальные модели, а рабочим использовать имитационные модели, и постепенно увеличили скорость поступления триггеров с примерно 1 в минуту до примерно 40 в минуту, наблюдая за средним размером пакета, временем обработки одного запроса и временем вывода на одно решение.
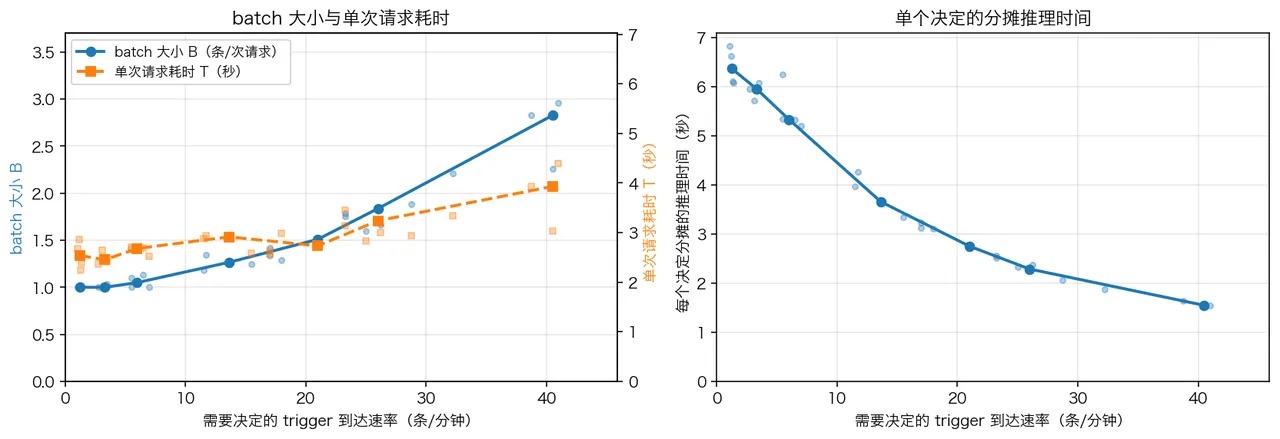
Размер пакета, время обработки одного запроса и время вывода на одно решение для сессии маршрутизатора при различных скоростях поступления триггеров.
8. Открытые вопросы
Пять модулей, описанных в разделах 2-6, составляют основную архитектуру, поддерживающую работу Super-agent, а эксперименты в разделе 7 также подтвердили эффективность основных механизмов планирования и маршрутизации в условиях многозадачной параллельной работы. Эта система может функционировать с относительно низкой сложностью во многом благодаря тому, что на текущем этапе мы сделали ряд инженерных и сценариальных упрощений. За пределами этих упрощений, в расширении двухуровневой архитектуры (раздел 8.1), в человеко-машинном взаимодействии после выхода из сессии (раздел 8.2), в контекстных границах и A2A (раздел 8.3), а также в вопросах безопасности и конфиденциальности (раздел 8.4) остаются нерешённые проблемы.
8.1 Как расширить двухуровневую архитектуру
Ранее мы с помощью упрощённой комбинации "один постоянный маршрутизатор + прямая подписка + отсутствие прямой связи между рабочими" покрыли большинство наших повседневных задач с небольшими инженерными затратами. Однако, когда масштаб задач увеличивается и степень их взаимосвязи возрастает, выходя за пределы возможностей одного маршрутизатора, конкретная внутренняя структура не имеет однозначного решения; когда маршрутизатору необходимо горизонтальное деление, какова должна быть степень деления, и когда между рабочими одного уровня необходимо вводить прямую связь и какую топологию сотрудничества использовать, всё это ещё предстоит проверить в большем количестве сценариев. В то же время совместный дизайн системы и модели (Co-design) также является перспективным направлением, которое может повысить пропускную способность и производительность принятия решений на уровне маршрутизатора, если проводить специальное обучение для задач, связанных с определением событий, пакетной отправкой и вызовом контекста.
В то же время, ранее упомянутая постоянная сессия маршрутизатора в сочетании с цепочкой вызовов на основе графов в основном решала задачу по запросу недавних задач и истории сессий. Когда период работы растягивается на месяцы или даже более длительные временные интервалы, долговременная память становится основным узким местом для масштабируемости.
8.2 Как взаимодействовать с агентом после выхода из сессии
Ранее мы скрыли управление многими сессиями на нижнем уровне от пользователя с помощью двухуровневой архитектуры, так что сессия больше не является первоочередной проблемой проектирования продукта; однако, когда нижние сессии выполнения больше не соответствуют сессиям на пользовательском интерфейсе, как представить пользователю задачи и обеспечить естественное взаимодействие и формы управления проектами, становится новой задачей. Мы считаем, что взаимодействие, сосредоточенное вокруг окна чата, в определённой степени является результатом зависимости от пути. Взаимодействие может происходить больше в специализированных интерфейсах взаимодействия, например, как в примере этой статьи, позволяя Super-agent работать непосредственно в Issues и Pull Requests на GitHub; сессии также могут сохраняться на интерфейсе в соответствии с привычками пользователей, но сессия, которую видит пользователь, на нижнем уровне может не соответствовать только одной сессии.
В то же время, ранее мы в основном обсуждали взаимодействие человека на этапах инициирования задач и принятия результатов; однако в переходный период быстрого развития возможностей модели многие задачи всё ещё требуют участия человека в процессе, и как в дизайне продукта учесть постепенное вмешательство пользователя в ключевые детали и эффективность автономного продвижения на заднем плане, например, позволяя пользователю вмешиваться, брать на себя управление или работать в реальном времени с агентом, также заслуживает изучения.
В общем, формы управления проектами и взаимодействия, необходимые пользователю, тесно связаны с конкретной областью работы и личным стилем, и конечная форма, вероятно, будет высоко индивидуализированной; а DeepSeek Harness, благодаря открытой архитектуре, также легче поддерживает такую индивидуализацию.
8.3 Как определить границы контекста и осуществлять A2A сотрудничество
Обсуждаемые ранее аспекты касаются дизайна внутри одного экземпляра Super-agent, предполагая, что информация в пределах его области обслуживания собирается в одном глобальном контексте. Однако, когда область использования расширяется от индивидуального или небольшой команды до более крупных организаций, организации, принимая решение о том, как оснастить Super-agent, фактически определяют границы общего и изолированного контекста. Области, которым необходимо делиться контекстом, должны использовать один и тот же экземпляр, в то время как области, которые должны быть изолированы, должны быть оснащены независимо.
Далее, если в организации или между организациями существует несколько изолированных экземпляров, например, личные помощники каждого участника и общий Super-agent команды, то в этом случае межагентская коммуникация (A2A, не указывая на конкретный протокол) становится кросс-граничной координацией. При условии, что базовый контекст не разделяется, а каждый представляет собой разные границы полномочий, как обеспечить безопасную и надежную A2A коммуникацию и сотрудничество, все еще требует дальнейшего изучения.
8.4 Как обеспечить безопасность и конфиденциальность
Дизайн, основанный на событиях в разделе 3, позволяет Agent быть более широко управляемым окружением, но также увеличивает риск взаимодействия с ненадежными входными данными. Если не удастся хорошо решить проблемы безопасности и конфиденциальности, то Super-agent сможет работать только в очень ограниченной и доверенной среде.
Например, в разделе 5 Agent Loop развернут в облаке, и на различных устройствах выполняется легкий демон, что предполагает доверие между облаком и конечной средой. Однако, когда облачный Agent Loop постоянно подключается к событиям внешней среды, а на конечных устройствах находятся частные коды, чувствительные данные и локальные учетные данные, такое межустройственное соединение создает значительные риски безопасности и конфиденциальности. Если облачный Agent Loop подвергнется атаке на сервер или инъекции подсказок и будет взломан, все подключенные конечные устройства окажутся под потенциальным контролем.
Кроме того, даже если облако не было взломано, как только учетные данные в конечной среде могут попасть в контекст модели, существует риск утечки учетных данных в процессе нормального выполнения; поэтому необходимо разработать соответствующий механизм, который позволит Agent использовать учетные данные, не касаясь самих учетных данных. Если эта архитектура должна перейти к более широкому применению, необходимо решить вышеупомянутые проблемы безопасности и конфиденциальности, одновременно обеспечивая возможность извлечения контекста из разнообразных сред.
9. Заключение
Оглядываясь на весь дизайн, мы не предложили новую теорию, а применили классические инженерные идеи из компьютерных систем к построению системы Agent. Конкретные способы реализации будут развиваться с технологическим прогрессом, но мы считаем, что основная концепция системного дизайна имеет более долгосрочную ценность. В настоящее время внутренний экземпляр Super-agent, построенный на этой концепции и DeepSeek Harness, уже работает, участвуя в воспроизведении и исправлении проблем, ответах на код-ревью и итерациях самого DeepSeek Harness.
Как было упомянуто в начале, по мере того как большие модели все реже требуют человеческого вмешательства для выполнения отдельных задач, ограничение дальнейшего повышения производительности смещается на внимание человека. С помощью двухуровневой архитектуры, событийного управления, асинхронного многоканального взаимодействия, разделения хранения и вычислений и внешнего Watchdog система на базовом уровне берет на себя сложное управление сессиями и синхронизацию контекста, позволяя человеку перейти от конкретных деталей выполнения к более высоким уровням принятия решений и приемки.
В этой форме Agent больше не является просто пассивным окном для ожидания команд, а эволюционирует в автономного сотрудника, постоянно находящегося в цифровой среде: для индивидуального пользователя он может быть личным помощником, который помогает обрабатывать повседневные дела на разных устройствах; для команды он интегрируется в рабочий процесс разработки, принимая и продвигая конкретные задачи. Мы верим, что с совместной эволюцией возможностей модели и базовой архитектуры системы такой более автономный способ работы может стать нормой для сотрудничества человека и машины.
Часть дизайна этой статьи уже реализована в dsh-superagent-prototype. Этот плагин является прототипом, предоставленным для проверки технологического направления, а не официальным продуктом DeepSeek.
Автор и благодарности
Эта статья основана на совместной практике команды DeepSeek Harness. Юцзя Цяо завершила реализацию системы и написание этой статьи, Хуанци Цао, Цзуй Чен, Сьетин Чу, Тяньи Цуй, Шиюань Фэн, Юдун Хан, Кексин Лю, Шичун Лю, Гэси Ло, Ифань Ши, Тунжуй Сюн, С. С. Ю, Цзия Чжан, Ф. Чжоу и другие участвовали в рецензировании, обсуждении и предоставлении обратной связи. Реализация системы и формирование статьи невозможно без ежедневного общения и накопления команды.
 Предупреждение о рисках
 Предупреждение о рисках
Популярные статьи





