深入底層看 Jev,能否戴上“範式革新”的王冠
 核心觀點

 通用判斷需要同時調用多種能力,不能因為最後只輸出一個概率,就認為它比生成答案容易。
作者:博陽
編輯:徐青陽
在科技圈,炒作的週期總是驚人地相似。
2026年9月,整個矽谷和開源社區都在為了一個名為Jev的模型而狂熱。
它宣稱這是一個「系統一(System One)」模型,自稱能夠帶來顛覆性的變革。
在過去的三四年裡,我們已經習慣了那些像連篇累牘的散文家一樣的大語言模型(LLM),它們在回答一個簡單的「是」與「否」之前,總要先生成幾百個毫無意義的思考Token,然後再慢條斯理地吐出一個JSON格式的結論。
但Jev不同,它承諾直接給你判斷,給你概率,並且快得令人發指。
開發者們為了這種「快準狠」的接口陷入了瘋狂。
畢竟,當你在構建一個複雜的AI Agent(智能體)時,你經常需要的只是問它:「這條記憶是否相關?」「這個請求該交給哪個工具?」「這起事故是否需要人工復核?」。
大家在業務中為了讓一個通用大模型為每一個小問題生成文字、解釋和結構化代碼,付出了太多的token和延遲。從真實需求切入,Jev切中了一个極其痛的痛點。
但是,它真的具有足夠的顛覆性嗎?
當我們省去了「生成文字」這個過程以後,留在這個黑箱裡的判斷能力,究竟有多少是來自於原來大語言模型底座的饋贈,又有多少是來自於TypeSafe團隊所謂的專門訓練?
要回答這個問題,我們可以把Jev的包裝一層層撕開,分幾個切面來好好講講。
01
預測判斷的模型比GPT還早
Jev所代表的這個方向,有著一段非常漫長的歷史。
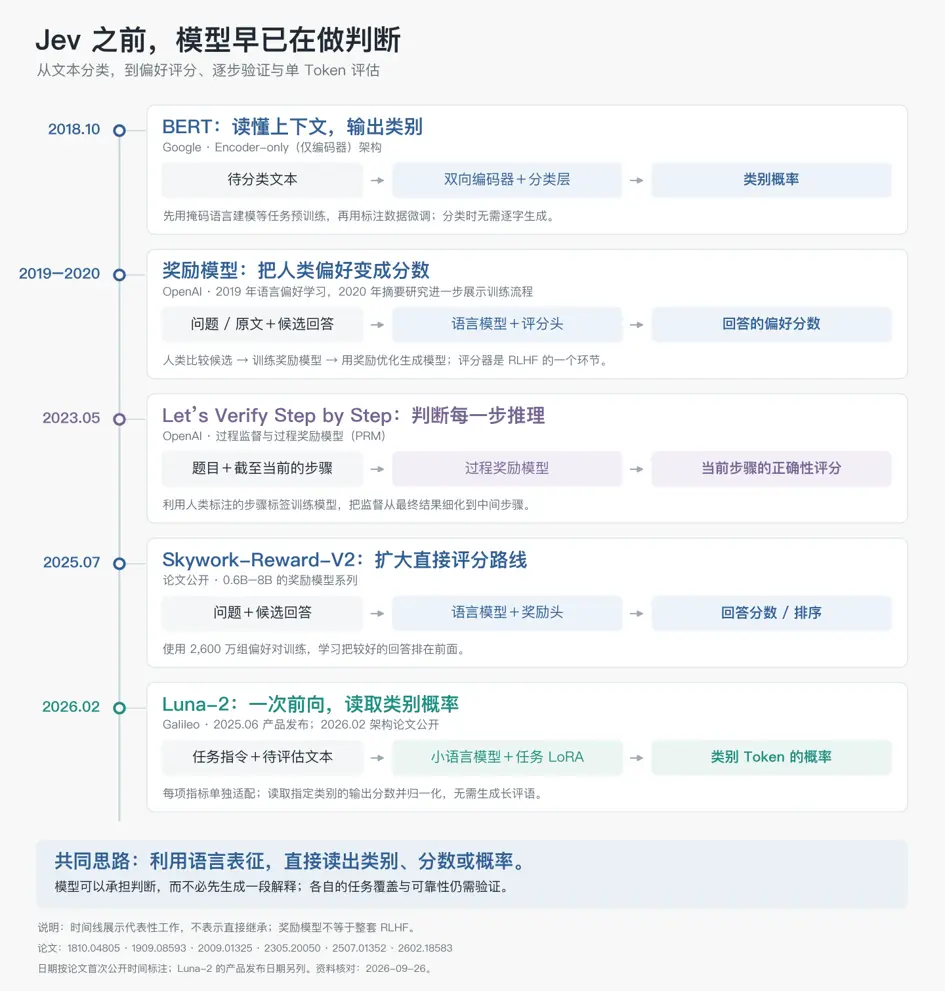
早在2018年,谷歌就推出了BERT。它與今天我們熟悉的GPT類模型不同,採用了允許信息雙向交流的 Encoder-only(僅編碼器)架構,訓練模型去完型填空。
雖然後來用來訓練續寫的Decoder-only(僅解碼器)模型(比如ChatGPT)成了主流,但在明確的分類任務上,BERT 依然有它的優勢。
靠著能看到所有信息的 Encoder,BERT 可以讓文本中的各個位置結合前後文形成完整的特徵表示,再接上簡單的分類層,用標註好的郵件訓練後,就能快速做出判斷。
而現代LLM 其實也有很多時候被訓練成分類器的角色。
2019年,OpenAI在《Fine-Tuning Language Models from Human Preferences》這篇論文中,就已經開始嘗試讓模型學習人類對文本的偏好。
到了2020年關於文本摘要的研究中,這條技術流水線變得更加清晰,人類標註員先去比較兩份摘要,然後拿它訓練獎勵模型去學習預測人類到底更喜歡哪一份。
在這個過程中,人類的判斷被成功轉化成了一個評分函數。獎勵模型本身不需要寫出長篇大論的評語,它只需要讀取問題與回答,然後通過神經網絡的輸出層直接給出分數。
這實際上也是當下模型學習最底層的模式之一,它就是Jev強烈批判的RLHF。
因此,「繼承語言模型的理解能力,但不生成文字」並不是Jev獨有的天才思路。
到了2023年的知名論文《Let's Verify Step by Step》,這種監督被進一步細化應用到了模型的每一步。獎勵模型、驗證器和評價指標由不同任務發展而來,逐漸形成了AI工業界不可或缺的幾類判斷工具。
到了2025年至2026年,相關研究仍在推進。2025年Galileo發布了Luna-2,並在隨後的論文中展示了如何將小語言模型訓練成「單Token分類器」,通過一次前向計算直接讀取目標類別的概率。而 Skywork-Reward-V2推出了從0.6B到8B的獎勵模型系列,優化LLM直接評分路線。
從算法實現的角度看,這本身並不困難。對 LLM做一些簡單的改變,讓它直接從內部的隱藏表示計算候選分數,而不是吐一堆字方法非常多。
在後文的複刻實驗中,我們就可以看到三個以上。
那麼Jev在這次浪潮中究竟帶來了什麼不一樣的東西?
從目前的架構解密和官方說明來看,Jev的核心差異化體現在兩個維度上。
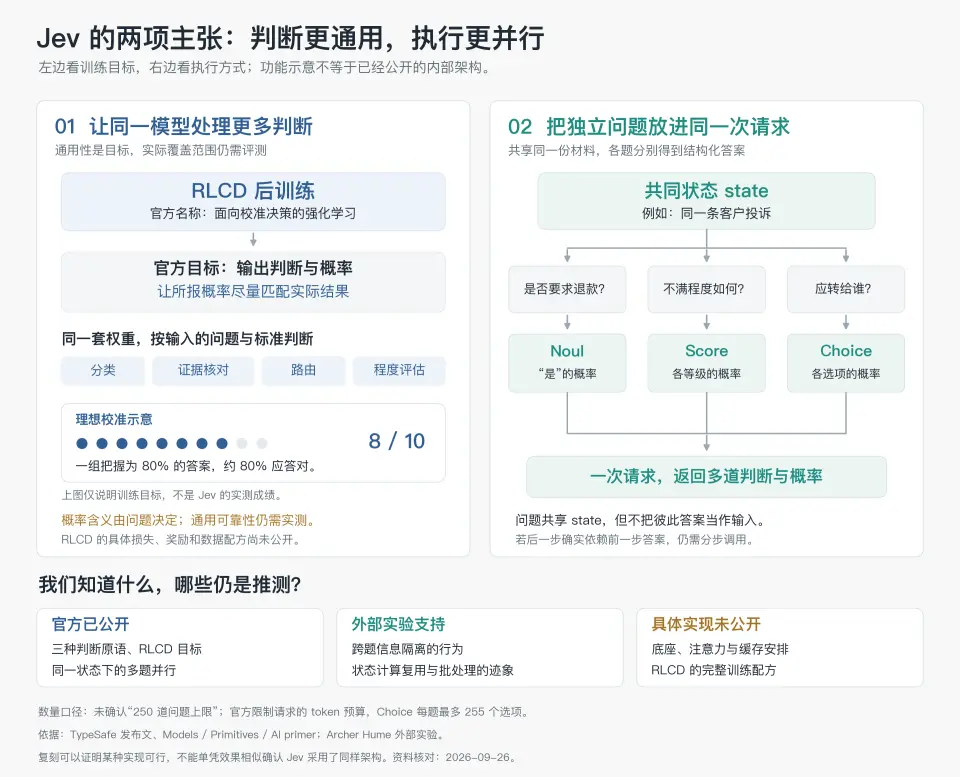
首先,是更加通用的變化,這得益於其全新的後訓練方法。
過去的評分器基本都是針對單任務做訓練。Jev不再局限於某種特定的評分,而是試圖提供一個極其通用的概率接口。
而且這個通用,是對事實概率通用,而非人類偏好通用。
這次 TypeSafe團隊把「概率校準」放到了訓練目標的絕對中心位置,他們將這種方法稱為RLCD(面向校準決策的強化學習)。而傳統偏好獎勵模型(RLHF)找的是人類偏好的概率,而非真實世界事件概率。
其次,是架構上對並行計算的極致壓榨。
Jev改變了信息流經模型的方式。過去的評分模型在並行回答上的修改不多,因為主要目標是訓練密集獎勵模型,給一個個出來的token打分。
但這次Jev是可以針對同一份材料回答上限250道問題的。只要這些問題之間沒有先後生成的依賴關係,就可以被大規模地批量並行執行。
這些都是如何實現的呢?
雖然Jev本身沒有具體披露其架構,但根據其實際表現和諸多試圖還原Jev的嘗試,我們已經可以大概地描述出其輪廓。
02
從測試和還原中,拼湊出Jev的原貌
我們先來看看TypeSafe目前公布了什麼。
在黑箱之外,TypeSafe 明確公布的首先是接口。你可以向這個接口提供兩種東西,
State(狀態): 相當於一篇長篇閱讀理解的原文(比如一段長長的客戶投訴記錄,或者系統日誌)。
Questions(問題): 針對這篇原文,你可以同時提出好幾個問題。問題之間互不干擾。系統收到這些獨立答案後,再由寫代碼的人(你)來決定下一步業務邏輯怎麼走。
為了讓問題標準化,TypeSafe 把提問方式收束成了三種原語(Primitives)。包括:
Noul(是非題): 問「是否」,直接返回一個 0~1 之間的概率(比如:這事兒緊急嗎?返回 0.95)。
Choice(選擇題): 問「選哪個」,給出幾個候選項,返回它們各自的概率分佈(比如:轉給技術部 0.8,轉給財務部 0.2)。
Score(打分題): 問「程度」,返回各個等級的概率和最終加權得分(比如:客戶憤怒指數 4.5 分)。
如果目標是讓程序做常見的判斷,這三種原語覆蓋了很大一部分輸出形式,幾乎所有的判斷都能轉化成這三種問題。
最後程序拿到數字,再按自己的規則採取動作。
官方承諾,Jev 只會把 State 讀入一次 。隨後,所有問題會在同一個請求裡,針對這份狀態做並行且獨立的判斷。
獨立意味著多道題之間不能互相參考答案。如果你的第二道題必須依賴第一道題的結果,就只能分兩次發請求。
因此,TypeSafe 鼓勵一種叫 「Speculative fan-out(推測性並發)」 的用法:比如處理一篇客訴,哪怕最後發現這不是系統故障,程序也可以在一開始就把「是不是故障」、「故障有多嚴重」、「該轉給誰」全問了。系統一次性並行算出所有答案後,再由下游的代碼邏輯把沒用的結果丟棄。
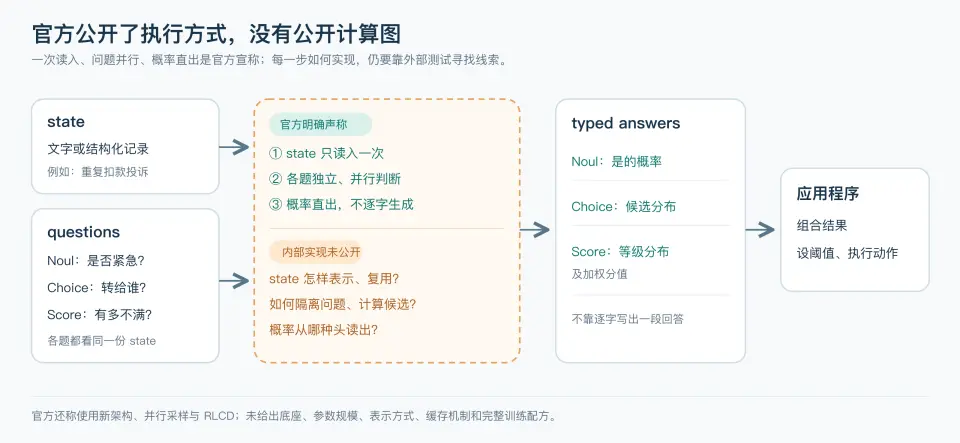
目前,這就是我們知道的所有官方公布的主要信息。
在 Jev 受到關注後,Archer Hume 對其進行了一系列黑盒測試,從中我們可以獲得很多關於 Jev 如何處理狀態文本的洞察。同時,Kev、NanoJev、minojev 等開源複刻項目也如雨後春筍般湧現。
通過對比哪些複刻項目的測試反饋更接近 Jev 本尊,我們就能反向假設出它們真實的內部架構。
雖然不能說這些複刻 100% 還原了 Jev 的本體,但在官方接口文檔之間留下的巨大黑洞之間,比如原文到底是怎麼共享狀態的?普通的候選選項是如何形成特徵表示的?它們之間在哪一步互相影響?
我們通過這個透鏡也能窺見大致的輪廓。
接下來,我們將用一份具體的請求,重走一遍這個黑箱大模型的「內部消化」流程。
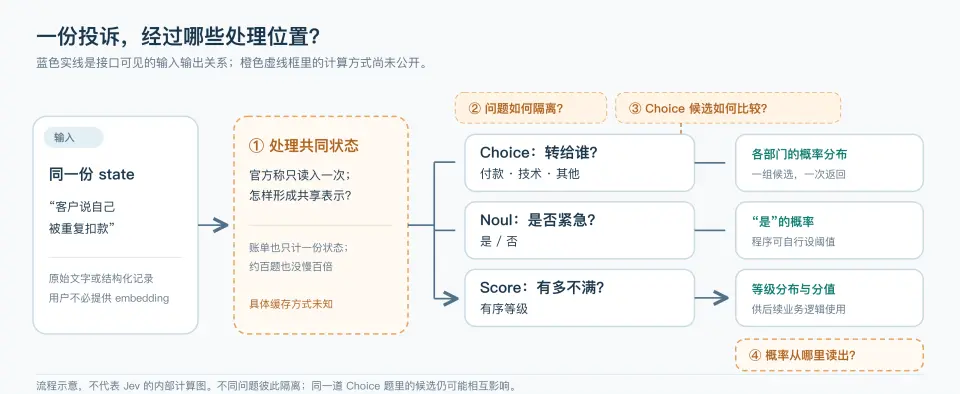
首先,我們需要理清 Jev 實際吞吐的信息結構。一次完整的處理包含了三部分:作為共享背景的 State(例如那篇長長的投訴文本)、若干個獨立提出的 Questions(問題),以及這些問題各自對應的 Options(候選項)。
第一站:處理共同信息
如果每道題都要把幾萬字的投訴從頭到尾重新讀一遍,題目越多,重複的無用算力就越多。
所以最好的方法就是所有問題都可以只讀一遍題然後就都能用。
為了驗證 Jev 是否真的做到了「只讀一次」,研究者 Archer Hume 查閱了 API 的計費帳單與延遲數據:當提交一道最簡單的是非題時,計費顯示為 268 個輸入 token;增加到兩道題時,變成了 276 個。多出來的僅僅是新增題目本身的字數開銷,系統並沒有把共同的 State 材料重複計費。
同時,在題目數量增加到近百道之前,服務端的響應時間幾乎是一條水平線。
雖然商業計費規則和批量運行掩蓋了顯卡真實的運算記錄,但這在現象上高度吻合了官方「共同材料只讀一次、各題批量計算」的說法。
對於這個信息架構,開源項目 Kev 的還原目前看最為清晰。
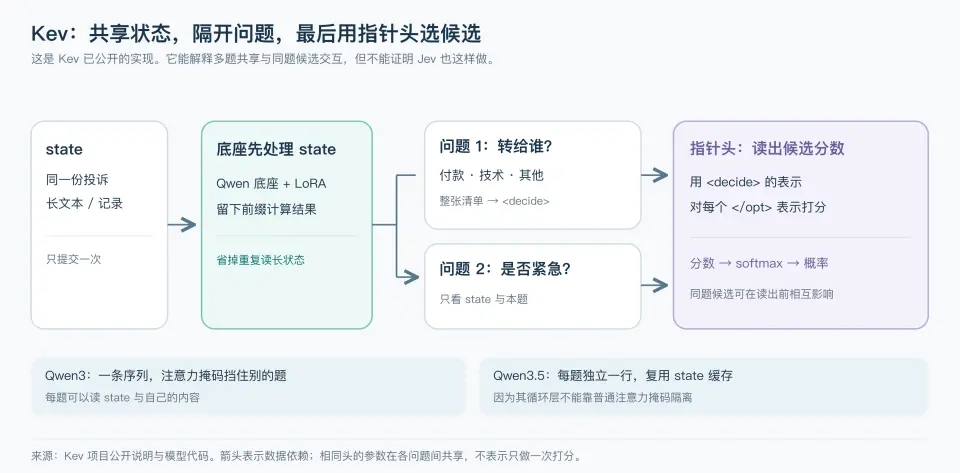
Kev 首先一次性處理狀態,把計算得出的中間結果凍結在Kv Cache裡。接下來,這 50 個問題都分享著這套Kv Cache往下算,這樣就不用每個題都讀一次了。
第二站:問題拆分
但另一個關鍵問題是,這些批量計算的題目,真的和官方說的一樣互不串台嗎?
Archer Hume 為此設計了一個巧妙的「暗號實驗」。他在問題 A 中塞入了一句「暗號是 ZEBRA-7741」,然後在問題 B 的選項中,讓模型選出「另一道題提到的暗號」。結果顯示,Jev 給出正確暗號的概率是 0.00。但如果把這個暗號從問題 A 移出,放進大家共用的 State 文本裡,問題 B 給出正確答案的概率瞬間飆升到 0.90 以上。
這構成了題目之間存在嚴格物理隔離的強有力證據:共同材料對所有問題可見,但相鄰問題絕對無法互相「偷看」。
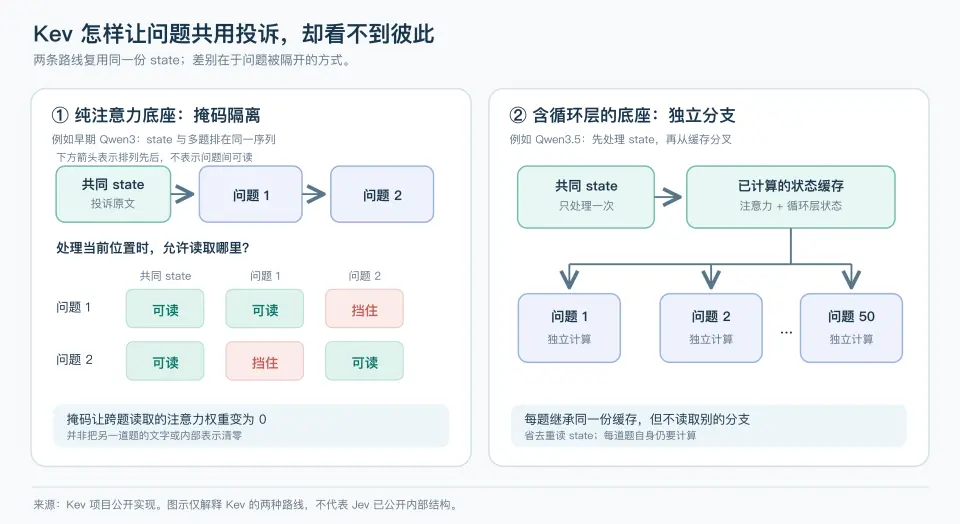
為了保證問題能分隔開,Kev用了兩套方法。
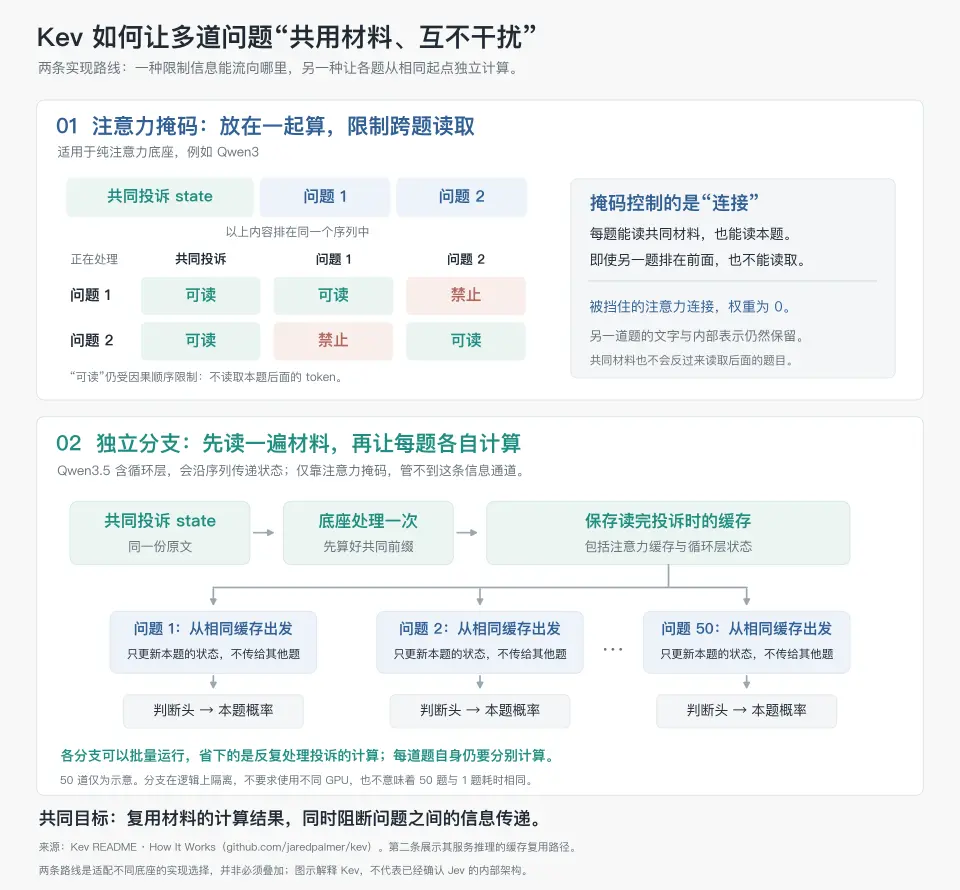
第一套方案是注意力掩碼,有了它,當系統把 [凍結的投訴原文] + [問題1] + [問題2] 放在一起計算時,只要模型正在處理問題 1,掩碼機制就會強行把問題 2 的區域變成數值為 0 的狀態,強制它在答題時只能「注意」到共同的投訴原文和它自己。
第二套方案是獨立分支復用,帶有循環特徵或特定架構的底座(如文中提到的 Qwen3.5)時,注意力掩碼是分不开的。所以用這些模型時,當模型讀完投訴原文,就會以這個凍結的記憶為起點,直接分裂出 50 條平行的高速公路(獨立分支)。
因為每一條分岔路都完美繼承了主幹道上那份已經處理好的投訴記憶,它們同樣享受了不用重讀原文的紅利。
第三站:計算選項
現在,公用了狀態,題目也都分別拆出來了,那在拆出來的一道選擇題內部,模型到底是怎麼去計算和處理那些候選項的呢?
此時,模型面前擺著幾個候選項,比如「財務」、「技術」。最傳統做法就是線性頭(Linear Head)加 Softmax。也就是 Zefan Open-Jev 版本試圖復現Jev時採用的模式。
你可以把它完全等同於絕對封閉的「黑屋盲審」。選手「財務」進黑屋表演,你根據一本死板的評分指南(這就是線性頭的功能),給了他 80 的絕對分,接著「技術」進黑屋,你給了 90 分。這兩人全程沒碰面,你也絕不拿他們作比較。最後,你用 Softmax 這個專門算百分比的數學公式,把 80 和 90 這兩個死分數,換算成了勝率。
在這個假想的流程裡,如果我們在選項池裡塞入一個毫無邏輯的干擾項,比如「壞天氣」,它頂多是充當分母裡的炮灰,讓所有人分到的百分比都縮水一點點。但是,因為你給財務的 80 分和給技術的 90 分已經用鋼筆寫死在紙上了,他們之間的「相對賠率」是絕對不可能因為一個炮灰的加入而發生任何動搖的。
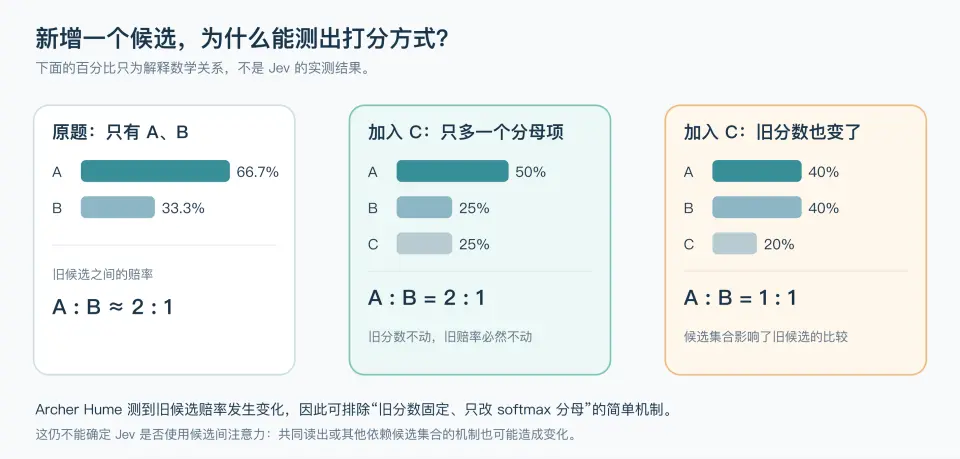
但測試者 Archer Hume 的測試證明,新增選項確實會影響到模型的分數差。他給一組正常的選項硬塞進去了「壞天氣」這個干擾項,並在十組隨機排列的測試中發現,這確實改變了財務和技術的相對賠率。這就直接判了「黑屋盲審」模式的死刑。
既然不是盲審,那就說明選手們在評委給出最終分數前,一定「互相看見」並產生了化學反應。開源界給出了兩種實現這種化學反應的圖紙。
第一種方案是由 Kev 項目設計的「指針頭(Pointer Head)」模式。你可以把它想象成「同場群面」。模型不再把選手關進黑屋,而是把「財務、技術、壞天氣」排成一排,讓評委一口氣全看完。
當評委看到站在最後面的那個選手時,他腦子裡已經形成了一個關於這場面試的「整體語境」。然後,評委站在最後的位置,像用手指一樣,挨個指回前面這幾個選手,根據此刻的整體印象來打分,這個動作就叫指針頭。評委在看完所有人之後再回頭去指指點點時,心態和參照系已經變了,給財務和技術打出的分數自然也就跟著發生了波動。
第二種方案是「評委會內部討論」,是由 NanoJev 等項目設計的「候選間注意力模塊(Inter-candidate Attention Module)」模式。這一次,模型既不是純盲審,也不是純群面。它先讓「財務」和「技術」分別去表演,把他們的表現濃縮成一串長長的高維數字評語,這個術語叫特徵向量。
這時候,兩張評語卡片還是隔離的。但之後一個單獨的小模型會把這兩張評語卡片,連同後來塞進去的「壞天氣」的評語卡片,一起扔進了一個叫「注意力模塊」的會議室裡。
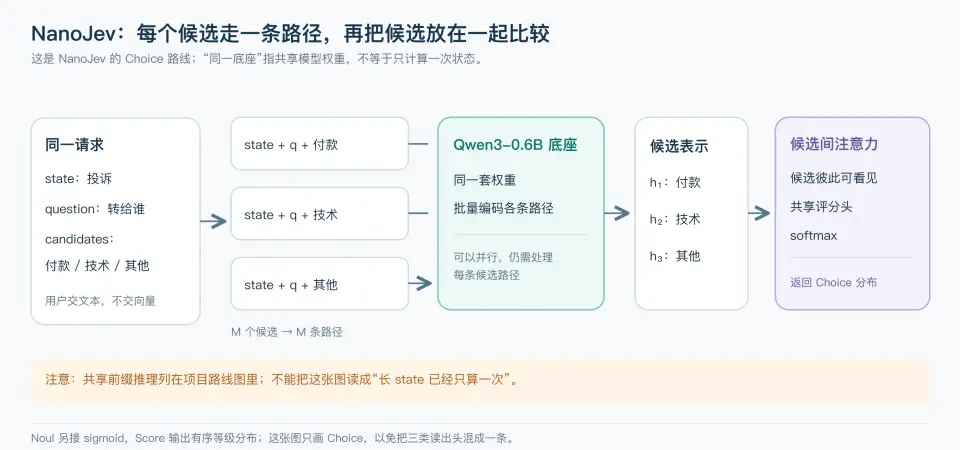
在這個會議室裡,這幾組代表選手的數字(特徵向量)會被互相比較權衡。本來財務和技術正比得難解難分,突然多出一張「壞天氣」的卡片參與討論,整個評委會的討論焦點和對比權重瞬間就被打亂重組了。
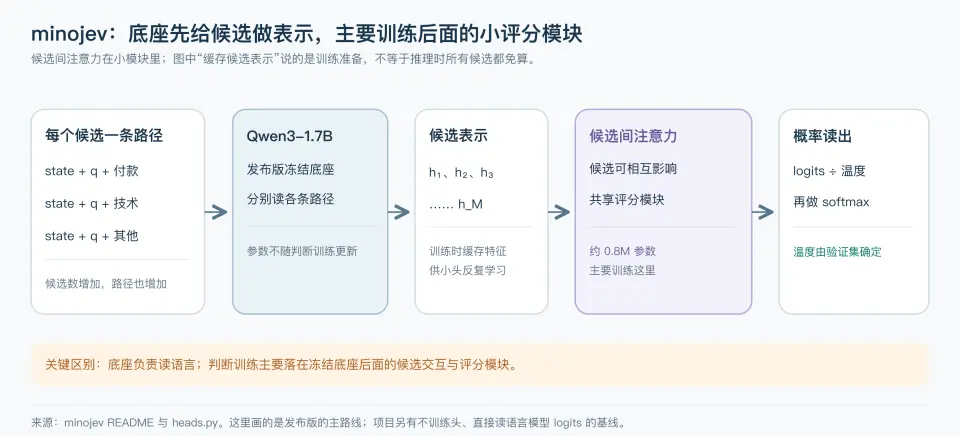
經過這番互相拉踩的內部會議後,再給出的最終分數,自然就不再是當初只有兩個人的模樣了。
為什麼Jev非得費盡心機,讓這些選項在底層代碼裡「互相拉踩」呢?這絕不僅僅是為了炫技,而是因為在真實的複雜業務裡,正確答案往往不是絕對的,而是「比」出來的。選項本身,其實就是解題的隱藏線索。
比如問埃菲爾鐵塔在哪裡?候選選項有A.歐洲 B.法國 C.巴黎。那當模型同時看到這三個選項時,這些選項本身,就成了破解這道題意圖的隱藏線索。這道題考的並不是大概位置,而是在考驗地理位置的最高精確度。
第四站:給出結果
流程的最後一步,就是解出一個具體的分數。
按照 TypeSafe 的官方說法,Jev 會直接返回概率數字,絕不逐字生成文本。
Archer Hume 的外部探測也印證了這一點,當他把候選選項從兩個喪心病狂地增加到兩百個時,API 返回的響應文本雖然變得極長,但服務端的處理時間並沒有等比例拉長。
這說明大模型確實跳過了最耗時的自回歸生成(也就是像 ChatGPT 那樣預測下一個詞)步驟。
那麼,這個最終的概率數字到底是從哪裡「掏」出來的呢?這個技術實現其實多種多樣,主要依賴它們在上一步計算選項時使用的方法。
沒有對選項交互做特殊處理的 openjev/openjev 的做法就是在模型本該生成第一個字的那個「作答位置」,直接去讀取大模型內部詞表中對指定候選字母 Token 的原始打分(Logits)。
加了指針頭的Kev 依靠那個能夠審視全局的指針頭直接輸出比對得分。而加了共享模塊的minojev 就依靠那個人工外挂的共享評分模塊吐出結果。
無論是哪一種提取方式,只要流程設計得當,大模型完全可以拋棄喋喋不休的文本生成,在運算的最末端直接抽取出精確的數學概率,完成一次系統級的自動決策。
到這裡,我們已經可以清楚的根據評測和還原,大致給出Jev的架構模式了。
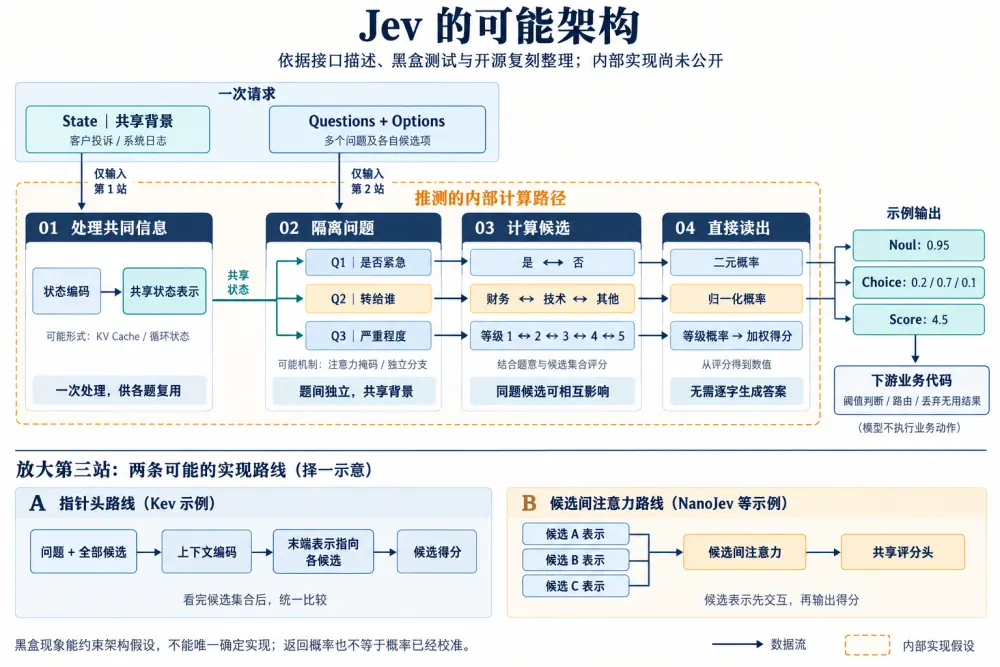
這個架構本身並不複雜,其中也很難有稱得上範式革新的部分。雖然確實是一個面對特定場景的優秀工程優化,但也僅此而已。
03
準確率的保證,是後訓練
架構只保證了速度,Jev 較高的準確率是如何達成的呢?
靠的就是TypeSafe 稱之為 RLCD(校準決策強化學習)後訓練方法。既然 RLCD 是個不公開的黑箱,我們也只能從開源社區的嘗試中看看它潛在的題目和算法實現方式。
一道用於RLCD訓練題的誕生
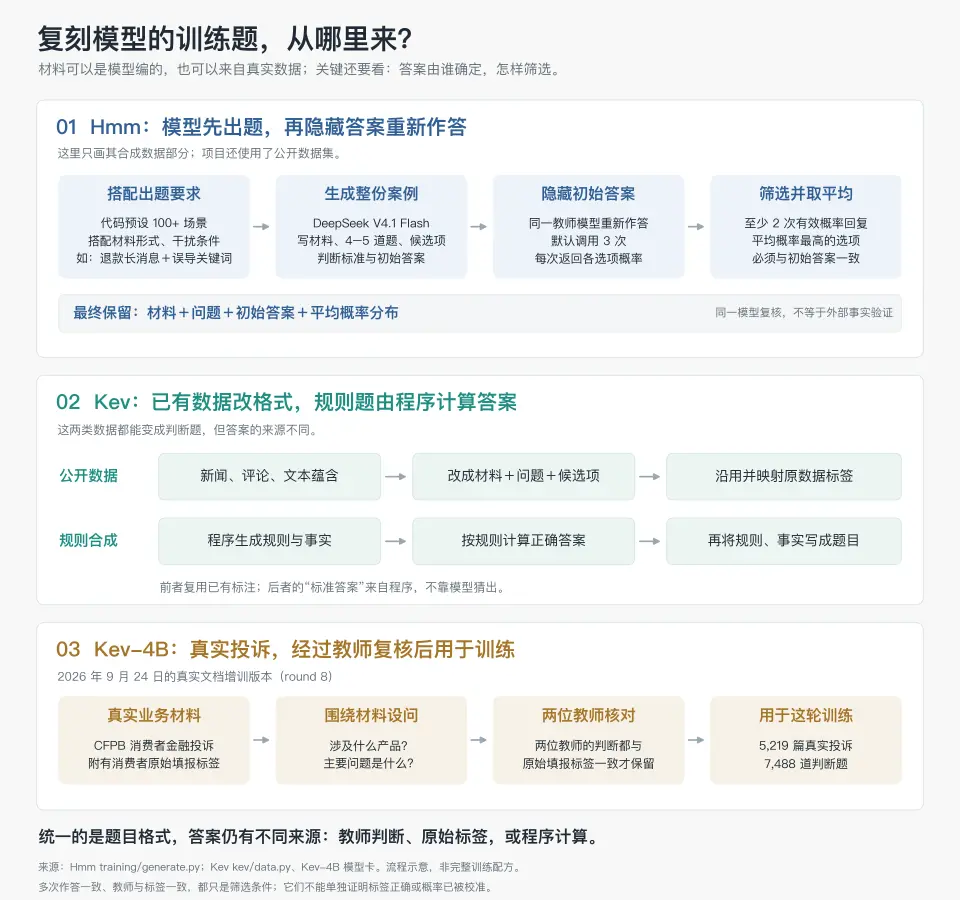
最簡單的就是直接合成,比如Hmm版復刻給出的方式。
研究者讓DeepSeek V4.1在代碼裡列出一百多個工作場景,包括退款處理、故障排查、檢索相關性、郵件分流等。
每次選一個場景,再搭配材料形式和出題要求。比如
用一段帶無關細節的長消息,寫幾組退款案例
加入一個容易被關鍵詞誤導的案例
每個案例附上四至五道選擇、是非或等級問題
DeepSeek V4.1 Flash 隨後生成整份材料、問題、候選項、判斷標準和答案。
之後測試這題能不能用就靠接著隱藏原答案,讓DeepSeek V4.1 Flash 再重新作答,默認調用三次,要求每次給出選項概率。代碼允許至少兩次有效回覆的題目才能用。
Kev 的方法,則是把當下已有的新聞分類、評論情緒、文本蘊含等數據集統一按規則轉換成判斷格式「材料+問題+候選答案」的模式。
模型再去生成規則和事實,算出答案,再把它們寫成文字。
9 月 24 日的 Kev-4B 還嘗試利用真實工作環境去構建題目。他們搜集了 5,219 篇真實消費者金融投訴,圍繞「涉及什麼產品、主要問題是什麼」製作題目。題目出來後,只有兩位不同的教師模型的判斷都與消費者原始填報標籤一致時,才保留標籤。
為了讓這個訓練更有效,復原的試題還會特別的出一些成對陷阱題。
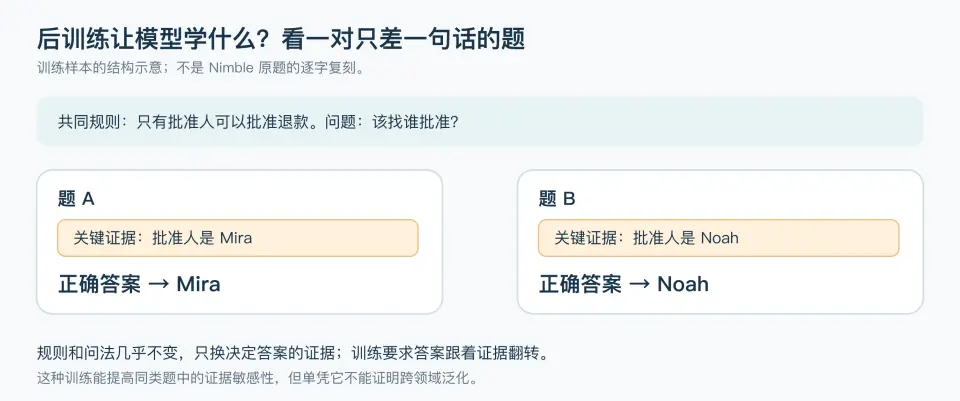
比如兩道題的規則完全一樣,只改掉一個關鍵名字(比如簽字人從有權限的 Mira 換成沒權限的 Noah),答案就直接翻轉。這種題目能有效防止模型通過Reward Hacking硬背答案,逼著它老老實實去做記問題和答案選項間的深層表徵和聯繫。
訓練方法,LoRA加蒸餾就夠嗎?
目前基本上所有用過後訓練方法的復現,用的都是「LoRA+教師蒸餾」這套方法去提高正確選項的概率。
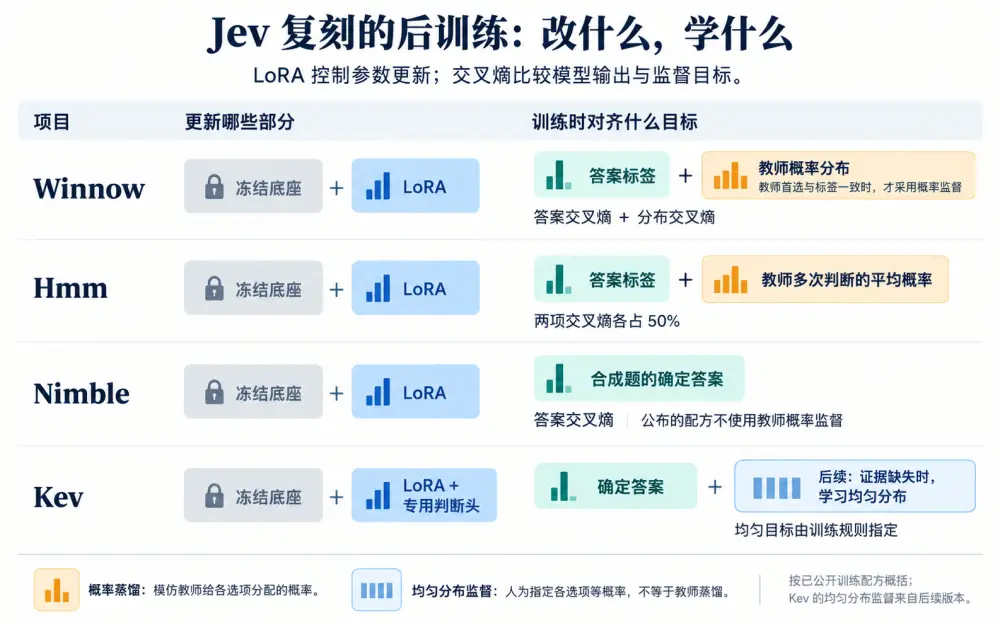
以Winnow 為例,它就選擇在 Gemma 4 12B 指令模型上進行 LoRA 微調。LoRA 的作用,是保留底座原有權重,訓練一小部分參與計算的修正參數,降低修改模型的成本。
Winnow 同時使用兩種監督。一種給出標準答案,要求模型把正確選項的概率提高。另一種提供教師對所有選項的概率分配,讓學生向這份分佈靠近。只有教師選出的第一名與標準答案一致時,Winnow 才採用第二種監督。
兩項都通過交叉熵計算訓練誤差。交叉熵在這裡承擔的工作,是檢查學生把概率分錯了多少。只有標準答案時,正確選項得到的概率越低,懲罰越大。
使用教師分佈時,訓練會推動學生模仿教師對各選項的分配。比如教師給 A、B、C 分別分配 80%、15%、5%,學生就會被要求學到這三個選項之間的區別。
一般來講 LoRA、蒸餾和交叉熵對於已經準備好題目、答案和參考分佈的任務(比如這種預測概率任務)來講已經足夠了,因為它們學的只是一個概率。
但蒸餾其實學的是教師概率,而非RCLD所說的現實概率。採用蒸餾的 Gap如何通過事實 / 教師的配比跨過,目前的復現也沒有什麼明確的思路。
理論上講想實現Jev的宣稱,那只能靠更大的數據量級和更有樣本效率的學習方式。
當然如果這麼個小的判斷模型就能達到大模型的判斷準確度,那沒解決這個它也是非常有用的。
校準,可能仍然是絕招
除此之外,Jev還有一個絕招,就是它宣稱的校準能力。
模型答對了多少題,與它是否準確表達把握,是兩件事。一個模型可能只答對七成,卻總報九成把握。
為了驗證 Jev 是不是在盲目自信, Archer Hume 還做了一場「測謊實驗」。
他先給 Jev 餵了 1200 道 MMLU(大規模多任務語言理解)測試題,然後把所有被選中的答案按系統報出的概率分成了十個檔次。經過複雜的加權計算,Jev 的校準誤差只有 0.031。
在 30 道簡單的三位數乘法中,Jev 答對了 86.7%,而它自己報出的平均把握是 83%,非常吻合。當題目換成難度較大的「兩步應用題」時,它的正確率暴跌到 32%,關鍵是,它報出的平均把握也跟著乖乖降到了 30%。
對此,後訓練一般確實可以改善概率表現,但很多時候會讓模型更加盲目自信。
為了還原Jev比較準確的校準能力,復刻版本用了一些方法。例如 Kev 會明確要求模型在證據缺失時降低確定性。它在訓練集裡加入了關鍵證據被移除的樣本,然後在答案中把他們的概率降低,因此模型會因無依據地把概率集中到某個選項而受到懲罰。
不過更多的復現做的只是一種治標不治本的溫度校準。
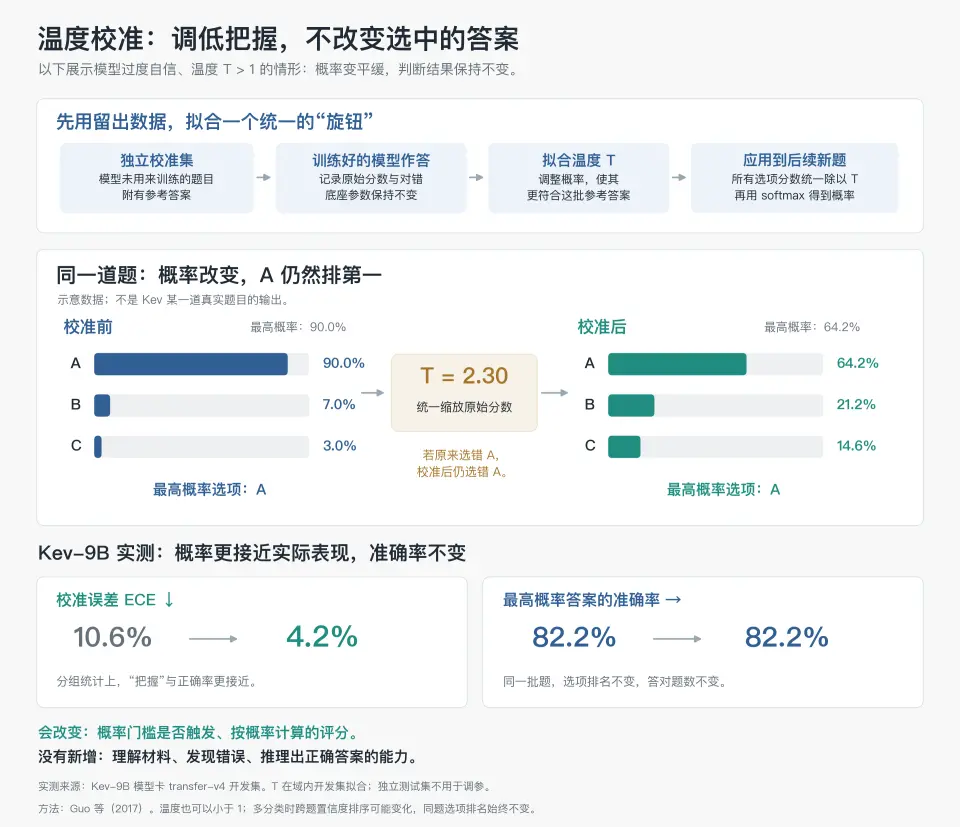
工程師會拿出一小批模型沒見過的測試題讓訓練好的模型做。如果發現模型過度自信,系統就會通過這批題,計算出整體自信度究竟該往回調多少格。
旋鈕一旦調好,模型以後再輸出概率時,就會被迫戴上一个謙虛濾鏡,變成一個更平緩的概率。
這不會改變同一道題的選項排名,因此最高概率答案不變。但概率門檻和按概率計算的評分可能改變。
這招還是比較有效的。比如 Kev-9B 在做完溫度校準後,校準誤差就從約 10.6 個百分點降到 4.2 個百分點,而答對的題數沒有變化。
說它治標不治本,是因為這其實來自整體自信的調低,而非來自更準確地區分自己是否應該自信。
假設Jev真的實現了校準率的有效提升,那可能他們在這裡還真的有些絕活兒。
04
Jev的適用邊界,到底有多大?
Jev 毫無疑問是有現實應用意義的。它把那些本來只需要快速決策的任務,還原給了快速的決策本身。
在Agent整個流程中,請求分類與路由、檢索結果排序,有明確要求的逐項檢查非常多。這些都是Jev可以發揮作用的地方。
比如客服分流、商品歸類、反饋分析、數據標註,都是我們在日常任務中常見的高頻場景。
但它的適用邊界有多大,決定了它是否是它宣稱的具有範式價值。
從目前的Benchmark看,它確實相對有一定通用性。Nimble 團隊用 13 組、共 3,880 條公開數據測了事實核查、意圖路由、語義蘊含、內容審核、醫學問答等任務,Jev 按數據集平均的準確率為 76.0%。
這說明jev確實能夠承接多種判斷工作。
但真正的通用還有兩個坎。
第一個是困難任務,如果只能做簡單判斷,其適用範圍就很有限。
首先我們要先定義什麼是判斷中的困難。一般我們認為,步驟越多、條件越多、細節理解要求越細緻的問題越困難。
識別「用戶想退款」只需理解字面語義,但判斷「這筆退款該不該批」卻需要核對日期、計算期限、對比條款的優先權,明顯更難。而如果一個判斷需要推理三步才能到結果,那第三步需要第二步的結果,這就是多步驟的依賴。 在第一步找錯政策,後面的計算即使完全正確,最終也會判錯。
在 JevBench 的困難題測試中,JevBench 規定了一些判斷題相關難度的因子,包括多條件判斷、連續查找證據、比較日期和數字三個選項。在這批題裡,Jev 的多步查找準確率為 85.7%,長政策判斷為 60.5%,時間與數字判斷只有 26.7%,都遠遜於Flash級的模型。困難題合計,Jev 答對 74.1%,DeepSeek V4.1 Flash 為 95.0%,和人類專家差不多同水平。
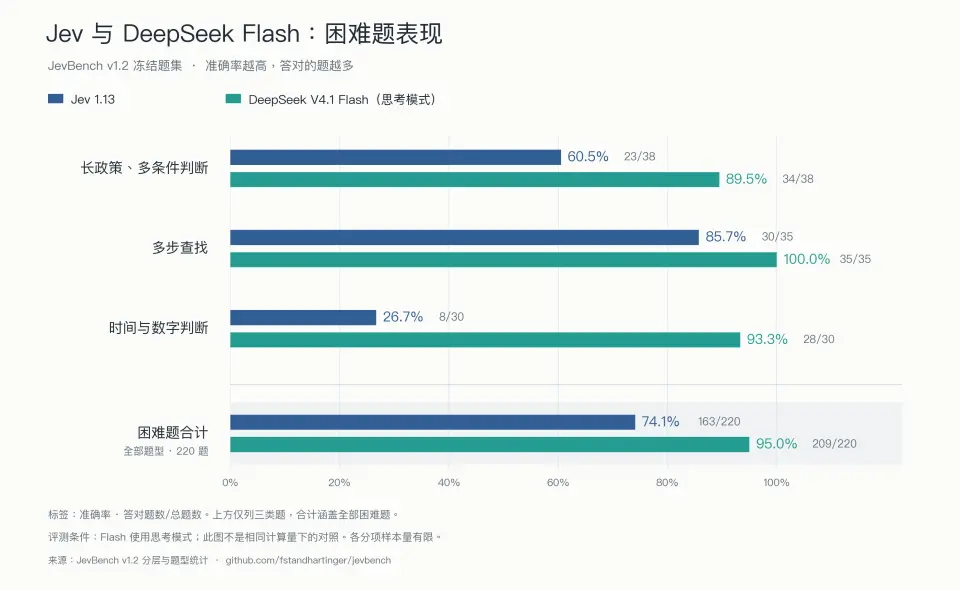
雖然相應測試的請求中位耗時約為 0.67 秒和 3.15 秒,jev的速度快了近四倍。但如此大的準確率差距,對於一些要面對複雜任務的判斷(比如大家都希望的炒股)來講,做什麼選擇基本不言而喻。
而且這裡的多步查找準確講並不是多步推理,其中主要涉及查找。在Archer Hume的測試中,Jev在簡單乘法下正確率高達 86.7%、但換成兩步應用題正確率就一下下降到了 32%。
briantrust做了個更細緻的測評,也可以看出jev在困難問題上的跛足。它對比了jev和GPT 5.6 Luna模型,讓模型從兩個候選回答中選出正確的一个,最終比較了 616 道有效題對 。兩個模型在知識題差距只有 1.6 個百分點 ,數學與推理擴大到 19.3 個百分點 ,代碼達到 20 個百分點。
因此困難判斷這個坎兒,jev很難說自己已經闖過去了。
另外一個坎兒就是泛化。
如果jev真的能通用,它應該能夠做到比較好的泛化,從它學習的東西裡能提升其他問題判斷的精度。
否則的話,它只是一个適用範圍稍微廣一點的「專用判斷模型」,和之前的判斷模型拉不出什麼差距。
現有的多項直接測試證據可以證明 Jev 確實具備一定的泛化能力,但這種能力在領域內極不穩定。而一旦跨出熟悉的場景,它的表現依然面臨巨大風險。
首先,在完全相同的任務和事實下,Jev 的判斷極易受到信息呈現方式的干擾。OpenProse 實驗在不改變任何事實、問題和計算量的前提下,當關鍵關係被集中放在文本靠前的位置時,Jev 的正確率為 80.5%,但當這些關係被移到中間時,正確率直接腰斬至 40.9%。
這表明,即便沒有更換業務領域,Jev 的表示穩健性也嚴重不足。它的判斷能力高度依賴於外部程序如何給它喂數據。
其次,當面對同一評測體系下的新題目時,Jev 的表現波動也很明顯。JevBench 新版 v1.4 增加的 308 道封閉難題,Jev 的正確率從公開題的 86.6% 暴跌至 36.7%,作為對照,使用思考模式的 DeepSeek V4.1 Flash 則維持在了 94.8%。
Jev 過去在公開題上取得的高分,無法自動延續到未知的複雜測試中。
當測試進一步推向真實的業務遷移時,Jev 的表現同樣喜憂參半。正面例子來自 Agent Journal 的提示注入檢測,Jev 在原測試集上的準確率為 83.65%,直接遷移到另一份包含兩千多條外部數據的測試集中,準確率甚至提升到了 95.58%,遠超傳統基線模型。
這說明在某些特定任務上,它確實能適應數據來源的變化。
但在邏輯更複雜的業務中,這種泛化往往會失效。Scarif Labs 曾用它來判斷軟體更新是否安全。當把模型從一個軟體生態搬到另一個生態時,Jev 區分安全與危險更新的能力指標(AUROC)從 0.851 降到了 0.605(接近隨機亂猜的 0.5)。
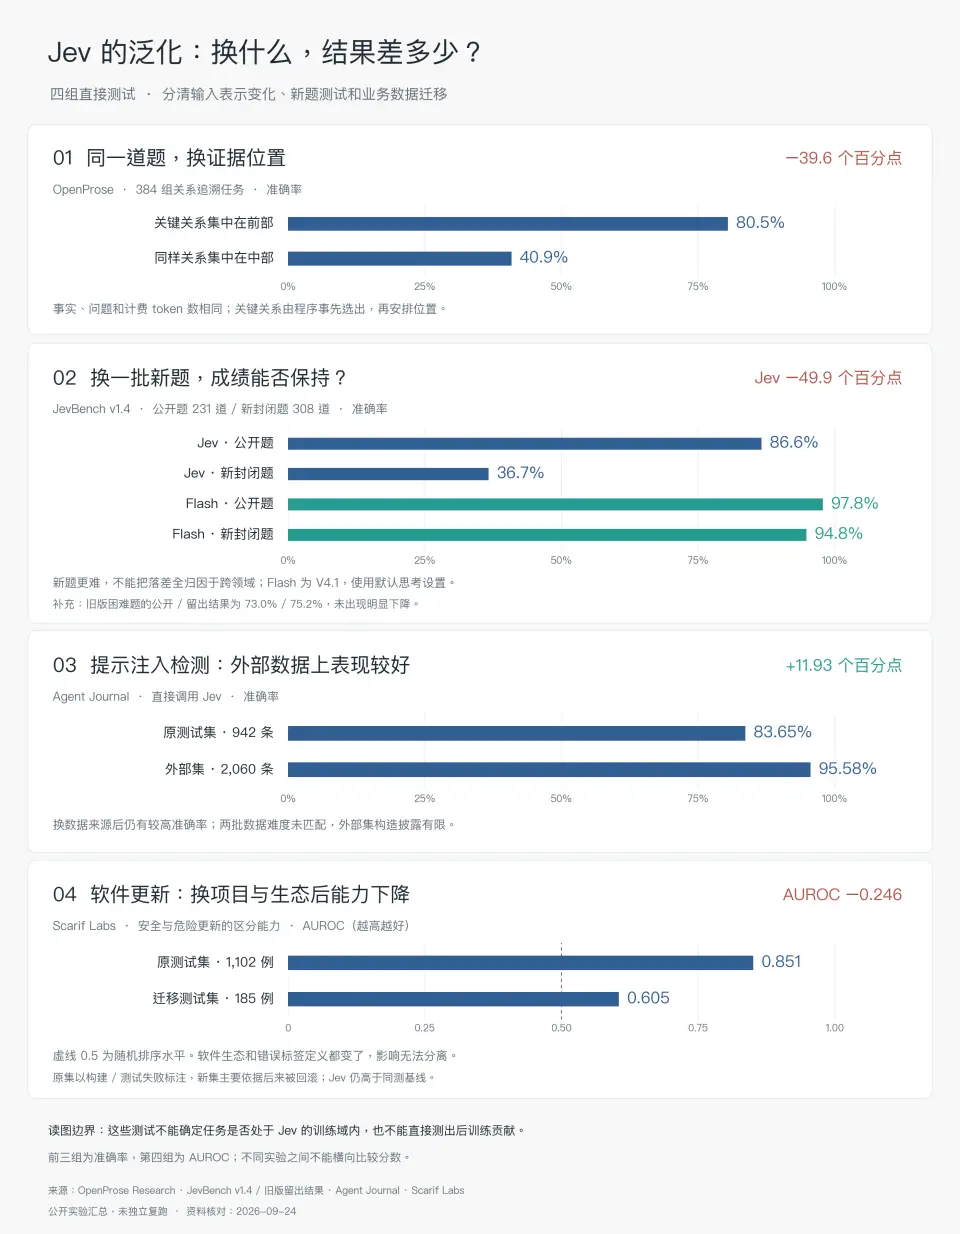
因此,我們至少可以說,目前Jev的泛化應該是比較有限,且存疑的。它距離通用泛化的標準,還差得很遠。
既然Jev沒有邁過通用的這兩道坎,我們現在應該在什麼地方用它呢?
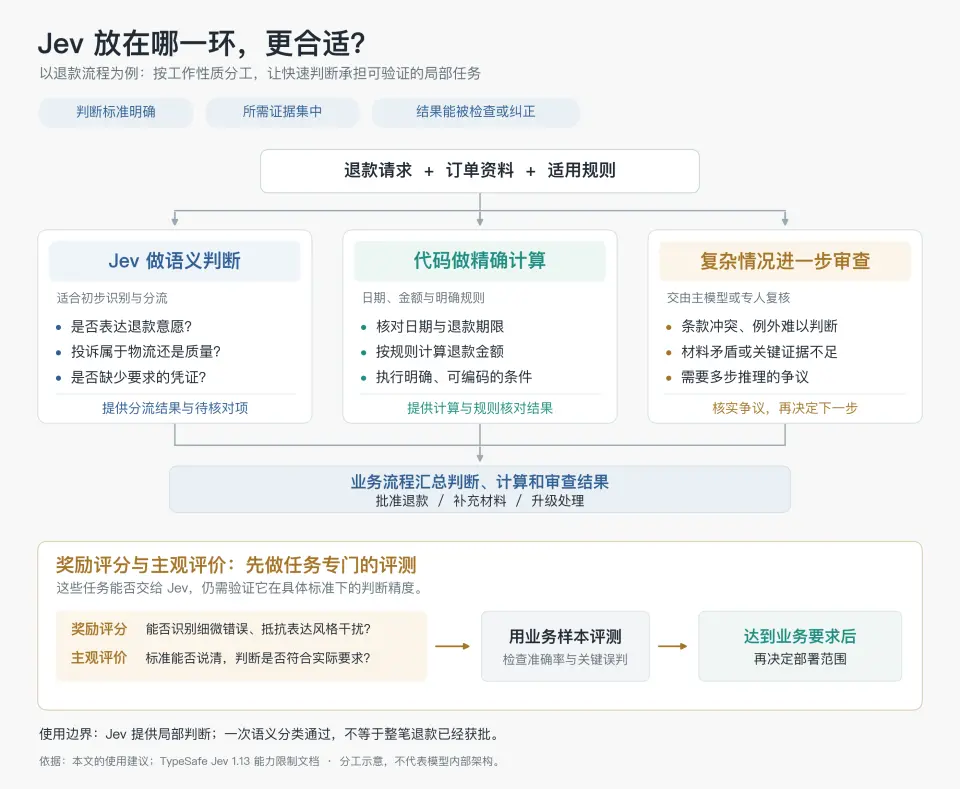
更合適的定位,是把 Jev 放在標準明確、證據集中、判斷結果能夠被檢查或糾正的環節。
仍然以退款為例。判斷用戶有沒有表達退款意願、投訴涉及物流還是商品質量、是否需要補充憑證,都是可以單獨驗證的語義判斷。這些問題出現頻繁,通常不需要生成一段解釋,也不必每次都讓主模型展開推理。Jev 可以在這裡承擔初步分流。
但要批准退款,事情就變了。是否超過期限,需要代碼核對日期、退款金額,需要按規則計算、遇到條款衝突或例外情況,還要進一步審查。TypeSafe 自己也建議,把數學運算和日期比較交給代碼,並儘量減少判斷中的多層依賴。
這樣分工,才能把它的速度用在合適的位置。
至於更依賴精度的用途,例如獎勵模型,要判斷的往往正是那些表面合理、實際有錯的回答。模型還需要分辨細微差異,抵抗表達風格的干擾。
而對於那些規定規則都比較困難的任務,比如包含比較主觀的評價的規則,至少要先試試Jev的準確率後再部署。
這時候,Jev 可以作為候選方案,但採用者仍需要任務專門的評測。
此外,還有一筆帳不能漏掉。Jev 自己響應快,不代表加上它以後,整個 Agent 就更快。
如果它能提前處理一批簡單請求,讓這些請求不再調用主模型,速度和成本優勢就有機會兌現。
但如果每次都先調用 Jev,隨後仍要調用同一個主模型,那麼新增的判斷必須省下足夠多的後續工作,才能抵消自己的耗時與費用。
在 GitHub 上的一組 Agent 記憶檢索實驗中,系統引入 Jev 來判斷檢索到的信息是否有用。為了避免 Jev 錯誤地丟棄有用信息,開發者不得不反覆調整判斷標準。
雖然最終讓 20 個常規案例全部通過,但代價明確,系統的總延遲從 649 毫秒升至 1087 毫秒,每千次調用費用也翻了兩倍多。
如果主模型本身就具備從繁雜材料中篩選答案的能力,在前面硬加一個 Jev 作為判斷器,不僅多了一道等待時間,還承擔了因誤判而漏掉關鍵證據的風險。
05
Jev的顛覆性,到底有多真?
討論到最後,Jev留給我們的核心問題是,它到底在學習什麼?
按理說,一個用於判斷的模型,它學習的表徵就是通過新增的事實,來作出有效的判斷。
這幾乎是難度最高的表徵之一。
通用判斷需要同時調用多種能力,不能因為最後只輸出一個概率,就認為它比生成答案容易。
拿退款舉例。看到「我想退款」,識別退款意願,主要依賴語言理解。但問「按這份政策,該不該批准退款」,模型必須理解政策,把購買日期、商品狀態等事實對應到具體條款,再處理例外。
這基本上是Jev背後語言模型的能力底座。
最後一個問題「退款是否有助於留住這位客戶」,就需要預測行為後果。這才是模型需要訓練的部分。
它需要學會哪些事實影響結果、在什麼條件下影響,以及換個場景後這些關係是否仍然成立。
三道題都可以輸出「是的概率」,背後需要的知識和計算卻不同。
為了跨過了從「預測別人怎麼判斷」到「可靠預測行動後果」的距離,我們到底需要多少數據和訓練?
至少對於人來講,決策的綜合判斷,是最難學習的一件事。基本上和我們之前文章中提到的品味、綜合的功利計算一樣複雜。
因此,我非常懷疑這篇文章目前揭秘的這套學習方法是否能承載這樣複雜的表徵。
當然,我們可以將 Jev 視作一個極具巧思的工程利器。
在規則清晰、材料齊備的業務管線裡,它能大幅削減等待時間與算力成本,價值毋庸置疑。
但在證明它確實學到了某種通用的判斷法則之前,讓它戴上「範式革新」的王冠為時尚早。
 風險提示