一個字都不會寫的 Jev,憑什麼成為 ChatGPT 之後最火的模型?
 核心觀點

 TypeSafe AI 推出的 Jev 是無文本生成能力的語義決策模型,專做高頻確定性判斷,輸出強類型選項與置信概率,速度約快 200 倍、成本約低 400 倍。
這兩天徹底爆火的 Jev,是一個完全不會聊天、不會寫程式碼,卻能把很多 AI 決策成本降低 400 倍的全新模型。
但是很多人對 Jev 還是雲裡霧裡,
我詳細研究了一下,希望這篇文章能夠讓你一文徹底搞懂 jev,正好今天 jev 全員可用了,可以去實操一下
不想看文字版的,我用 GLM-5.3 flash 做了一個 5 分鐘的講解視頻,效果還挺好的,直接看視頻就行
廢話不多說,正文開始。
jev 沒有任何文本生成能力。
但發布至今,它引發的討論熱度幾乎是 ChatGPT 以來最高的一次。
過去兩年,大家習慣了把所有需求都丟給通用大模型。
但現實業務裡,軟體系統每天面對的大量請求,根本不需要寫一篇洋洋灑灑的長文。
系統真正需要的,往往只是一個個極小的確定性判斷:
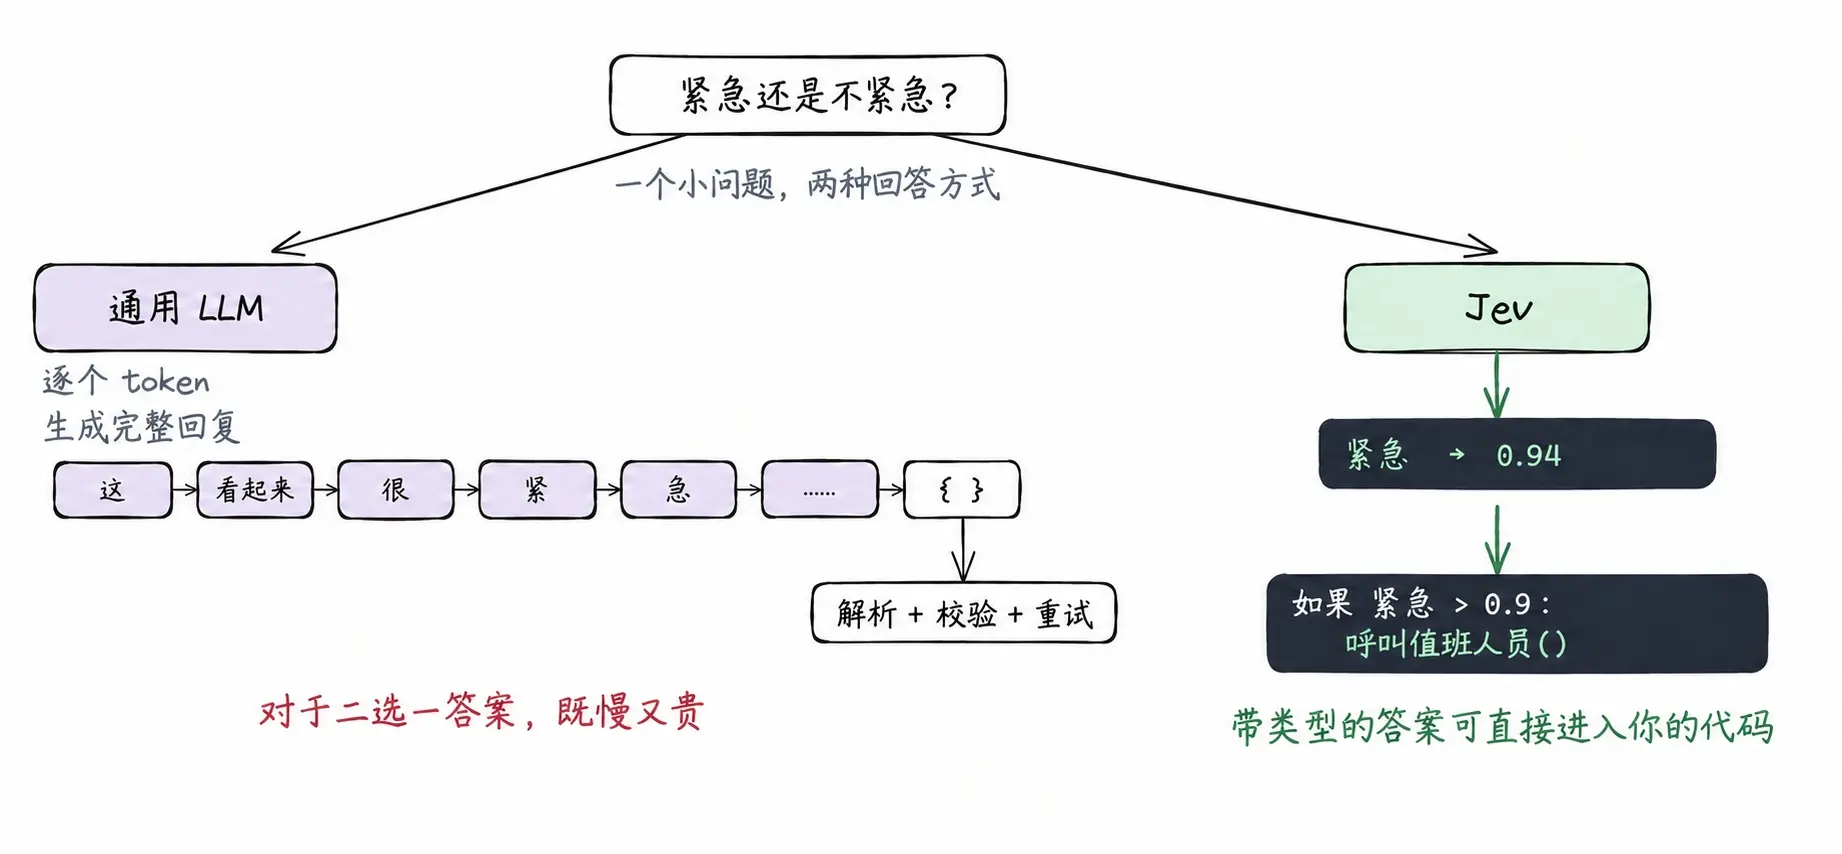
這封工單緊不緊急?
這個指令該分發給哪個下游模型?
用戶輸入的終端命令有沒有刪庫風險?
剛剛檢索出的這段知識到底能不能回答用戶的問題?
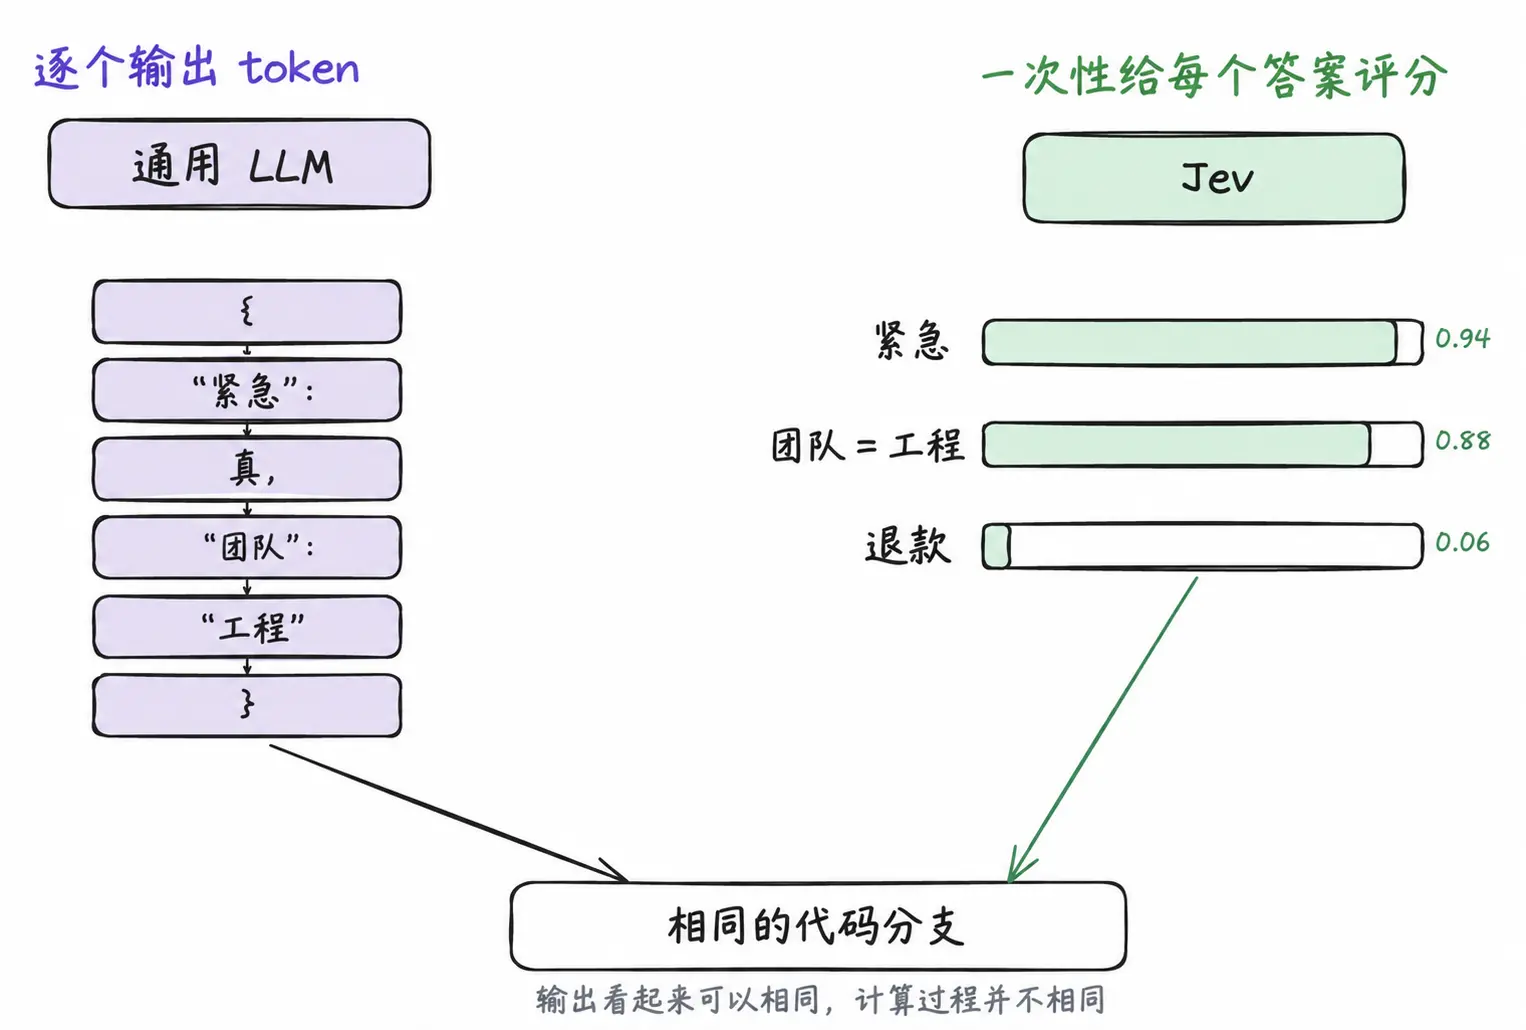
以前做這些判斷,開發者必須讓大模型逐字生成回答,再用程式碼去解析 JSON,遇到格式報錯還得重試。
這不僅速度慢,而且費用昂貴。
TypeSafe AI 推出的 Jev,就是專門為了解決這批決策需求而設計的。
他們把 Jev 稱為"系統一(System One)模型":輸入一段非結構化數據,直接輸出強類型的選項和精準的置信概率。
傳統大模型做判斷,為什麼太重了?
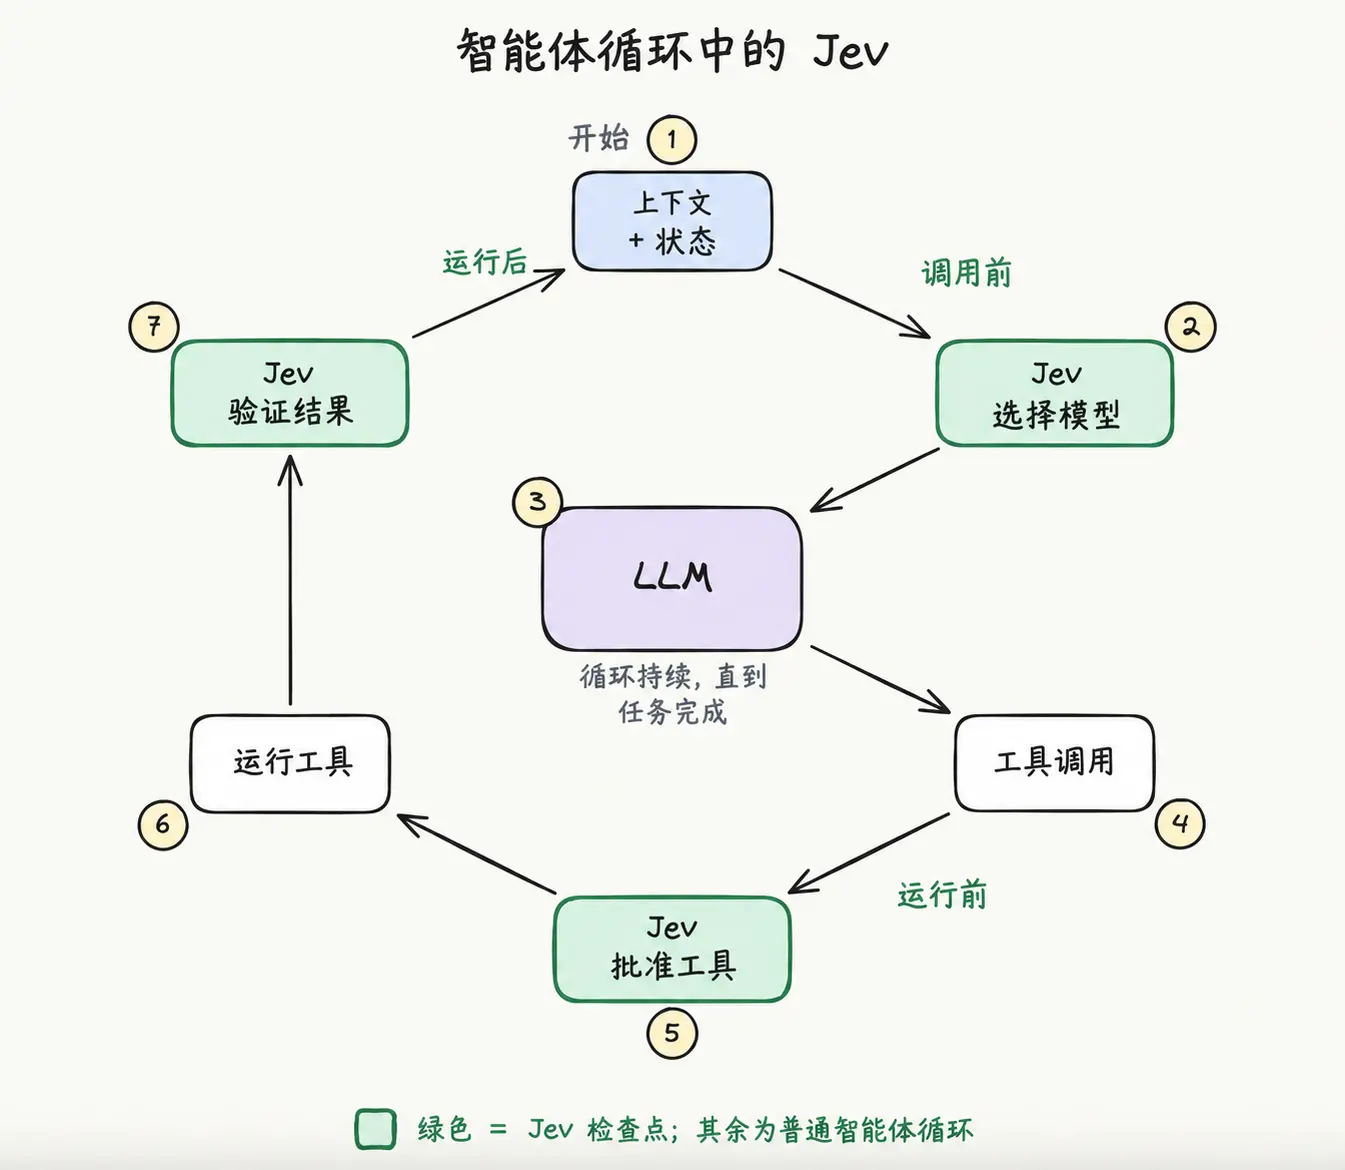
在典型的 Agent(智能體)循環裡,系統每走一步都要做決策:
python
while not done:
    action = llm(context)
    result = run_tool(action)
    context += result
在這個循環中,模型要選工具、要檢查執行結果、要判斷有沒有風險、要決定任務是否完成。
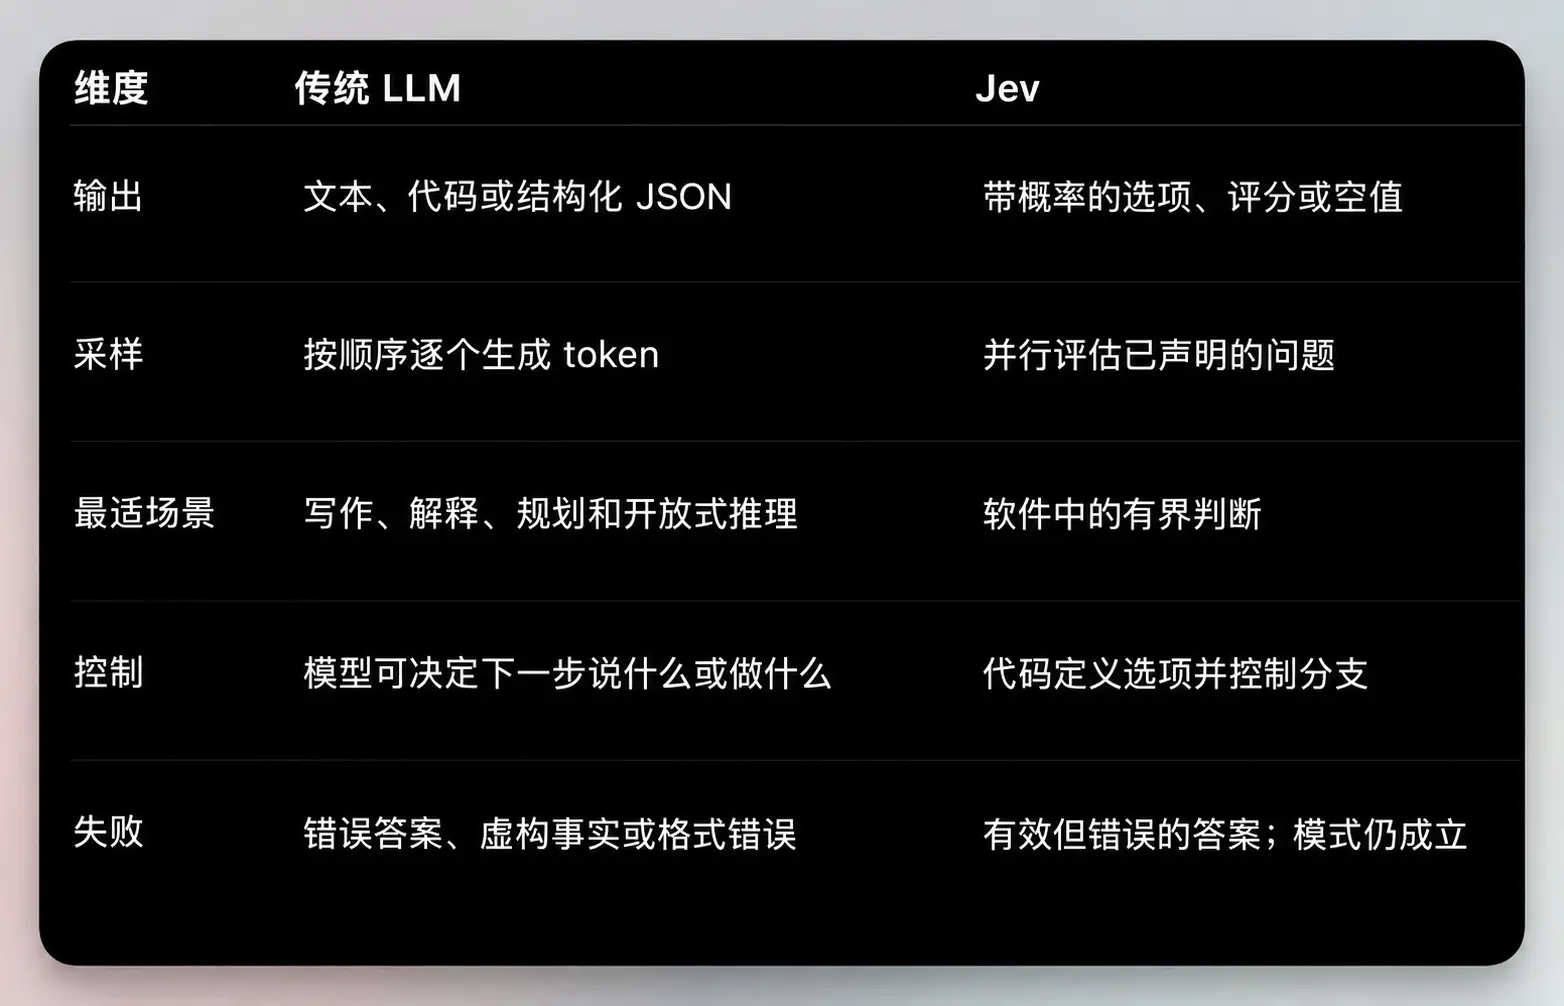
哪怕最終的決策只有一個單詞,比如"finance",傳統生成式模型也是一個 Token 一個 Token 地往外吐。
你既要為輸入付錢,也要為生成等待。
Jev 的核心邏輯非常直接:
當程式碼已經知道全部可能出現的答案時,使用逐字文本生成就是一種巨大的資源浪費。
Jev 到底怎麼工作?
Jev 的本質是一個語義決策引擎。
調用 Jev 時,你只需要給它兩樣東西:
State(狀態) :描述當前情況的文本或 JSON。
Questions(問題) :你希望它基於這個狀態做出的決策。
每個問題在提交前就必須固定輸出類型。Jev 原生支持三種基礎數據類型:
Choice :從你定義的列表中挑選一個選項,並返回所有選項的概率分佈。
Score :把輸入映射到你定義的有序等級上,比如低、中、高。
Noul :布林判斷,返回該命題為真的概率值(0 到 1 之間的小數)。
一個典型的請求長這樣:
json
{
  "model": "jev-latest",
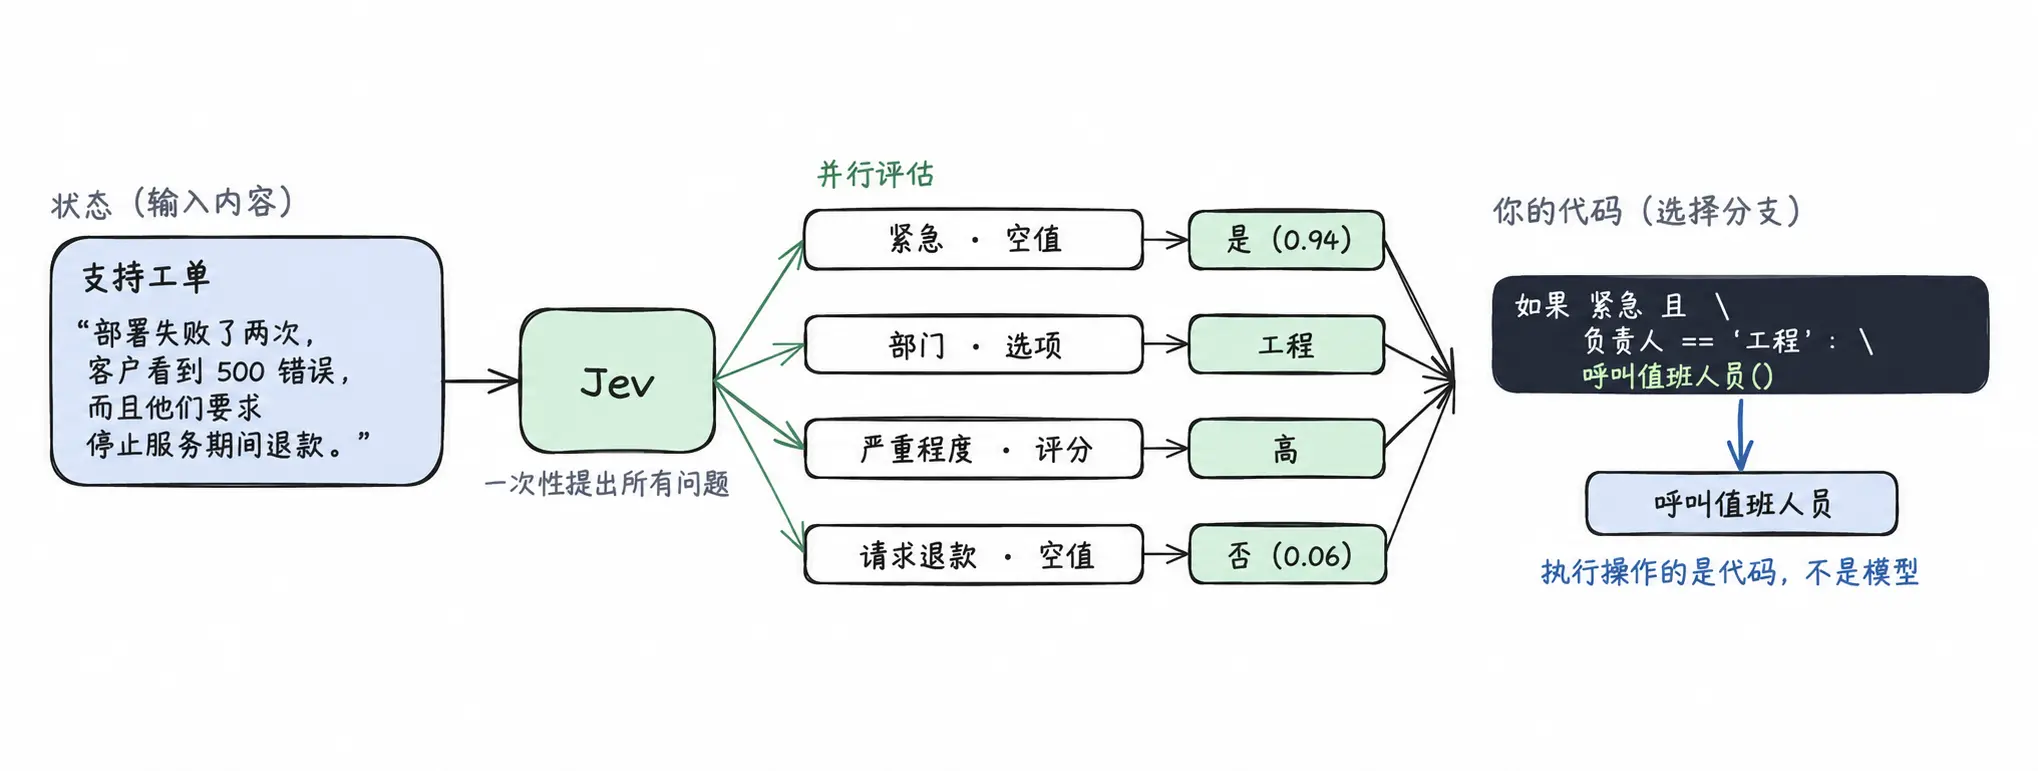
  "state": "部署失敗了兩次,用戶端開始出現大量 500 錯誤。",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "這個問題是否需要立即處理?"
    },
    "owner": {
      "type": "choice",
      "instructions": "這個問題應該分派給哪個團隊?",
      "criteria": {
        "engineering": "產品故障與服務宕機",
        "billing": "扣費、發票與退款問題",
        "sales": "定價諮詢與新客戶開戶"
      }
    }
  }
}
Jev 返回的不是一段解釋,而是一個確定的概率值和一個團隊概率分佈。
沒有任何多餘廢話,它也不會憑空編造出第四個不存在的團隊。
業務程式碼直接接管邏輯控制:
python
if urgent > 0.9 and owner == "engineering":
    page_on_call()
elif confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(owner)
很多工程師把它形容成"帶語義理解能力的 switch 語句"。
業務分支仍然牢牢掌握在傳統程式碼手中,Jev 只負責提供程式碼本身算不出來的語義判斷。
核心指標:快 200 倍,便宜 400 倍
Jev 支持在單次請求中並行評估所有問題。
這意味著你不必串行提問,可以把針對同一段內容的所有獨立判斷一次性發過去。
官方公布的實測數據:
端到端延遲:70 到 500 毫秒。
價格:每百萬輸入 Token 僅需 0.042 美元,輸出 Token 完全免費。
在官方給出的多項工作流實測對比中,它的綜合執行速度大約是傳統大模型工作流的 200 倍,綜合成本降低了接近 400 倍。
即便在複雜業務環境下把這些數據當成理論上限來看,它所帶來的效率提升也是數量級維度的。
概率與置信度,才是關鍵設計
只給一個分類標籤,往往不夠安全。
假設 Jev 判定一個工單屬於"財務團隊",返回結果如下:
json
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.52,
    "technical": 0.46,
    "sales": 0.02
  },
  "confidence": 0.18
}
財務獲得了最高票,但技術支持拿到了 46% 的概率,整體置信度只有 0.18。
如果系統直接自動分配,極易出錯。
有了這層概率分佈,開發者就可以在程式碼裡明確劃線:
高置信度 :自動執行小風險邏輯。
中置信度 :調用更強的大模型複核,或要求用戶二次確認。
低置信度 :直接轉入人工審核隊列。
Jev 採用了"基於校準決策的強化學習(RLCD)"訓練方法。當模型給出 90% 的概率判定時,其真實準確率也能高度收斂在 90% 左右。
必須澄清的事實:Jev 真的不會幻覺嗎?
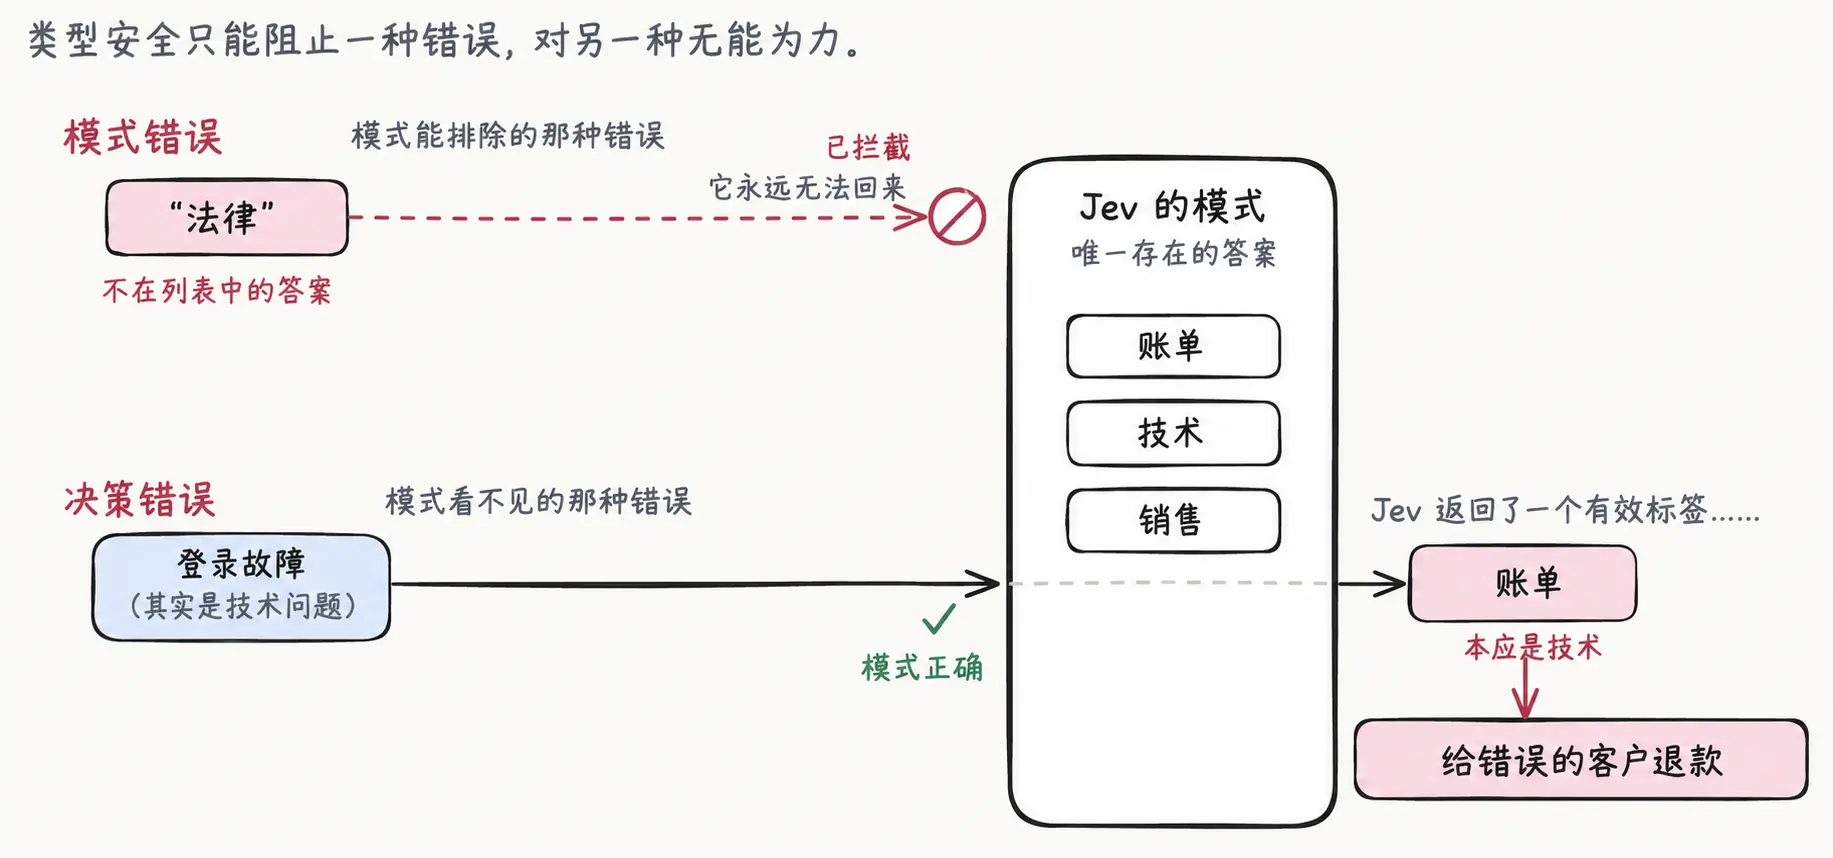
官方宣傳中提到"Jev 不會產生幻覺"。這個說法成立的前提非常嚴格。
Jev 絕不會跳出你給定的 Schema 返回格式之外的內容。如果你定義了 A、B、C 三個選項,它絕對不會返回 D,更不會輸出亂碼 JSON。
但這絕不代表它的判斷永遠正確。
類型安全保證的是輸出結構不崩潰,並不保證業務判斷不出錯。
一個符合類型定義的錯誤判斷,依然可能錯誤地退款、錯誤地分發故障工單。
準確的理解應該是:Jev 保證不會破壞程式碼契約,但它依然有概率選錯選項。
Jev 最適合放在系統的什麼位置?
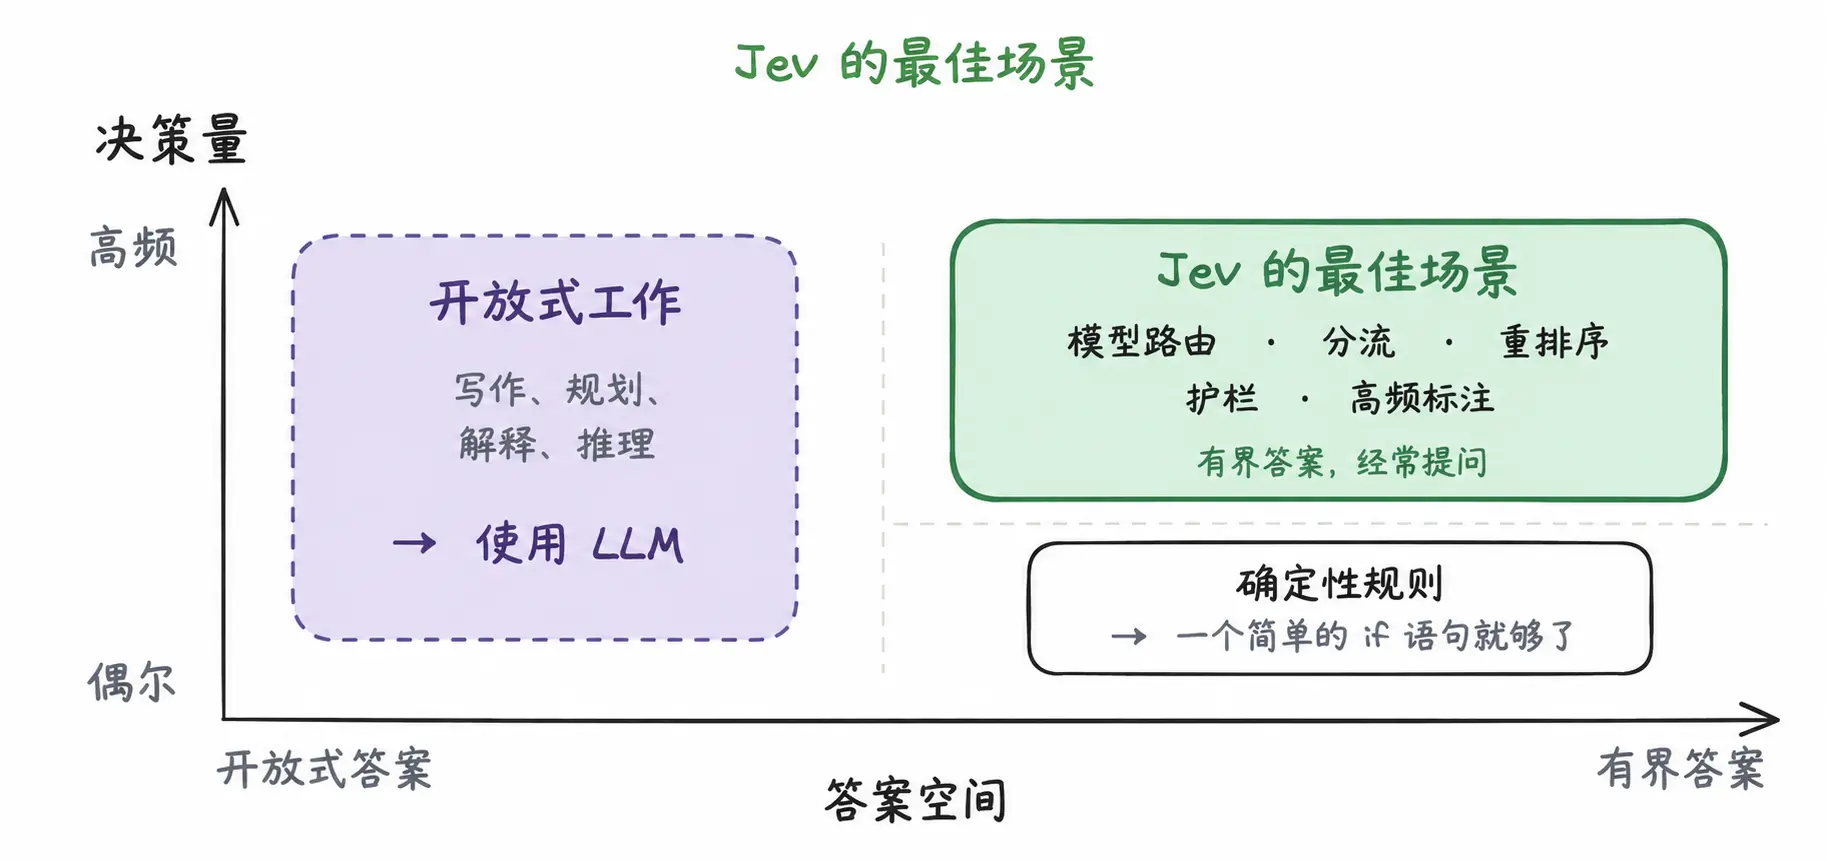
Jev 的定位非常清晰:它設計出來是配合大模型,不打算取代大模型。
大模型負責寫程式碼、寫方案、做長文本推理與溝通。
Jev 負責圍繞在它周圍,做高頻、快速的邊界控制。
目前最成熟的落地場景有三個:
模型路由(Model Routing)
面對用戶請求,先由 Jev 判斷任務難度。簡單的檢索和改寫直接分派給廉價小模型,高難度的架構設計再路由給昂貴的推理模型。
工具執行風控(Tool Risk Gating)
在 Agent 調用終端命令前,用 Jev 判斷命令是只讀、可逆還是破壞性的。破壞性操作自動暫停,等待人工授權。
結果校驗與監管(Verification)
在任務結束前,讓 Jev 快速檢查:測試用例跑通了嗎?Agent 是否陷入了重複調用的死循環?輸出是否違背了預設規則?
什麼時候絕對不要用 Jev?
任何不需要它的地方,都不要強行引入:
答案空間不確定時 :如果要寫文章、做總結、生成代碼,必須使用傳統大模型。
確定性邏輯運算 :數學計算、字符計數、日期對比,直接用純代碼實現,純代碼永遠比模型更便宜、更快、更可靠。
需要複雜長鏈條推理時 :多步驟邏輯推演應該交給具備思維鏈能力的推理模型,或者把大問題拆解成多個離散的小問題再交給 Jev。
如何開始?
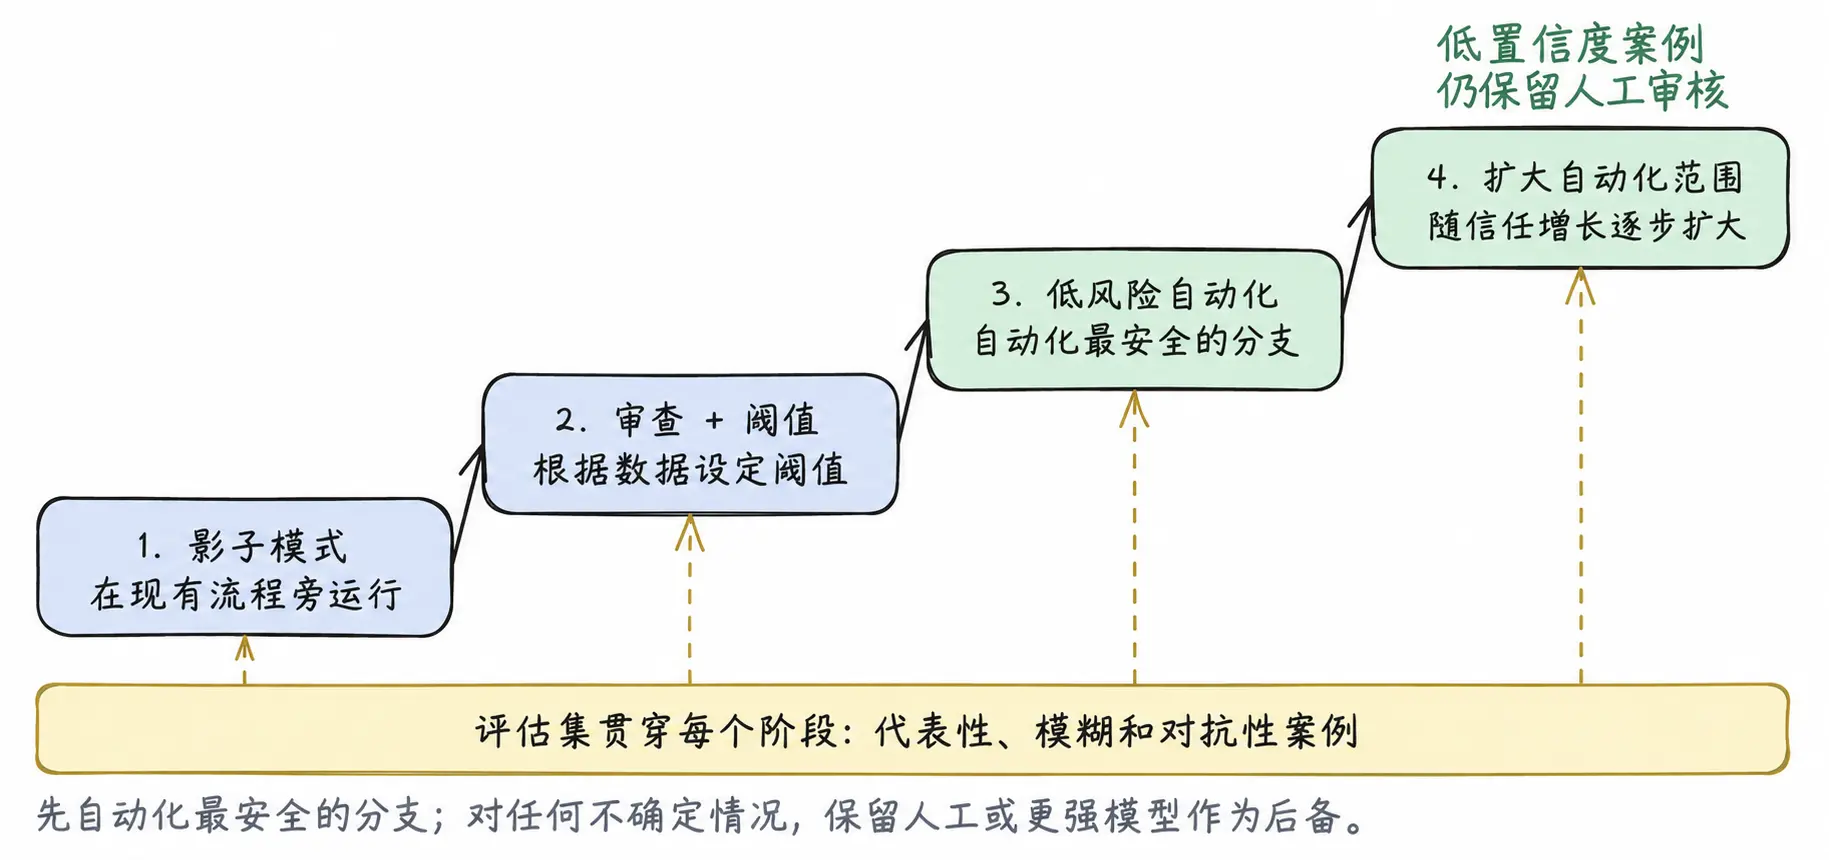
不要一上來就重構核心業務。
最穩妥的接入方式是:
挑一個目前維護成本最高、容易出錯的正則規則,或者一個調用大模型只為拿到是非判斷的節點。
明確寫出這個節點所有可能的選項定義。
開啟 Shadow 模式(影子模式),讓 Jev 和現有邏輯並行運行,收集數據並校準置信度閾值。
確認準確率達標後,再正式切換流量。
目前 TypeSafe 已經完全放開訪問,無需等待名單。註冊贈送 5 美金額度,相當於可以直接測試約 1.2 億個 Token 的輸入量。
整個行業在過去幾年裡,習慣了用文字生成去解決一切問題。
但在很多工程系統裡,代碼需要的往往不是更多優美的文字,而是一個毫秒級響應、不破壞格式、成本極低的準確判斷。
這也是 Jev 能夠迅速引爆開發者圈子的根本原因。
 風險提示