巨型平台與微型軟體企業兩極崛起,中型單點解決方案最危險
 核心觀點

 537 家美國獨角獸仍背著 2021-22 年的舊估值,“AI 原生”正從加分項變成被拆穿的風險點。投資者開始追問:把你的 AI 標籤拿掉之後,還剩下什麼?
原文作者:Venture Curator
原文編譯:深潮 TechFlow
深潮導讀:537 家美國獨角獸還在背著 2021 年泡沫期的舊估值,而"AI 原生"這個標籤正在從加分項變成被拆穿的風險點。對正在融資或持有期權的從業者來說,這篇文章幫你分清哪些估值是真實的,哪些只是沒人戳破的紙面數字。
537 家美國獨角獸還在背著 2021-22 年泡沫期的估值。它們還真实吗?
創始人和早期員工通常被教育要把上一輪估值當作記分牌。那是股權結構表上的數字,是新聞稿裡的數字,也是所有人用來估算自己股權價值的數字。
但 PitchBook 2026 年第三季度量化展望報告的新數據顯示,對美國大多數獨角獸來說,這個數字已經好幾年沒有被市場真正檢驗過了。
PitchBook 研究了所有活躍的美國獨角獸,按它們最近一次完成定價融資的年份分類。
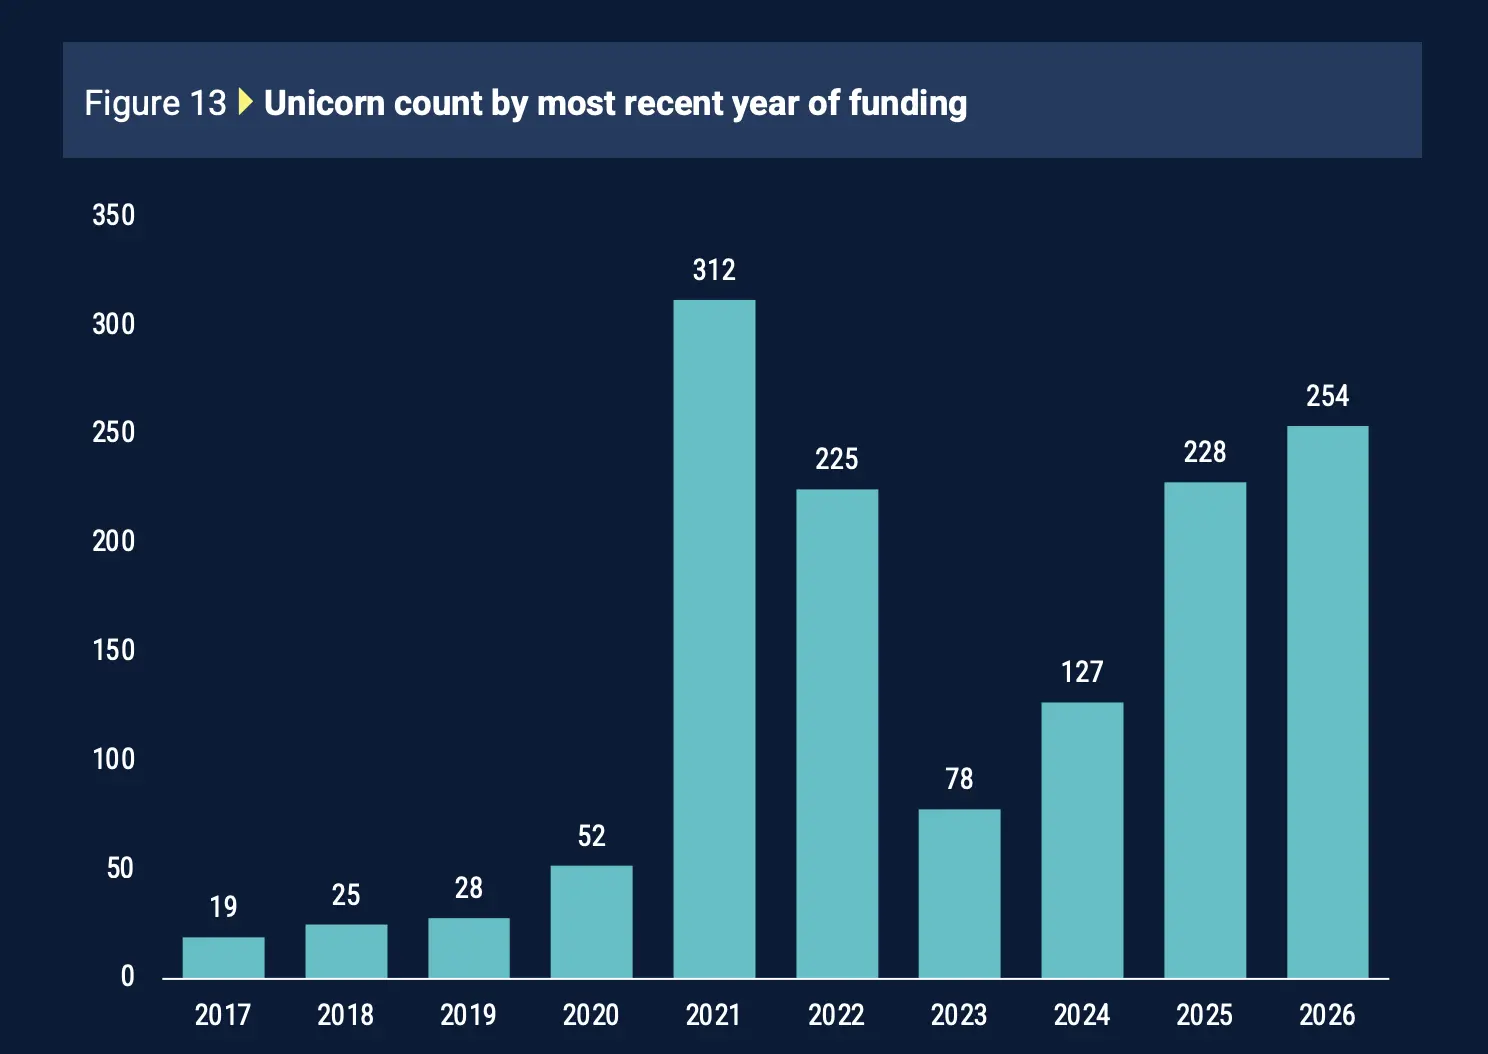
在 964 家活躍的美國獨角獸中,312 家最近一次融資在 2021 年,另外 225 家在 2022 年。這意味著 537 家公司(約占整個獨角獸群體的 56%)仍然背著風投史上最貴融資時期定下的估值。
現金不會再回來匹配那些數字了。風投基金的分配額僅占資產淨值的 7.9%,幾乎是長期平均水平 14.5% 的一半。PitchBook 指出,基金回報被 2020 至 2022 年的虛高估值直接拖累。
當這些公司真的去測試價格時,往往撐不住。公開市場投資者拒絕為私募市場價格買單。Chime 上市時的估值較其私募巔峰大幅縮水,二級市場買家對上一輪融資已過去多年的公司,給出的折扣遠大於近期完成融資的公司。
這背後還藏著第二個趨勢。很多這類公司不是因為做不下去而停滯,而是主動選擇不融資、不上市,因為任何新的定價事件都可能逼他們面對一個更低的數字。保持私有、保持沉默,就能讓 2021 年的估值停留在紙面上。這就是為什麼市場會同時出現創紀錄的紙面價值和創紀錄的被困價值。
所以獨角獸熱潮是真的,還是只是個沒人核實過的數字?
對很多公司來說,兩種說法都可能成立。有些公司確實長進了 2021 年的估值,今天輕鬆就能撐住。但市場沒有辦法確認哪些公司屬於這一類,因為它們從那時起就沒有以真實價格融資或出售過。一個四年前的估值不是謊言,只是未經核實。
這正是創始人和員工需要小心的部分。
如果你公司最後一次融資在 2021 或 2022 年,股權結構表上的估值是你股權擁有過的最樂觀的數字,不一定等於今天的實際價值。這一點影響你如何談下一輪、如何考慮行權、以及如何向團隊解釋他們的期權意味著什麼。對投資人也一樣:一隻基金如果對這些公司顯示強勁的未實現收益,那只是在報告帳面數字,不是真金白銀。
真正的風險不在於估值可能比看上去低,而在於你做融資、招人或行權決策時,把 2021 年定下的數字當成市場今天仍然願意付給你的價格。
把創業公司叫"AI 原生",可能反而在傷害你的估值?
稱自己為 AI 公司仍然能拿到估值溢價。但投資人越來越多地問第二個問題:這家公司有多少部分真正因為 AI 而具有防禦性?
這篇分析中的數據表明,市場開始把貼著同樣"AI 原生"標籤的公司分進截然不同的籃子。
AI 溢價仍然真實存在:Carta 2026 年上半年的數據顯示,AI 創業公司在種子輪融到的錢和非 AI 公司差不多,但估值高出大約 50%。
但不是每家 AI 公司都拿到同樣的溢價:分析把商品化的 AI 外殼公司定在 3 到 8 倍收入,有粘性專有數據的垂直 AI 產品在 10 到 20 倍,而真正擁有知識產權加專有數據的公司在 25 到 40 倍。
公司越成熟,審查越嚴:在種子輪,沒有可保護知識產權的公司會被打 20% 到 30% 的折扣,相對於防禦性更強的同類公司。到 A 輪,這個差距擴大到 30% 到 40%。
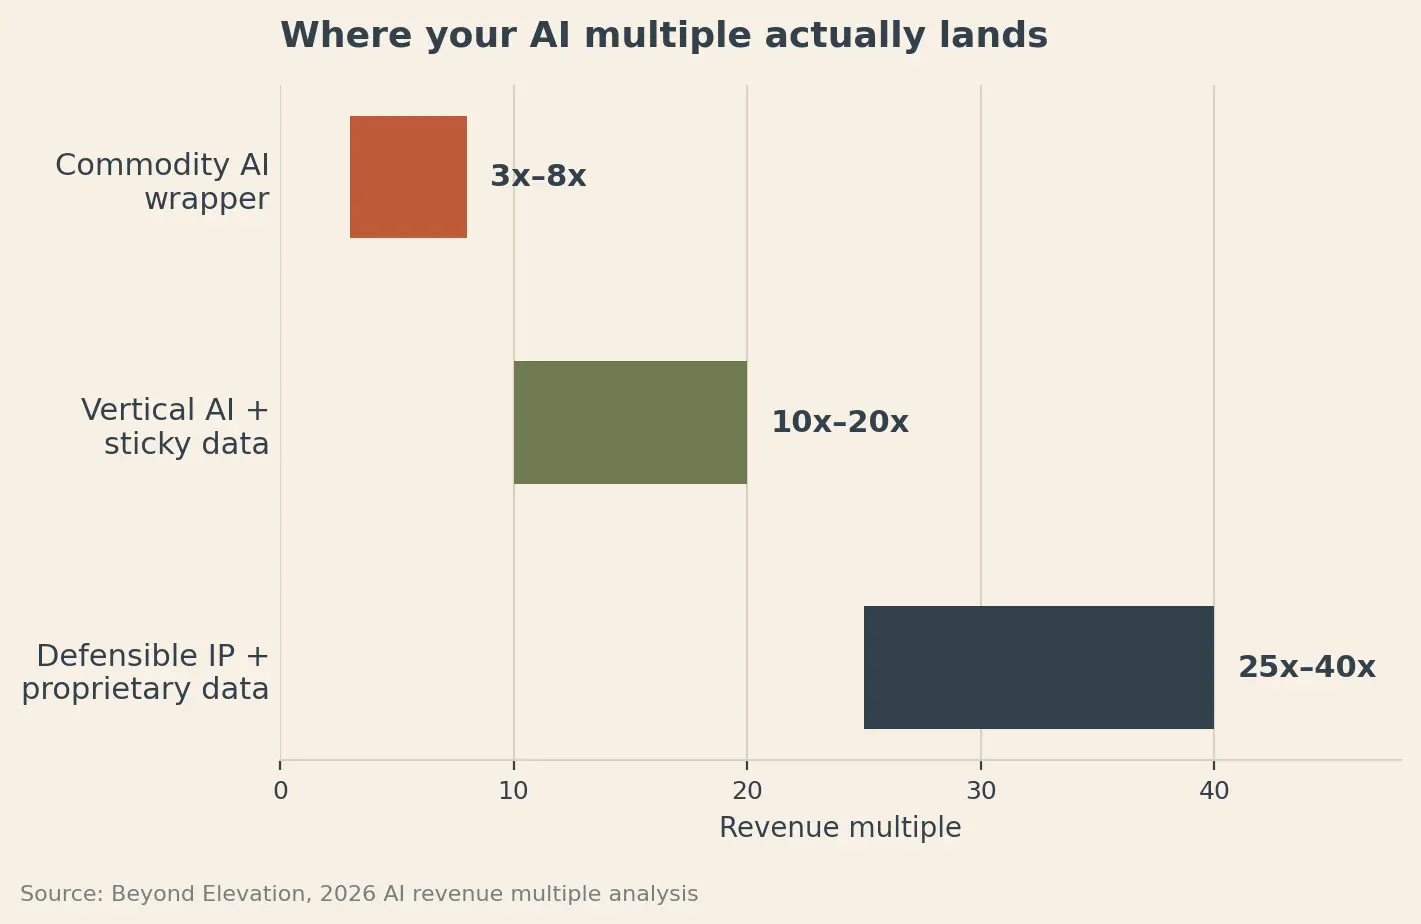
這解釋了為什麼僅僅在產品裡加 AI 正變得越來越沒有意義。
投資人越來越想知道,當你把 AI 標籤拿掉之後還剩下什麼。
另一家創業公司能不能靠調用同樣的基礎模型 API 就把產品做出來?每個新客戶是否產生了能改進產品的專有數據?軟體是否足夠深地嵌入工作流,替換它會讓人痛苦?推理量變成 10 倍之後,單位經濟模型還成立嗎?
這些問題指向創始人在下一輪融資前應該審視的四個方向:技術差異化、專有數據、工作流鎖定,以及規模化下的單位經濟模型。
技術差異化的實際測試簡單得出奇:換掉底層模型。如果把你的主要模型供應商換成另一個水平相當的模型,產品幾乎不變,投資者可能就看不出技術護城河在哪裡。
對於專有數據,光有用戶數還不夠。更強的信號是,用量增加是否會產生數據,讓產品隨著時間的推移可衡量地變好,比如準確率、解決時間或匹配質量有所提升。
工作流深度是另一條線索。如果更深度整合產品的客戶留存和擴張始終更好,創始人就有了切換成本的實際證據,而不是空口說產品粘性強。
然後還有經濟模型。一個 AI 產品在當前用量下利潤率不錯,但推理量擴大 10 倍後可能完全不是一回事。在投資者之前把這些帳算清楚,能揭示業務規模擴大後是否真的變得更強。
這讓"AI 原生"溢價的演變變得很有意思。
十八個月前,只要跟 AI 沾邊,就能實質性地強化融資故事。隨著越來越多初創公司使用同樣的話術,投資者有更多理由去看表層之下。
AI 標籤能讓你進入對話。越來越有價值的部分,是證明你構建的東西為什麼隨著增長而變得更難複製。
軟體的槓鈴化:AI 即將殺死軟體市場的中間層。
AI 正在讓軟體的構建變得大幅更便宜、更快速。這對初創公司聽起來是好事,但也可能削弱幾十年來保護軟體公司的某些護城河。
Conviction 的 Mike Vernal 做了一個有趣的比較:軟體可能正走向互聯網改變報紙行業後形成的同一種"槓鈴"結構。
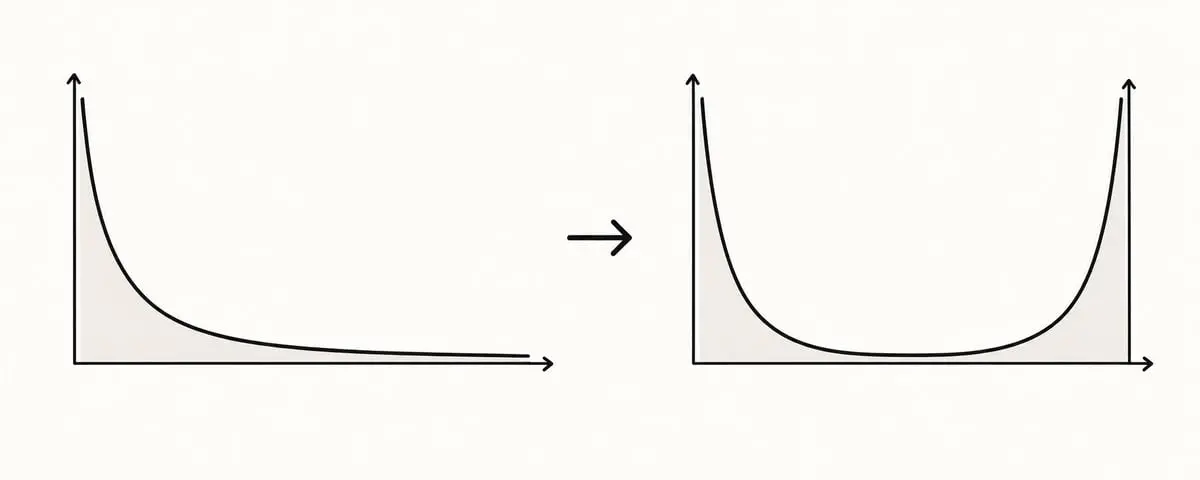
在互聯網之前,區域性報紙受益於昂貴的發行成本。一旦發行幾乎免費,中間層大部分消失了。少數全球性出版物變得大得多,同時成千上萬家獨立通訊和利基出版物湧現出來。
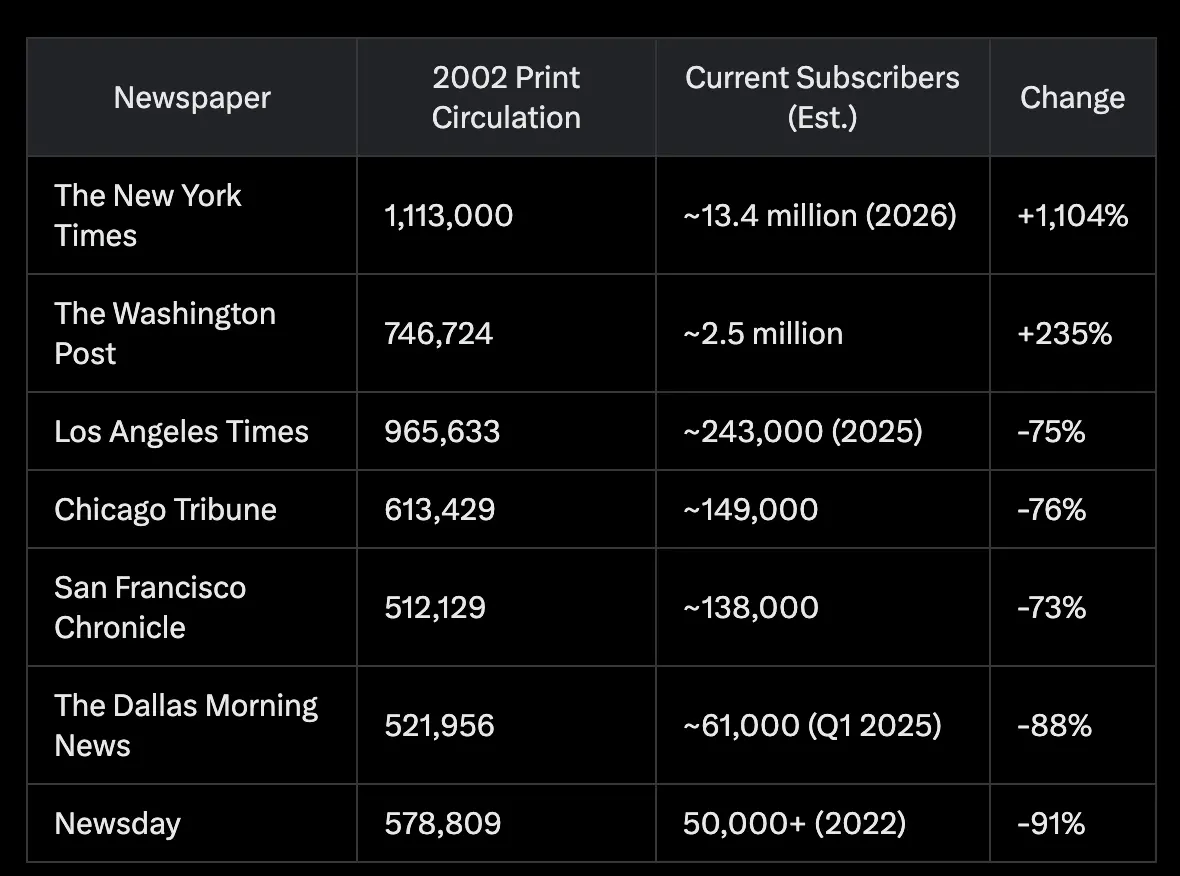
Vernal 認為 AI 可能在軟體領域創造類似的結構。
傳統軟體護城河通常來自三件事:
構建產品很貴
切換系統很痛苦
集成創造了強大的生態系統。
AI 削弱了這三點。競爭對手可以更快複製功能,遷移可以變得更自動化,AI 能讓集成顯著變容易。
可能的結果是一個兩端都極強的市場:
巨型平台:少數公司可能擁有整個採購品類,比如銷售、行銷、財務、人力資源、法務或醫療。它們不是只賣一個狹窄的工具,而是持續擴張,直到成為客戶幾乎所有事情都在用的系統。
微型軟體企業:在另一端,AI 編程工具可能讓數百萬人為自己、自己的公司或小群客戶構建高度特定的軟體。其中一些可能成長為盈利的利基業務。
不舒服的中間層:中型單點解決方案可能面臨最大壓力。如果大型平台能不斷添加它們的功能,小團隊能廉價地重建窄產品,那麼作為獨立工具的防守就變得更難。
亞馬遜的類比解釋了新護城河可能長什麼樣。亞馬遜起步時做的是相對容易複製的事:在線賣書。它的防禦性來自數十年對物流、基礎設施、技術和發行持續不斷的再投資。
AI 可能推動軟體公司走向同樣的策略:更快構建、持續擴張、再投資、讓整體產品越來越難被複製。
對風投支持的軟體初創公司來說,這製造了一個有趣的戰略問題:如果構建軟體幾乎免費,你的護城河仍然是一個好產品,還是你能圍繞它構建出來的一切?
你的種子輪估值實際上是怎麼定的?(幾乎跟你的公司無關)。
創始人常常假設估值主要跟 traction、市場規模或者他們路演講得好不好有關。
但還有另一個大多數創始人幾乎看不到的約束:坐在對面的 VC 基金的經濟模型。
想像你在向一隻 2800 萬美元的種子基金路演。它通常開一張 60 萬美元左右的支票,想要大約 6% 到 8% 的股份。
在 7% 股份下,60 萬美元的投資意味著約 860 萬美元的投後估值。在 6% 下,意味著 1000 萬美元。所以如果你以 1800 萬美元的估值融資,那隻基金可能根本沒法在它的投資組合模型裡做這筆投資。
這就形成了一條簡單的鏈條:
基金規模 → 支票大小 → 目標持股 → 可行估值上限
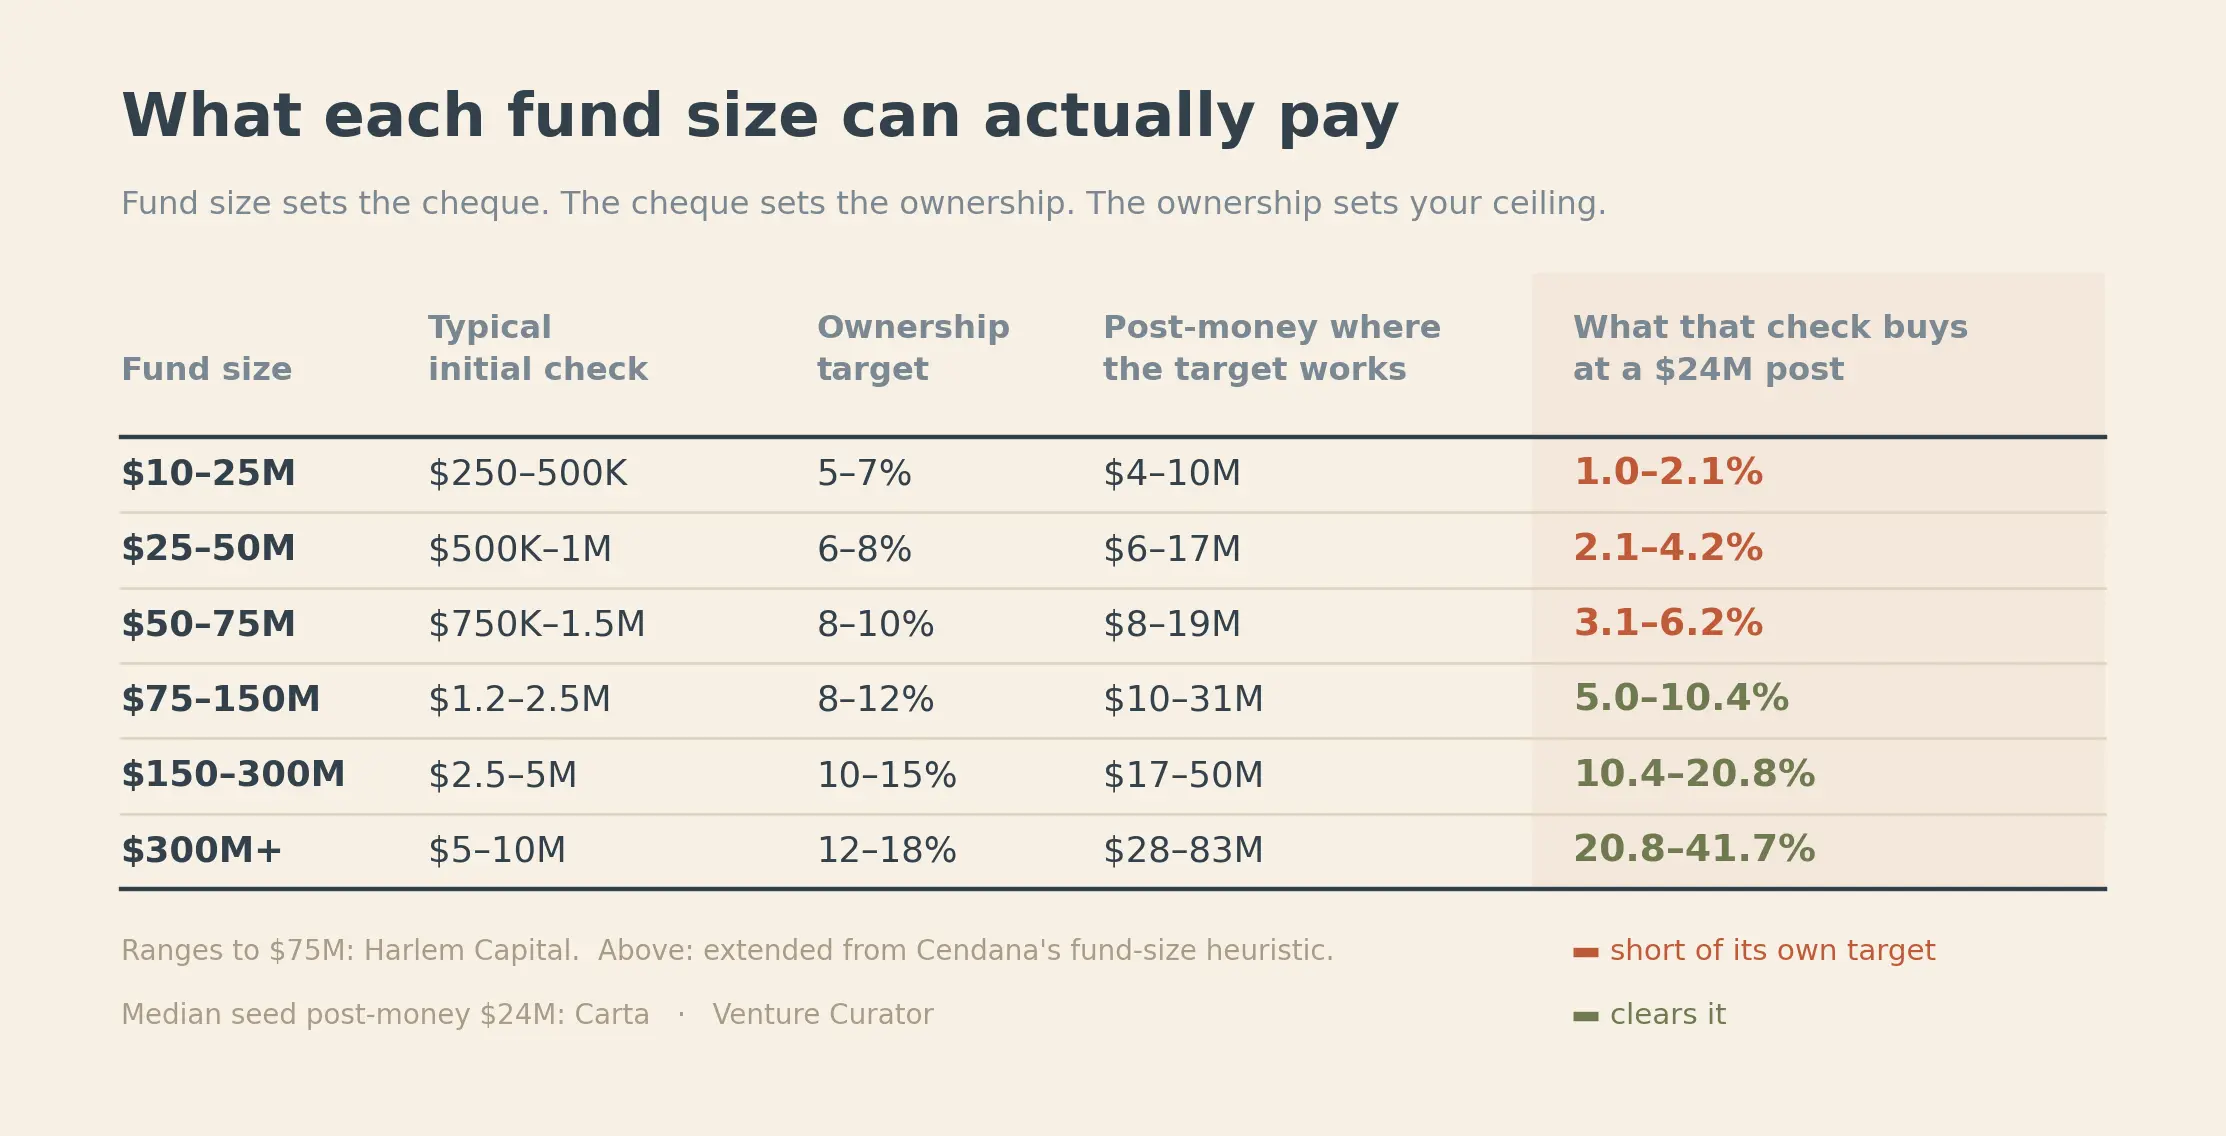
這在今天更重要,因為種子輪估值已經上漲。分析中引用的 Carta 種子輪投後估值中位數是 2400 萬美元。一隻 5000 萬美元的基金以這個估值投 150 萬美元,只能拿到 6.2% 的股份,可能低於它的目標。
如果你告訴一隻基金你要融 300 萬美元,領投方想要 15%,你實際上已經在任何人明確討論估值之前,隱含了一個 2000 萬美元的投後估值。
更有用的順序是:
計算你需要多少資金,以 18 到 24 個月的跑道達到下一個里程碑。
加上緩衝。
那就是你的輪次規模。
用它除以你願意接受的稀釋比例。
然後去找支票大小和持股模型能支持這個估值的基金。
還有另一個創始人常常忽略的數字:期權池。領投方可能會要求在投資前設立 10% 到 15% 的期權池,這會在投資落地前稀釋現有股東。分析認為,基於實際招聘計劃來談判期權池,有時對創始人持股的影響,比在頭條估值上多爭 100 萬或 200 萬美元更大。
避免在錯誤的基金身上浪費數周時間,最簡單的辦法就是在第一次通話時問這個問題:
"這家基金的典型首筆支票是多少,你們通常希望拿到多少股權?"
這兩個數字能讓你快速估算出,這家基金的經濟模型是否支持你的融資輪。
所以,不要把所有估值上的阻力都當成對你創業公司的否定。有時你的公司沒有問題。只是你的融資輪不符合基金的數學邏輯。
如果 ChatGPT 能免費做到你的應用所做的事,別人為什麼還要付費?
這正在成為消費類應用創始人面臨的最大問題之一。
如果用戶打開 ChatGPT、Claude 或 Gemini,幾秒鐘內就能得到大致相同的結果,他們為什麼還要每月花 10 或 20 美元,去用一個獨立應用?
RevenueCat 的 Daphne Tideman 認為,答案不是簡單地"加更多 AI"。AI 驅動的應用已經變現良好,每個付費用戶帶來的收入比非 AI 應用高 41%,試用轉化率高 52%。但它們的 12 個月留存率只有 21.1%,而非 AI 應用為 30.7%。
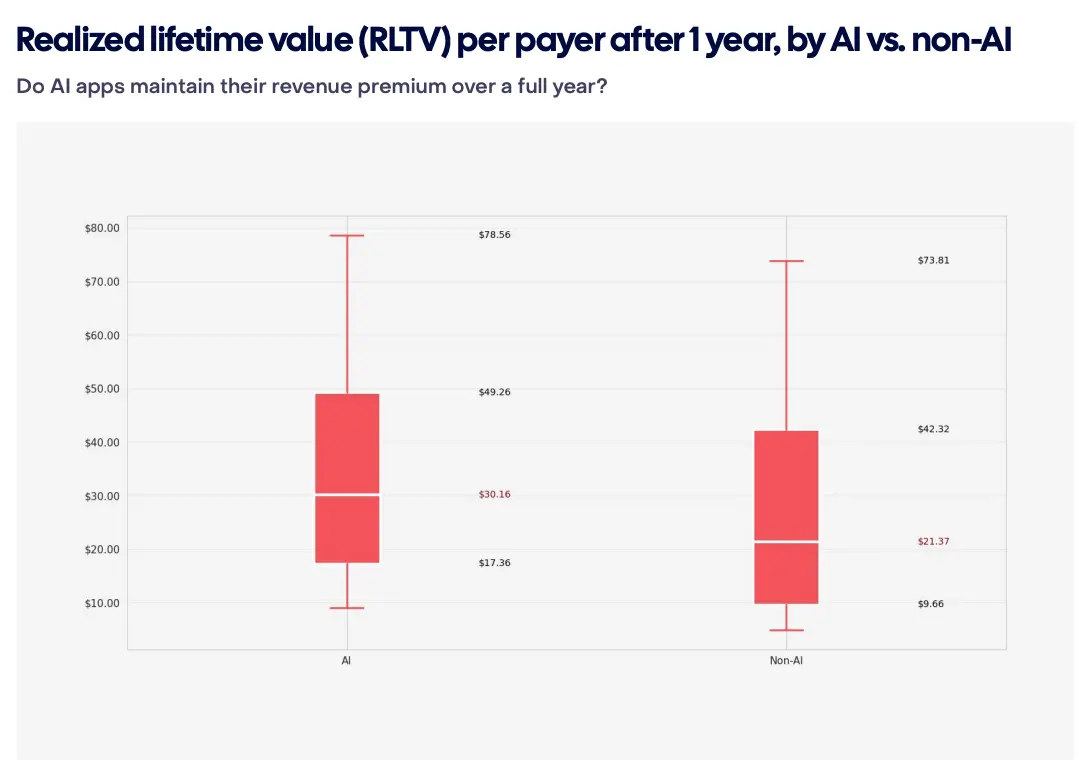
換句話說:AI 能把人帶進門。但它未必能給人留下來的理由。
看看 Chegg 與 Duolingo 的對比。
區別在於答案之外還有什麼。
RevenueCat 建議應用可以構建六種更難被空白 LLM 聊天複製的東西:
結構:把一個答案變成完整的工作流或體驗。
記憶:隨著時間推移了解用戶,應用變得更有用。
習慣:用連續打卡、提醒、監督和遊戲化把用戶帶回來。
精準:掌握專業數據或專長,產出更好的結果。
連接:構建社區、身份、個性或情感依附。
實體與數字結合:把軟體與傳感器、設備或真實世界數據結合起來。
Duolingo 是一個很好的例子,它把其中幾項疊加在一起。ChatGPT 可以教語言,但 Duolingo 花了多年時間構建連續打卡、排行榜、進度系統、提醒和遊戲化。據報導,Duolingo 引入排行榜後,學習時間增加了 17%,高參與度學習者數量增長了三倍。
還有一個創始人可以做的簡單測試:空白對話框測試。
打開 ChatGPT 或其他 LLM,準確描述你的用戶來你應用裡解決的問題,然後把它的回答與你的產品交付的東西進行比較。如果你的產品大部分價值能用一次提示和一次回答複現,你就有差異化問題。如果你的應用加入了結構、累積數據、習慣、精準、連接或真實世界組件,那可能就是你的護城河所在。
所以,AI 本身可能不是護城河。對創始人來說更關鍵的問題是:你的產品給了用戶什麼,是空白對話框給不了的?RevenueCat 的觀點是,贏家會在產品底層使用 AI,而在圍繞它構建的體驗上展開競爭。
 風險提示