DeepSeek開源推理框架,社媒測算推理毛利率或超過95%
 核心觀點

 DeepSeek開源底層推理堆疊DeepInfer並公布每GPU小時收入達到38美元,海外社媒透過數據推算出其單卡硬體毛利率高達84%至96%。該測算進一步引發行業共振,分析人士推演指出OpenAI與Anthropic主流模型的API毛利率或同樣達95%。
DeepSeek開源推理框架,將大模型行業的討論從模型能力進一步引向推理成本。
10月20日,DeepSeek宣布開源內部推理框架DeepInfer,以及用於Token編解碼的deepseek-recipe。DeepSeek表示,DeepInfer服務於DeepSeek V4.1-Flash的大規模推理,目標是在降低延遲的同時提高吞吐量。框架支持英偉達GPU和華為昇騰NPU,採用Apache-2.0開源許可證。
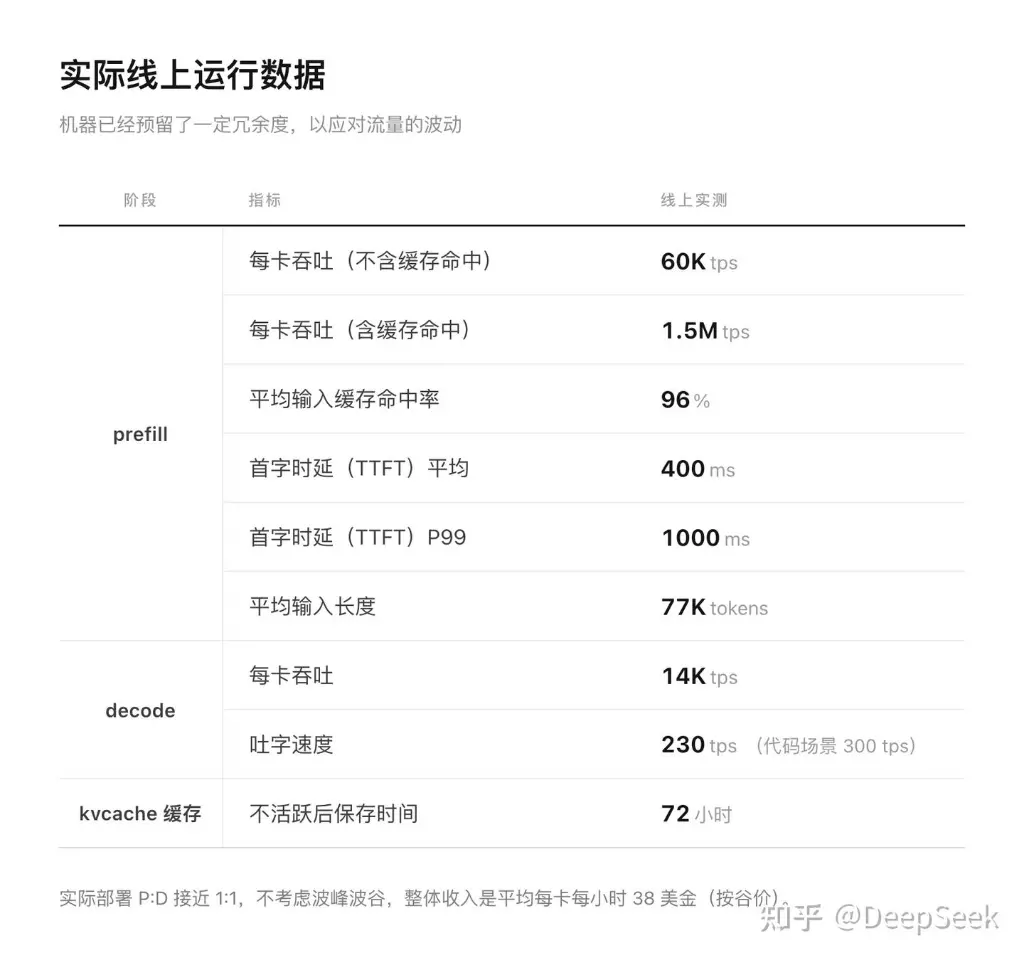
此次開源引發關注的一個背景,是DeepSeek披露的推理服務收入。根據DeepSeek在GitHub發布的部署問答,V4.1-Flash單集群每天處理155萬億Token,按谷電時段價格計算,整體收入達到每GPU小時38美元。
社媒據緩存率、吞吐和定價等假設,估算其推理毛利率最高可能高達84.2%---96.1%。分析人士推演指出OpenAI與Anthropic主流模型的API毛利率同樣或達95%。
這項披露給外界提供了觀察推理經濟帳的一個切口。不過,收入數字本身並不能說明利潤水平。要判斷每小時38美元收入對應多少毛利,還需要知道硬體折舊、能源、網絡、緩存存儲和運維等成本。
社媒測算毛利率最高超過96%
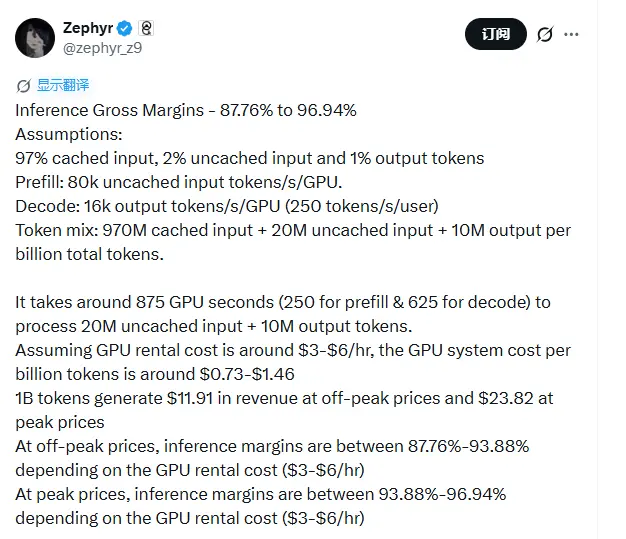
海外科技投資研究員Zephyr在社交平台X上發表測算指出,DeepSeek實際上"公開了其商業模式背後的核心秘方"。他估算,DeepSeek推理毛利率可能達到84.2%---96.1%,修正了早期給出的87.76%---96.94%區間。
他設定了一個典型的基礎模型:假設在實際生產中,97% 的輸入命中鍵值緩存,未命中緩存的輸入占 2%,輸出占 1%。
緩存輸入(Cached Input): 占總 Token 量的 97%(單價極低,計算負載極輕);
未緩存輸入(Uncached Input/Prefill): 占總 Token 量的 2%;
生成輸出(Output/Decode): 占總 Token 量的 1%。
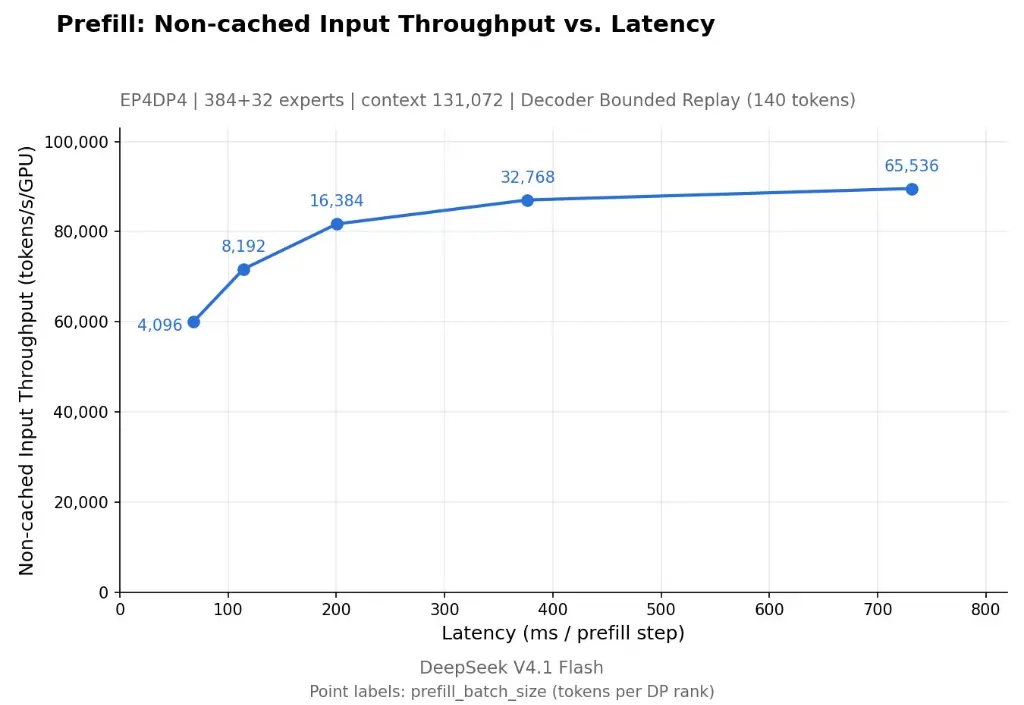
在此流量結構下,Zephyr 結合官方公布的單卡極限吞吐量(預填充每秒 8 萬 Token、解碼每秒 1.6 萬 Token)測算產值。根據其模型,一張 GPU 滿載運行時,理論上每小時可處理對應的 Token 組合並產生最高約 49 美元的帳面收入。
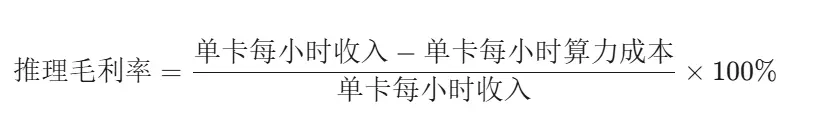
若按照當前海外公有雲市場中,一張頂規 GPU(如英偉達 H100 或類似下一代硬體)普遍為每小時 1.5 至 4 美元的綜合租賃成本計算,其硬體層面的推理毛利率公式為:
在極限測試工況下(每小時產出 49 美元,算力成本取 1.5 至 6 美元區間):
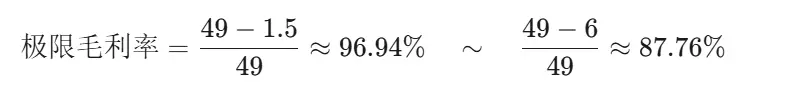
Zephyr表示在特定理想負載下,該框架對應的推理業務毛利率(Inference Gross Margin)處於 87.76% 至 96.94% 之間。他在推文中直言:"英偉達、SGLang 和 vLLM 的公開表現直接被碾壓了。"
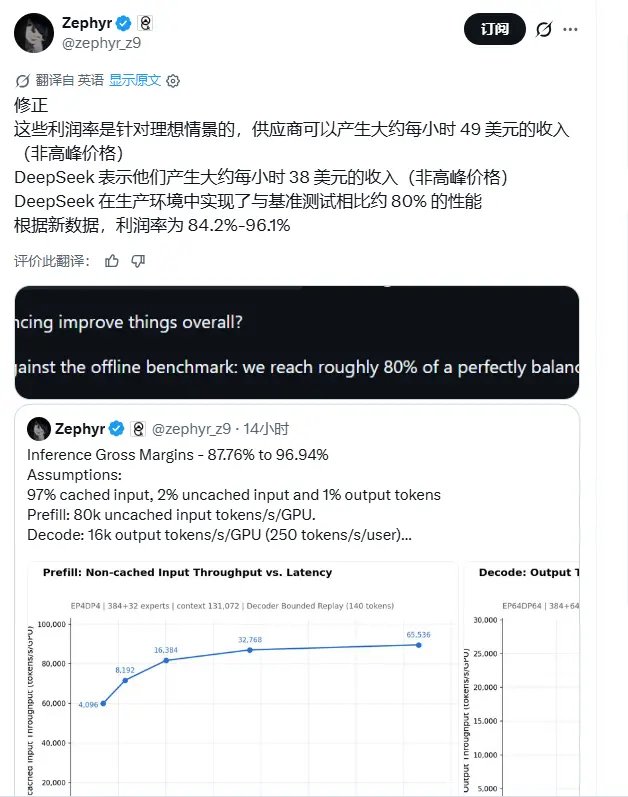
隨後,Zephyr 根據 DeepSeek 官方披露的真實運營細節修正了測算參數。他補充寫道:"這些極端毛利基於理想場景,彼時服務商每小時可產出約 49 美元。DeepSeek 官方公布其非高峰期每卡每小時實際創收約為 38 美元,且生產環境能達到基準測試約 80% 的性能。基於這些最新數字重新評估,實際運行毛利率落在 84.2% 到 96.1% 之間。"
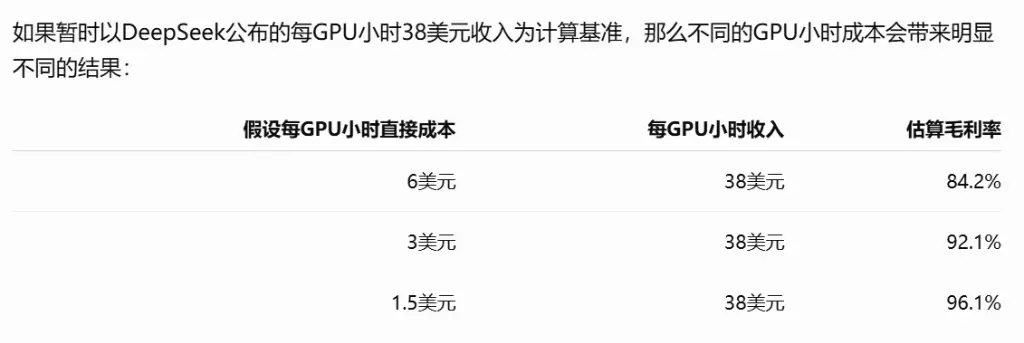
目前海外雲服務市場中,租賃單張頂級 GPU 的綜合成本普遍在每小時 2 至 4 美元區間。38 美元的單卡時產值與單位算力成本之間形成的巨大剪刀差,正是推高毛利率測算的核心依據。
行業橫向推演:頭部實驗室毛利
該測算發布後,迅速在行業內引發了關於頭部 AI 實驗室真實盈利能力的連鎖討論。
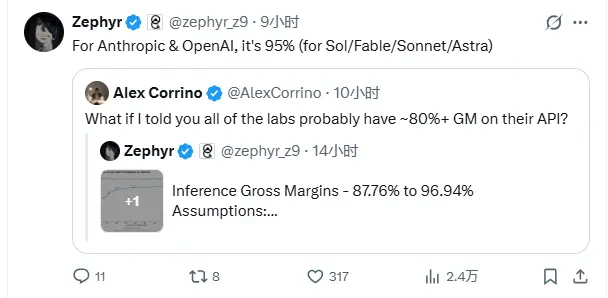
科技投資觀察人士 Alex Corrino 在轉發上述測算時發問:"如果我告訴你們,所有頂級 AI 實驗室的 API 毛利率其實很可能都在 80% 以上呢?"
Zephyr 隨即引用該推文並給出了更為激進的判斷:"對 Anthropic 和 OpenAI 而言,這個數字實際上是 95%(適用於 Sol、Fable、Sonnet、Astra 等主流主力模型)。"
Anthropic肯定在賺大錢?
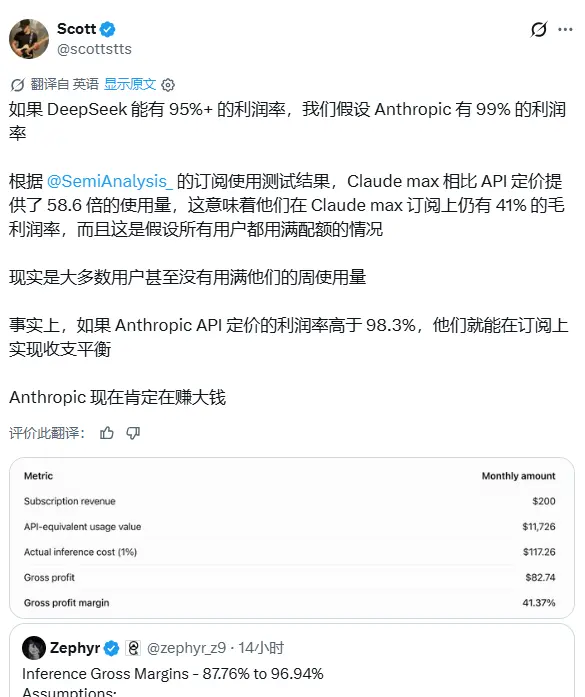
在全行業普遍具備高毛利的前提假設下,投資分析人士 Scott 進一步將該邏輯平移至終端用戶的"訂閱制(Subscription)"經濟模型,推演海外頭部的真實底牌。
根據研究機構 SemiAnalysis 的實測報告,Anthropic 為其高級會員"Claude Max"提供的實際可用 Token 額度上限,達到了其對應官方 API 單價貨值的 58.6 倍。外界據此一度認為,高用量訂閱用戶會嚴重吞噬平台利潤導致倒貼。
Scott 給出了反向推導公式:
設定基準前提:假設 Anthropic 的 API 硬體毛利率同樣高達 99%(成本率僅為 1%)。
訂閱制用量極端打滿時的成本反推:用戶支付 1 單位訂閱費,若徹底消耗完等價於 58.6 單位 API 標價的算力額度,對應 Anthropic 承擔的實際底層硬體成本為:
實際硬體成本=58.6×1%=0.586 單位實際硬體成本=58.6×1%=0.586 單位
推導極端狀態下的訂閱毛利率:
Claude Max 極端毛利率=1−0.5861=41.4%Claude Max 極端毛利率=11−0.586=41.4%
Scott 由此分析稱:
"如果 DeepSeek 的毛利率能達到 95% 以上,假設 Anthropic 的 API 毛利率為 99%。基於 SemiAnalysis 的測試,Claude Max 提供了高達 API 標價 58.6 倍的使用額度。這意味著,即便所有用戶都把配額徹底打滿,Anthropic 在訂閱模式下仍能保留約 41% 的毛利率。而現實中絕大多數用戶根本不會用滿每週上限。"
他指出:"實際上,只要 Anthropic 的 API 利潤率維持在 98.3% 以上,即使用戶全量打滿限額,其訂閱業務也能實現收支平衡。Anthropic 當前絕對處於穩健的盈利狀態中。"
科技分析帳號 Teortaxes 同樣評價稱:"在主力實驗室的內部自研架構面前,市面上所有的公開基準測試都不值一提。這就是嚴肅做工程能換來的成果,推理業務本身就是一台印鈔機。你可以想像 Dario(Anthropic 首席執行官)此刻該有多焦慮。"
技術路徑分歧:軟體重構 vs 專用晶片
隨著真實的推理成本結構浮現,業內也重新審視了不同的技術降本路線。
在硬體架構與單位吞吐成本上,業內將該方案與主打超低延遲的晶片廠商 Groq 進行了對照。
行業觀察人士指出,以 Groq 為代表的 LPU 定制硬體架構依賴板載 SRAM,換取了極致的交互生成速度,但其晶片顯存容量極小,承載主流大模型需要成倍堆疊硬體板卡與龐大的節點互聯,導致單 Token 的整體硬體折舊與採購門檻居高不下。
相比之下,DeepInfer 則展示了通用晶片路徑的另一種帳本邏輯:在通用 GPU 及昇騰等商用 NPU 上,單純通過軟體調度極致榨取並發吞吐量,以更低的綜合硬體成本換取規模化 API 服務的利潤空間。
不過,多位產業觀察人士在討論中指出,上述 80% 至 95% 的毛利測算主要聚焦於"Token 售價與單卡硬體消耗"之間的直接帳面差額。這種微觀測算並沒有計入前期基礎模型數以億美元計的研發訓練支出(R&D)、全球節點的高速帶寬網絡成本,以及高昂的系統工程團隊薪資。
接下來需要驗證的,是開源實現能否在不同硬體和實際業務負載下穩定提高吞吐、降低每個有效輸出Token的成本。對於DeepSeek自身,外界同樣需要更多成本與資源利用率數據,才能判斷社媒估算的高毛利是否接近真實經營水平。
 風險提示