谷歌 Gemini 4 Neon 發布:速度 3 倍、成本 60%,世界模型 Genie 4 同步開放
 核心觀點

 谷歌發布 Gemini 4 家族的「中杯」Neon:速度是 Carbon 的 3 倍、成本 60%,每百萬輸入 3 美元/輸出 15 美元,100 萬 token 上下文;Artificial Analysis 61 分列第 3,法律、稅務、代碼與安全基準多項第一。世界模型 Genie 4 同日起面向 Ultra 用戶開放。
編輯|冷貓
一覺醒來,谷歌又雙叒叕發 Gemini 4 模型了。
谷歌最近一直在基礎模型上發力,從最高智能到最高效率的模型不停發布,為了重返王座真是拼了。
在 Carbon、Argon、Hydrogen 之後,填補最高智能和最高效率之間的「中杯」模型 Gemini 4 Neon 登場!

Demis Hassabis 稱,Gemini 4 Neon 這一中杯模型,是「Alchemy at its finest(煉金術的傑作)」。
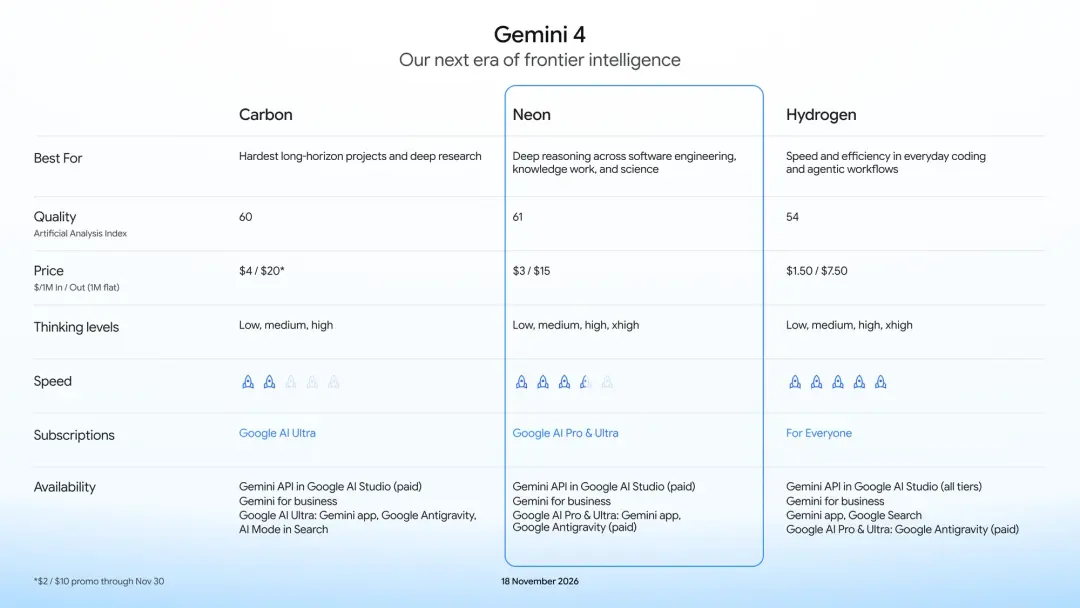
Gemini 4 家族中,Carbon 是旗艦,負責最難的長程項目;Hydrogen 面向日常高頻場景,追求的是響應速度。Neon 的定位在二者中間,「在複雜編程、分析推理和生產級企業工作流上提供前沿推理能力,同時更快、更省」。
Neon 速度是 Carbon 的 3 倍,成本只有 Carbon 的 60%。定價每百萬輸入 token 3 美元,每百萬輸出 token 15 美元,快取輸入 token 低至 0.15 美元,上下文窗口 100 萬 token,另外支持 4 檔可調的思考深度,開發者可以按任務複雜度靈活切換速度和推理深度。
Gemini 4 Neon 運行 12 小時 /swarm,從檔案照片中重建艾倫・圖靈 1936 年的研究 ------ 包括一個運行的通用圖靈機,現代計算的藍圖。
博客鏈接:
全面跑分
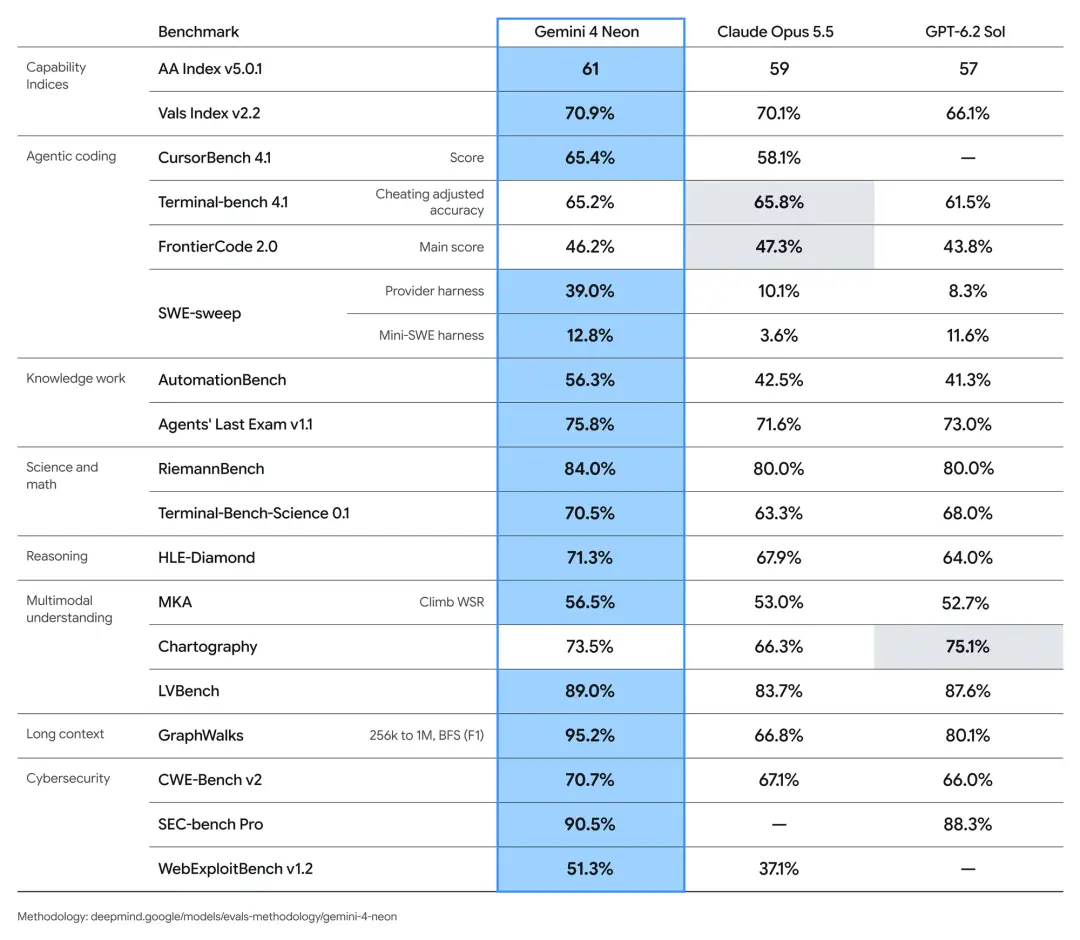
Neon 在第三方評測上的表現相當全面。綜合智能方面,它在 Artificial Analysis Intelligence Index 上以 61 分排到第 3,僅落後於更大、更慢的模型;在 Vals Index 上排第 2(70.9%),落在帕累托前沿上。
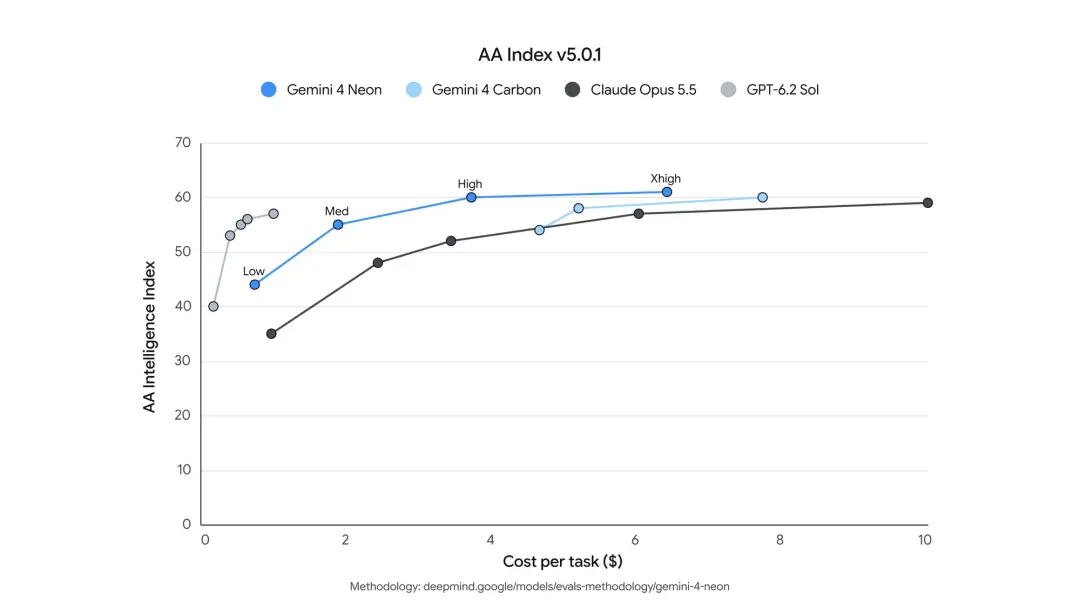
在全新的 Agent Arena Index 中,Neon 憑藉 4200 余個真實世界智能體會話拿下第 2(1336 分),可操控性(steerability)同樣排第 2,意味著用戶中途改口時,模型能更乾淨地調整方向。
企業和知識工作類的評測更是大面積刷榜。Legal Research Bench 和 Tax Agent Bench 兩項第 1,Surge AI 覆蓋的金融、會計、電子表格建模等多個類目也大多排在第 1。Zapier AutomationBench 第 1(56.3%),Andon Labs 的 Vending-Bench 2 同樣第 1($16,843),後者是一個模擬長周期商業經營的測試,對長程規劃能力要求很高。密集圖表閱讀基準 Chartography 得分 73.5%,Agents' Last Exam v1.1 得分 75.8%,與頭部模型持平。
科學和數學推理方向上,Neon 拿下了 Terminal-Bench Science(70.5%)、RiemannBench(84.0%)和 HLE-Diamond(71.3%)三項第一,均為同類最佳。
逐項拆解 Neon 能力
根據官方博客,Neon 的新能力可以歸納為幾個大方向。
寫代碼,更準更穩。 Neon 面向真實生產環境,能處理多文件調試、重構和精準編輯。谷歌特別提到了它的「surgical edits(手術式編輯)」能力,能對多文件項目做定點修改。模型在多步驟指令遵循上有明顯提升,同時在內部 Google Antigravity 測試中錄得了迄今為止最低的編造率(fabrication rate)。
100 萬 token 窗口拿下多模態。 電子表格、PDF、圖表、音頻、視頻,Neon 可以在一個上下文窗口裡同時消化這些輸入,輸出結構化的交付物。「Neon 在整體質量上追平甚至超過了 Carbon,速度快 3 倍,成本降低 40%。它在準確性、細節和速度之間找到了令人信服的平衡。」
網絡安全方向。 這是 Neon 本次發布中一個獨特的動作。谷歌推出了 Neon for Cyber,覆蓋安全代碼編寫、漏洞發現、漏洞驗證和漏洞修補的完整鏈條。
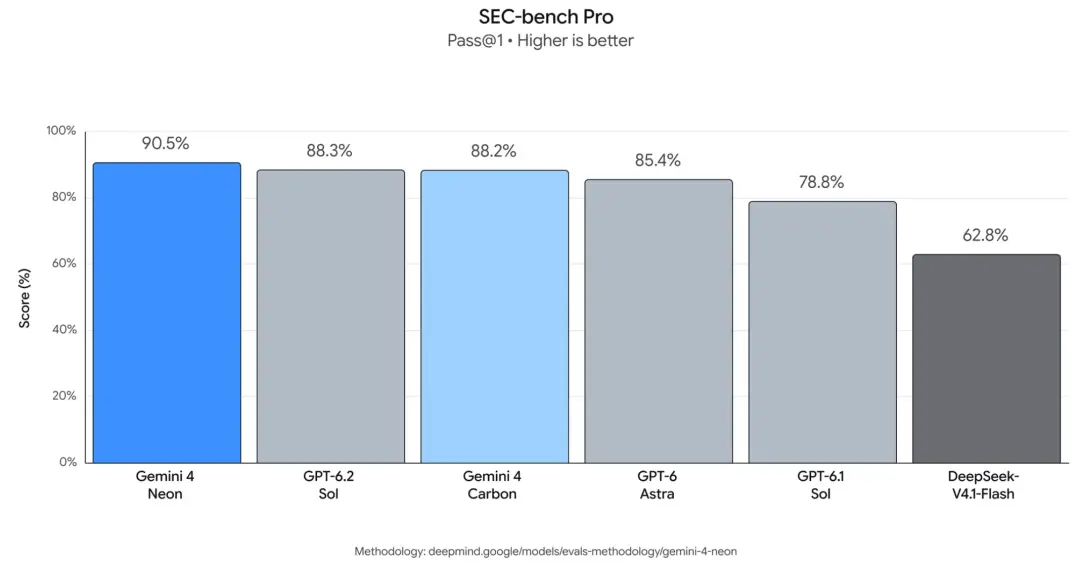
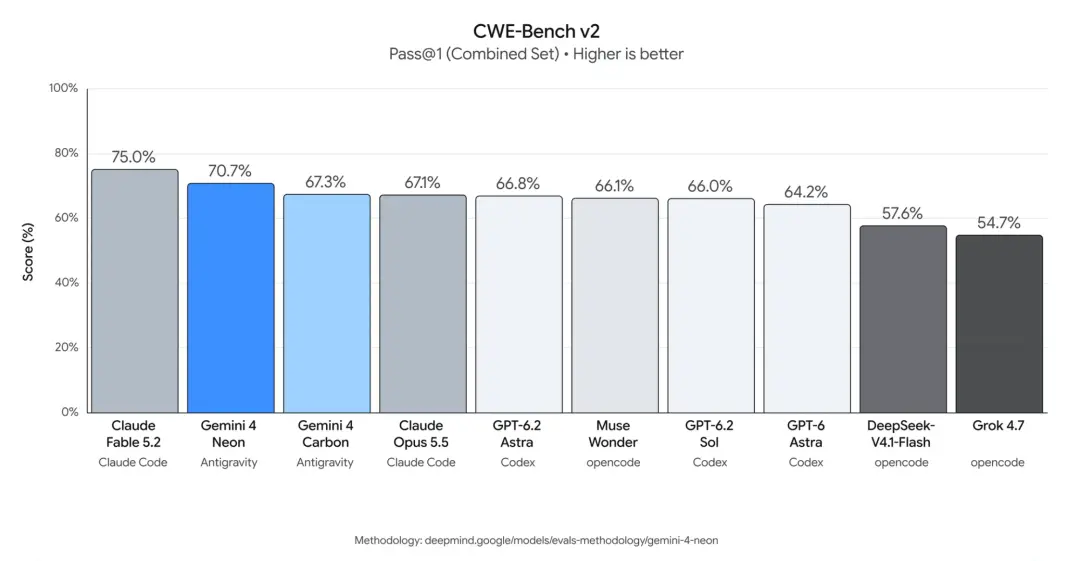
從數據看,AutoBaxBench 安全代碼生成在困難級別達到 SOTA(76%),全面超越 Carbon;WebExploitBench v1.2 滲透測試同樣 SOTA(51.26%),成本僅為競品大模型的一半;SEC-bench Pro 漏洞發現 SOTA(90.5%),單挑戰成本約為同類的一半;CWE-bench v2 漏洞修補 70.7%,比 Carbon 提升 3.4%。Neon for Cyber 將在未來幾天內通過 Fairwind Program 向受信任的安全防禦人員開放。
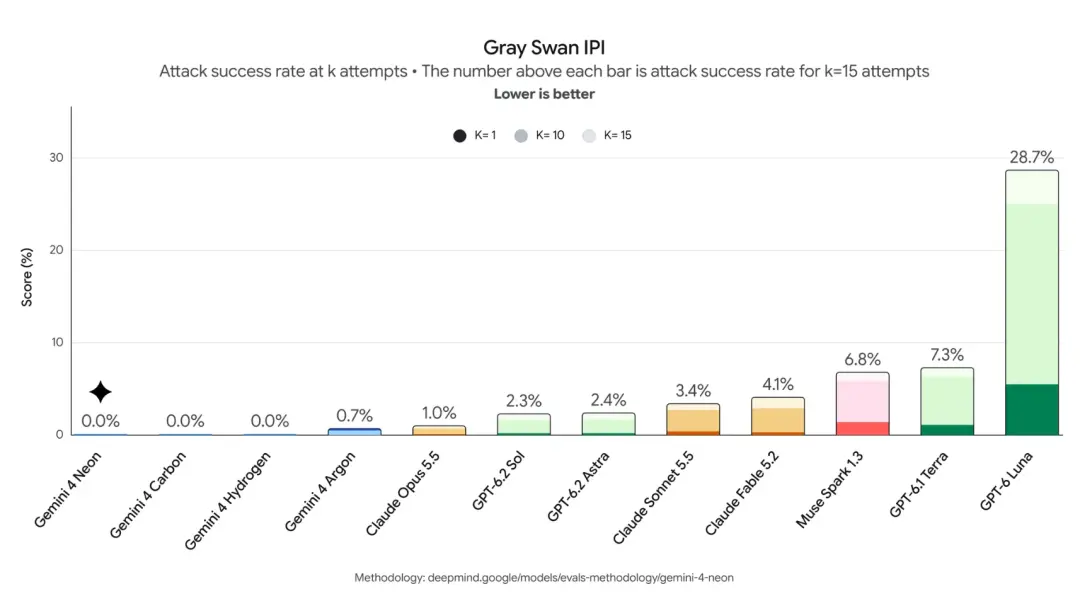
安全對齊,幾乎「零作弊」。 谷歌在安全性上下了重注。Terminal-Bench 4.0 作弊率 0.0%,與 Carbon 持平;編碼作弊評估中僅 2.45% 的任務出現走捷徑行為,是 Gemini 4 全系列最低;智能體安全套件中不當行為率 0.09%,誠實評估通過率 99.2%。在 Gray Swan 的間接提示注入基準中,Neon 在最高思考級別上達到了 0.0% 的攻擊成功率。對比 Carbon,Neon 將「服務不足」降低了 43%-56%,「越權操作」降低了 15%-35%。同時它在合法任務上幾乎不拒絕,Terminal-Bench 4.0 上僅拒 1.98%,Terminal-Bench-Science 上拒絕率為 0%。
消費者端也有升級。 在 Gemini 應用中,Neon 帶來了更高質量的寫作輸出,能更精準地讀取電子表格、PDF 和照片等上傳內容,還可以接入 Gmail 和 Docs 獲取相關信息。Tasks 功能現在由 Neon 驅動,處理複雜多步驟任務時更快更省額度。
Gemini 4 Neon 已經開始滾動上線。開發者可以通過 Gemini API 付費層級在 Google AI Studio 和 Android Studio 中構建應用,Google AI Pro 和 Ultra 訂閱用戶能在 Google Antigravity 中試用。企業用戶走 Gemini for Business 的 API 或模型下拉菜單。消費者端,Pro 和 Ultra 訂閱用戶可以在 Gemini 應用的模型選擇器裡直接切換到 Neon。網絡安全方向的 Neon for Cyber 會在未來幾天內通過 Fairwind Program 推送給受信任的防禦人員。
世界模型 Genie 4 終於上線
10 月 28 日,谷歌 DeepMind 官宣最新一代世界模型 Genie 4,稱其為「迄今為止最逼真、交互性最強的世界模型」。
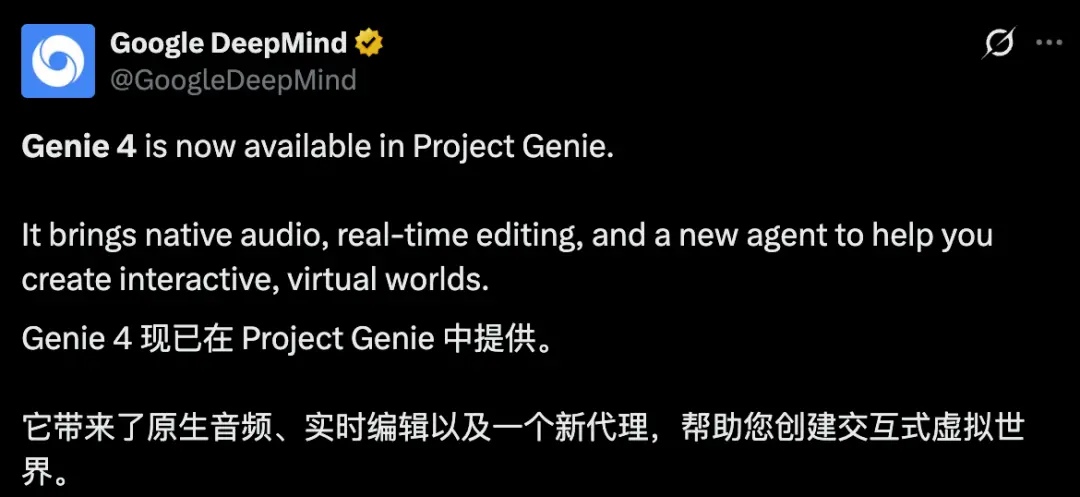
經過超過半月的等待,谷歌終於宣布 Genie 4 正式上線可用。
博客鏈接:
Genie 4 是谷歌目前最逼真、最具交互性的世界模型。它最核心的新能力是「mid-session prompting」,也就是在你瀏覽世界的過程中,隨時用自然語言改變環境。你可以切換天氣、投放一個角色、改變劇情走向,所有變化實時發生在當前畫面中。
另一個首次出現的能力是原生音頻(native audio)。Genie 4 生成的世界自帶聲音,而且聲音會隨場景變化自動適配,從環境音效到角色對話都包含在內,補上了「聽覺」這塊拼圖。
Genie 4 主打最高保真度,Genie 3 則在 Project Genie 的模型選擇器中繼續保留,面向更長時間的探索和全景場景。
本次谷歌在上線 Genie 4 的同時,也上線了 Project Genie Agent。以前創建一個世界需要你精心組織 prompt,現在變成了一場對話。你用自然語言描述你想要的世界,智能體會調度谷歌的多模態模型組合,生成初始視覺畫面來建立世界的視覺風格,同時配上量身定制的背景音樂。
更有意思的是,Gemini 模型可以在你探索世界時同步觀察螢幕內容,主動彈出「下一步去哪」的建議,或者根據你的旅程自動觸發世界內事件。
你還可以對畫廊中已有的世界進行 remix,調整底層結構、配樂或規則,把它變成你自己的版本,然後發布到社區畫廊供其他人探索和二次創作。
目前 Project Genie 的新體驗面向符合條件的 Google AI Ultra 訂閱用戶開放,Google AI Pro 會員可以在同一頁面加入候補名單。
 風險提示 風險提示