テンセント・フンユアンがHy4を発表:オープンソースの最強に名を連ね、実測で四つの実用的なシーンを示す
 核心的な視点

 テンセント混元は770Bオープンソース大モデルHy4を発表しました:初めて視覚理解とComputer Useをサポートし、金融、オフィス、開発、研究などのシーンでの評価が先行し、実際に四つの実用的なタスクをテストしました。
文|晓静
編集|徐青陽
11月4日、テンセント混元は新世代の大規模言語モデルHy4を正式に発表しました。以前のHy4プレビューと比較して、新しいモデルは事前トレーニングと後トレーニングの規模をさらに拡大し、視覚理解能力を初めて導入し、指示遵守、長文理解、長距離エージェントおよび実際の生産性タスクのパフォーマンスを強化しました。
Hy4の総パラメータ規模は770Bで、混合専門家アーキテクチャを採用し、初めてコンピュータ操作(Computer Use)をサポートし、コマンドラインとグラフィカルインターフェースを組み合わせて複雑なタスクを実行できるようになりました。
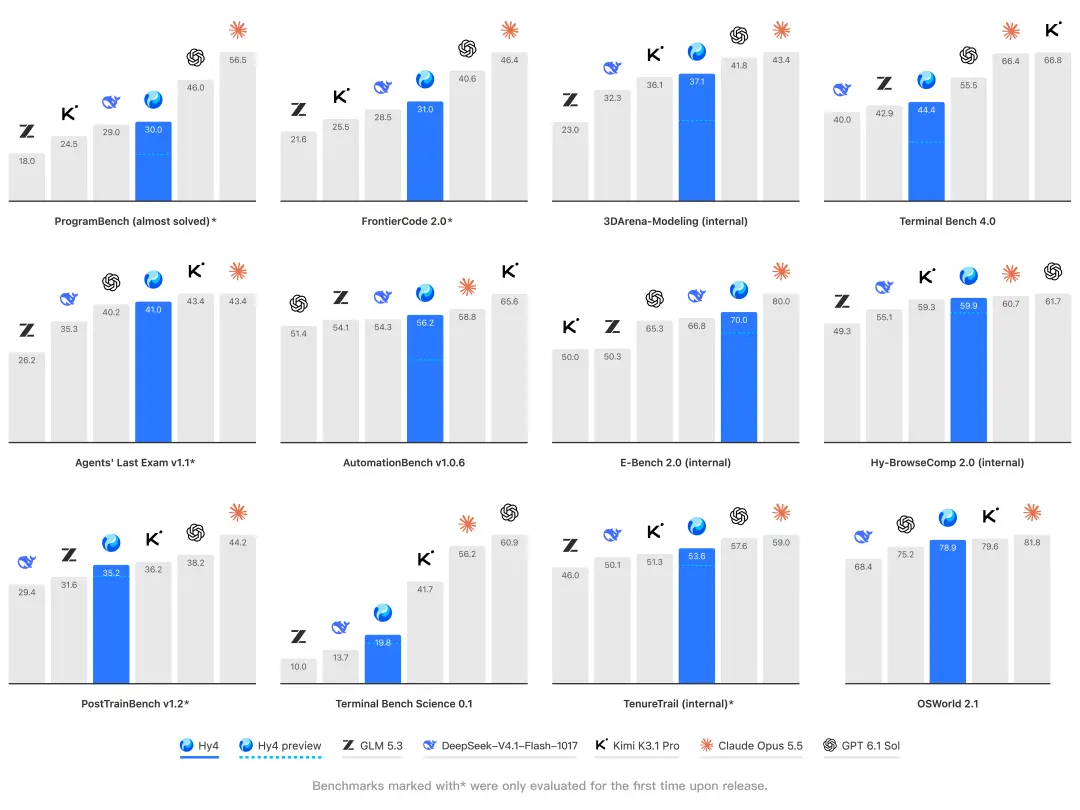
評価結果から見ると、Hy4は世界の第一梯隊のオープンソースモデルに名を連ねており、モデルの重みも近くオープンソース化される予定です。混元チームは、Hy4が現在最強のオープンソースモデルの一つであるにもかかわらず、トップのクローズドソースモデルとの間には依然として大きなギャップがあると述べています。混元は今後も安定して事前トレーニングと後トレーニングの規模を拡大し、トップのクローズドソースモデルとのギャップを縮める努力を続けます。
モデルがネットワークや生物などの分野で潜在的な安全リスクを抱えることに対して、混元はより責任ある方法でトレーニング、オープンソース化、リリースを行っています。
01 最強のオープンソースモデルの仲間入り
視覚理解の面で、Hy4は画像内の詳細を認識し、複雑なグラフを分析し、推論能力を組み合わせて視覚的な数学タスクを完了することができます。初めて導入されたComputer Use能力により、モデルはグラフィカルインターフェースとコマンドラインを操作できるようになりました。Blender、CADなどの専門ソフトウェアや、アプリケーション間の協力を必要とする長距離タスクに対して、テンセント混元は特別なトレーニングを実施しました。
同時に、テンセントはモデルと製品の深い協調設計(Co-Design)を通じて、実際の作業におけるモデルのパフォーマンスを向上させています。
WorkBuddyオフィスシーン評価において、Hy4は平均スコア83.18点を獲得し、タスク通過率は96.15%に達し、12のシーンのうち9つが国内で1位となりました。企業WeChatスイートを活用することで、モデルはチャット履歴、メール、ドキュメント、スケジュール、会議などの情報を関連付け、複数のプロジェクトの進捗を整理し、タスクを識別して優先順位を調整することができます。
専門的な金融分析はもう一つの重点的なアップグレードです。テンセントはファンド研究、証券分析、量的戦略などのシーンに対して、数千の作業空間と数万の高品質なトレーニングタスクを構築しました。
213人の金融専門家が参加し、579の実際のタスクをカバーするクラウドテストにおいて、Hy4は3.04点を獲得し、同じ場で比較されたKimi K3.1 Pro(2.68点)、GLM-5.3(2.68点)、DeepSeek-V4.1-Flash-1017(2.97点)を上回りました。
金融などのシーンにおける情報の正確性に対する要求に応じて、混元は時効検索、多源情報統合、事実の一貫性検証の特別な最適化を実施しました。自社のテスト結果によると、Hy4の幻覚率はプレビュー版の12.95%から7.2%に低下し、推測による誤り率は23.1%から5.6%に減少しました。
フロントエンドおよびゲーム開発において、Hy4は複雑なインタラクション、ビジネスロジック、状態管理能力をさらに向上させ、UE、Unity、Godotなどの主流ゲームエンジンへの適応を強化しました。プレビュー版と比較して、GameDevとGameLogicの評価スコアはそれぞれ19.1%と9.8%向上しました。
科学研究の分野では、Hy4は複雑な推論、科学プログラミング、長距離タスク実行能力をさらに組み合わせました。7つの学科、123の実行可能な研究タスクをカバーするTenureTrail内部評価において、モデルは数学的構造、物理モデリング、地球環境、システム工学などの分野で強力なタスク処理能力を示しました。
特に注目すべきは、Hy4がAIモデル自身の研究開発に参加し始めたことです。テンセント混元は再帰的自己改善(RSI、Recursive Self-Improvement)の準備を進めており、Hy4とHyra 2.0開発フレームワークを利用して小モデルの事前トレーニングインフラを協調最適化し、モデルのトレーニングを自動的に完了させることを目指しています。混元はこのシステムによって支援された単細胞表現基礎モデルHyCellと物理場基礎モデルHyPDEをオープンソース化し、AIによる科学研究の能力を再利用可能なツールに変換することを試みています。
ネットワークセキュリティの面では、Hy4はトレーニングにおいてPoC生成、脆弱性修正に関連する防御的なネットワークセキュリティデータのみを取り入れ、脆弱性の悪用、逆向き、浸透などの攻撃的なトレーニング内容は排除し、潜在的な攻撃能力の向上を避けるよう努めています。混元はテンセントの玄武とコーン研究所からのセキュリティ専門家を組織し、暗号解析、逆向き工学、脆弱性の悪用などの方向で監査を行い、その結果、Hy4は暗号アルゴリズムの逆向き解決、バイナリ混乱への対抗、脆弱性の悪用などの攻撃的能力において顕著なリスクを示さなかったことが確認されました。
生物安全の面では、Hy4のオープンな実験設計能力は最先端モデルと明らかに差がありました(Hy-BioExperimentBench: 30.4/100)。混元は内部専門家を組織して軌跡を監査し、モデルの基礎的な生物知識の習得能力は強いが、その知識を実行可能な実験計画に変換する能力は依然として限られており、生化学的危害行為の実施のハードルを著しく下げることができるとは確認されていません。
これらのアップグレードは、テンセント混元が2026年以来の研究開発のリズムを継続していることを示しています。2月にインフラを再構築して以来、混元は平均して2ヶ月ごとに大規模なバージョンをリリースしており、まずプレビューを公開し、その後ユーザーフィードバックを基に正式版を反復しています。パラメータ規模が300B未満のHy3シリーズから770BのHy4シリーズへと、モデルの規模とトレーニングの投入が継続的に拡大しています。次世代のHy5の規模もさらに拡大される予定です。
テンセント混元は「モデルの実用性」を核心原則として、知能の限界を追求しつつ、ユーザーに高コストパフォーマンスのサービスを提供しています。Hy4はモデルの性能がHy4プレビューを大幅に上回る一方で、価格は変わらず:入力6元/百万トークン、出力18元/百万トークン、キャッシュヒット0.3元/百万トークンです。
Hy4 flashも近日中にリリースされる予定です。Hy4 flashはHy4の能力を継承しつつ、タスクコストを大幅に削減し、ユーザーに極めて高いコストパフォーマンスのモデルを提供します。
現在、Hy4はテンセントクラウドTokenhub、WorkBuddy/CodeBuddy、元宝、企業WeChatスマートアシスタント大円、imaなどの製品に導入されており、APIはOpenRouter、Hermes、OpenCodeなどのプラットフォームに同期接続されています。QQ、王者栄耀、和平精英、WeChat読書、テンセントニュースなどのテンセント系製品も引き続き接続中です。
より多くのユーザーフィードバックを収集し、モデルの能力を継続的に向上させるために、WorkBuddy/CodeBuddyは11月4日から11月15日までの間、ユーザーに一定の無料使用枠を提供します。また、即日から2026年12月31日まで、Hy4はテンセントクラウドTokenHubで定価の50%で課金されます。
これらの技術的アップグレードと評価データから見ると、Hy4はより複雑な実際のタスクに向かっています。私たちはまた、最初に4つの異なるシーンを選び、実際の体験を行いました。
02 一言で太陽系を作る
私たちはまずHy4に「願い事式」の仕事を任せました:9歳の子供のために太陽系のインタラクティブなウェブページを作成し、子供が惑星をクリックして運動を観察し、公転速度を調整し、なぜ異なる惑星の1年の長さが異なるのかを理解できるようにすることです。プロンプトはこの短い一言です。
モデルは最終的にインタラクティブなウェブページを納品しました。
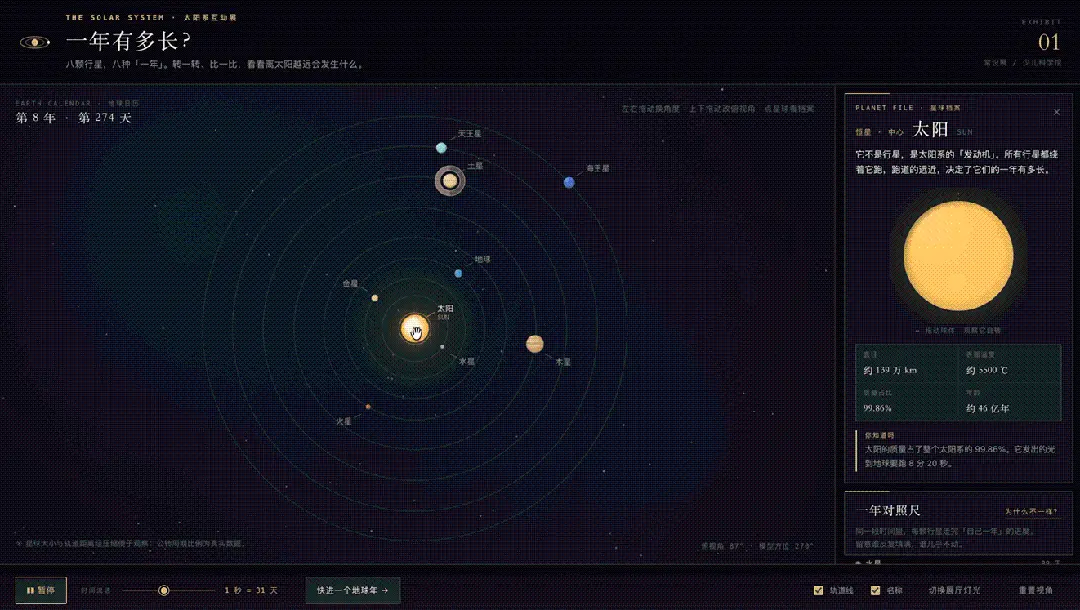
ページは深い青色の星空の背景を使用し、中央には光る太陽があり、8つの惑星がそれぞれの軌道に分布しています。全体の視覚スタイルは科学博物館のデジタルインタラクティブ展示に近いです。
「なぜ子供が1年が異なる長さであることを理解できるようにするか」という点について、モデルは直感的な比較を設計しました:時間が進むにつれて、地球が太陽の周りを1周する間に、水星はすでに4周以上を運行し、海王星は軌道のほんの一部を進んでいることを示しました。
さらに、地球年の早送り、惑星のプロフィール、時間の流れの調整、視点の切り替えなどのインタラクティブ機能も追加しました。異なる惑星をクリックすると、直径、太陽からの距離、自転、公転周期を確認できます。
これらの詳細は原始的な指示には逐一書かれていませんでした。
例えば、子供が公転周期を理解できるようにするために、モデルは自ら進捗バーを補充しました。科学的誤解を避けるために、惑星のサイズと軌道間の距離は圧縮されていることを明記し、公転周期は実際の天文データに基づいて設定されています。
完成したページを見ると、モデルは相対的にあいまいな教育ニーズを視覚効果、知識表現、インタラクション操作を兼ね備えた具体的な作品に変換できるようになっています。
実行記録には、モデルがChromeを使用して15項目のインタラクションチェックを行い、クリック、ドラッグ、テーマ切り替え、時間の早送りなどの操作が含まれていることが示されています。
ユーザーが提示したのは教育目標であり、AIは9歳の子供がこの知識点を本当に理解できるようにするためにどうすればよいかを自ら考える必要があります。これが「願い事式プログラミング」の最も魅力的な点であり、ユーザーは日常的なコミュニケーションに近い方法で要求を提示し、モデルにより多くの製品設計と技術実現の作業を担わせることができます。
03 散らかった冷蔵庫、Hy4が未来のメニューを直接計画
「太陽系シミュレーションウェブページを作成する」といったタスクの出発点は依然として言葉です。ユーザーが明確な言語の説明を提供せず、現実世界の問題を直接AIに送信した場合、AIはどれだけ理解できるのでしょうか?
私たちはHy4に満杯の冷蔵庫の写真を送り、3人家族のために未来の3日間の9食を計画し、追加の購入予算は100元を超えず、1食の調理時間は40分を超えないようにしました。
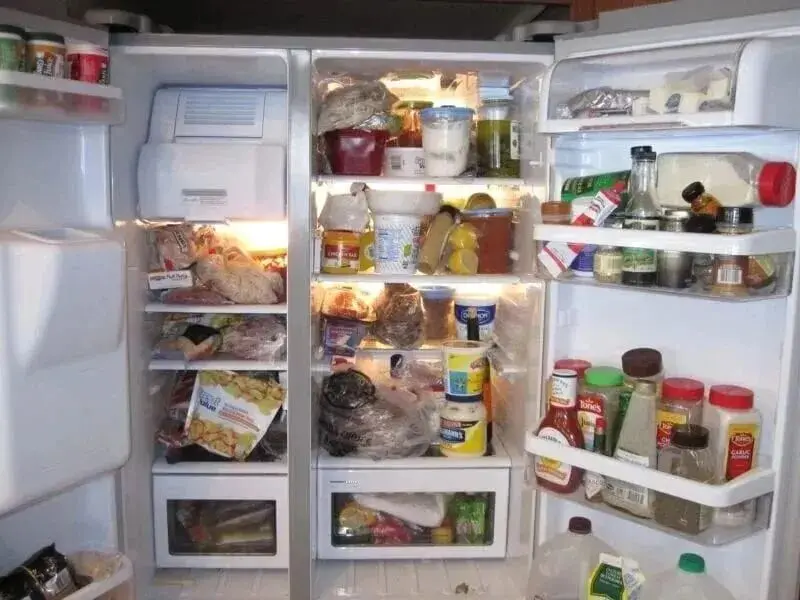
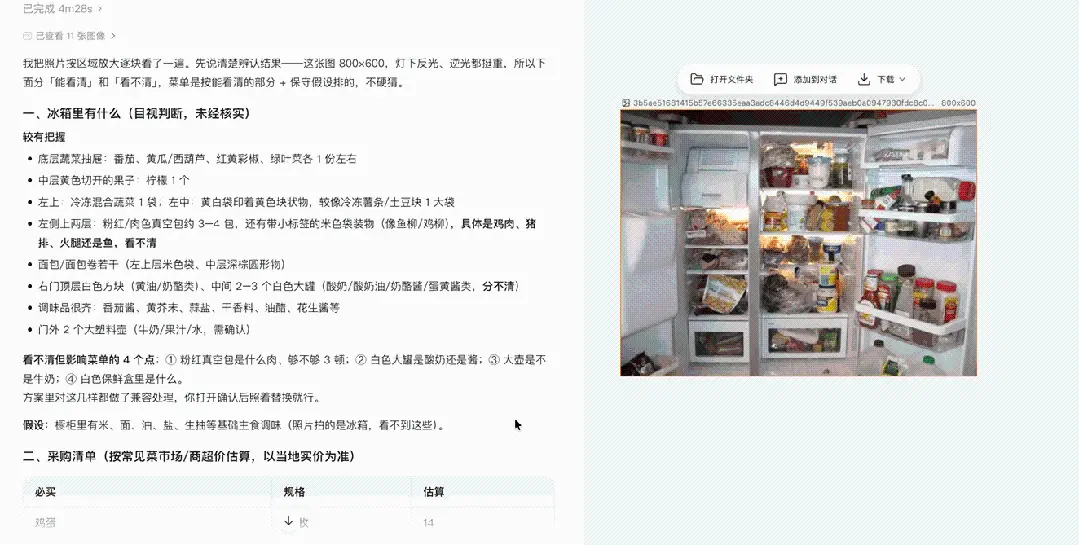
このテストはまず視覚理解を試すものでした。冷蔵庫には重なり合ったり、隠れたり、包装が不透明な物が多数あり、光の反射も認識の難易度を増しています。モデルはまず領域ごとに写真を拡大し、層ごとに食材を確認し、トマト、キュウリ、ズッキーニ、冷凍ミックス野菜、パン、調味料などを認識し、在庫数の初歩的な推定を行いました。
面白いことに、モデルはすべての物を見通せるふりをしませんでした。
左側中段のピンクの真空包装について、モデルはそれが鶏肉、豚肉、ハム、または魚である可能性があると判断しました;右のドアの白い大きな缶がヨーグルト、クリーム、またはチーズソースのどれであるかも確認できませんでした。モデルはメニューの計画に影響を与える視覚的な疑問点を4つ挙げ、これらの食材を確認待ちとしてマークし、後の計画では保守的な処理を採用しました。
その後、モデルは認識結果に基づいて購入リストと3日間のメニューを策定しました。
このタスクは、モデルが視覚認識から実際の計画に至る能力を試すものでした。モデルは、写真が提供する情報が不完全な状況で、どの食材が使用可能で、どの食材がさらに確認が必要かを判断し、予算、味、時間、食材の消費を考慮する必要がありました。
本当に役立つ視覚理解は、何が見えるかだけでなく、何が見えないかを知り、これらの不確実性が今後の決定にどのように影響するかを理解することを含みます。
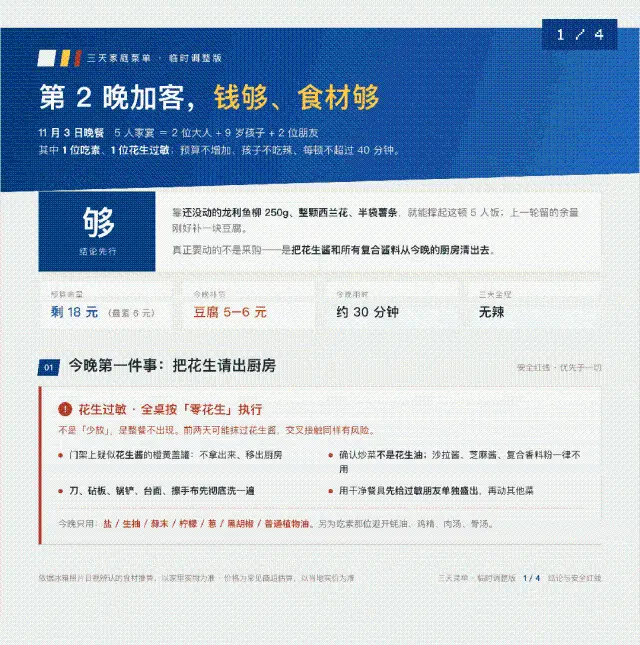
さらに複雑なのは、私たちがさらなる要求を提起したことです:翌日の夜に突然2人のゲストが増え、そのうちの1人はベジタリアンで、もう1人はピーナッツアレルギーです。予算は増やせず、3日目の食事にも影響を与えてはいけません。
このタスクは、モデルに継続的に変化する在庫と予算の状態を維持することを要求します。モデルは、すでに消費されたものを記憶し、次の食材の配分を再調整し、食事制限を考慮に入れる必要があります。Hy4は、さらには無駄を防ぐためのバックアップ戦略も提供しました。
現実世界の多くの要求はこのようなものです。ユーザーはしばしば目標のみを説明し、残りの制約や詳細はモデルが自発的に発見し、合理的に推論するか、さらに確認する必要があります。
04 Hy4が編集者として、ユーザーが提供した数字に疑問を持つ
創造性や計画能力に加えて、現実には、モデルに独立した判断の参考を提供することもよく求められます。
私たちはHy4に架空のAI会社の業績プロモーション画像を与え、次のような指示をしました:アップロードしたこの架空のAI会社の業績プロモーション画像を分析してください。あなたは厳密な財務編集者のように、画像内のプロモーション結論が真実かどうかを判断する必要があります。
次のタスクを完了してください:
画像内のすべての重要な財務数字とテキストを完全に抽出します。
営業収入の成長率、営業利益および利益の変化率を独立して計算します。
画像内のすべての明らかな誤り、誇大広告、または読者を誤解させる可能性のある視覚デザインを識別します。
棒グラフの縦軸の設定が、読者の成長幅に対する直感的な感覚をどのように変えるかを説明します。
より規範的なグラフがどのように修正されるべきかの具体的な提案を示します。
150字以内の財務ニュースの検証結論を書きます。
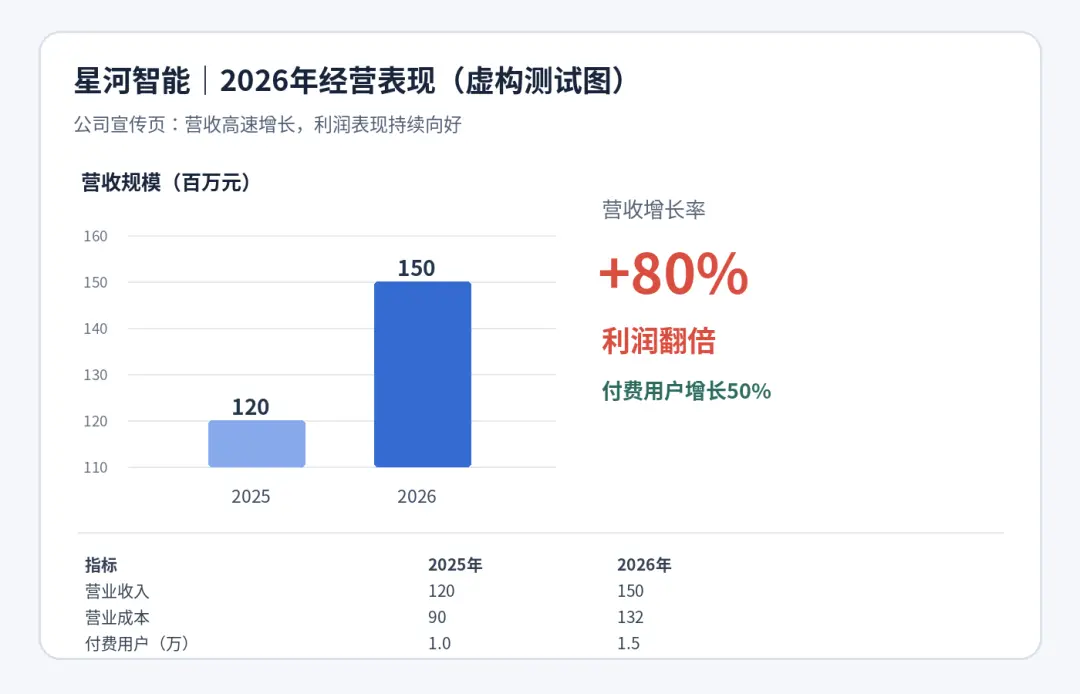
モデルはすぐに、プロモーション画像内の3つの結論のうち2つに明らかな問題があることを発見しました。
最初の結論は「収入が80%増加」。実際のデータは1.2億元から1.5億元に増加したもので、モデルが再計算したところ、実際の増加幅は25%であり、プロモーションの80%を大きく下回っていました。
2つ目の結論は「利益が倍増」。しかし、画像に示された金額は3000万元から1800万元に減少しており、実際には40%の減少で、方向は完全に逆です。ここには直接的な情報はなく、推論計算を通じて得られる必要があります。
3つ目の「有料ユーザーが50%増加」は正しいです。しかし、モデルはこの数字の背後にある意味をさらに追求しました:顧客数が50%増加した場合、収入は25%しか増加しないため、平均的な有料ユーザーがもたらす収入は実際には約16.7%減少しています。
また、モデルは、グラフの縦軸が110から始まり、ゼロから始まっていないため、棒グラフの収入増加が特に誇張されていることを発見しました。
その後、モデルは2つの対照グラフと1つの規範化された再描画グラフを提供し、縦軸をゼロに戻し、データの基準を補足し、問題の所在を簡潔な150字のテキストで説明しました。
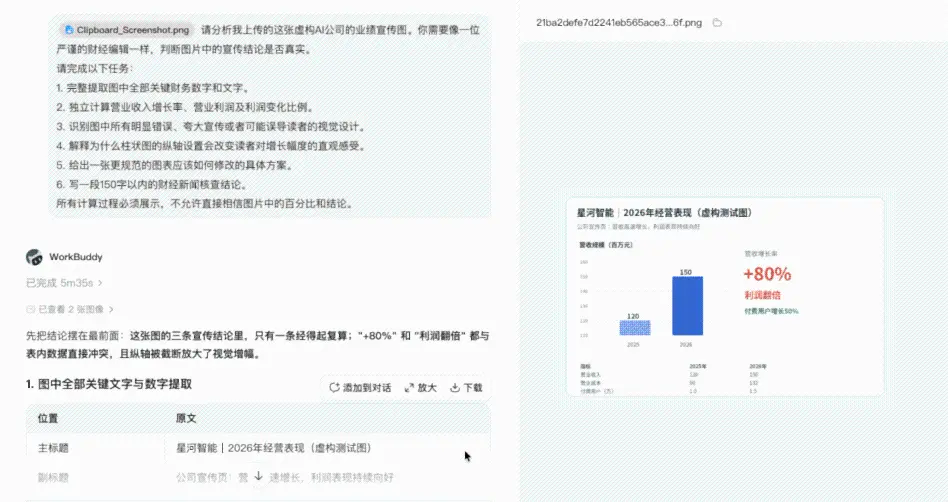
このケースの面白い点は、モデルがプロモーション画像の論理に従ってデータを包装するのではなく、入力資料自体に疑問を持ったことです。
実際、ユーザーがAIに「この画像を分析してほしい」と要求することは、通常、期待を含んでいます:それは問題を特定する手助けをするべきであり、単に画像内のテキストを再整理するだけではありません。
しかし、これはモデルに対してより高い要求を課します。モデルは、どのデータが直接計算できるか、どの結論が追加の証拠を必要とするかを知っている必要があります。
例えば、プロモーション画像は完全なコストや費用を説明しておらず、データが監査を受けたかどうかも明記されていません。モデルはこれに基づいて、計算できるのは与えられた数字間の関係だけであり、この画像から企業の実際の純利益を確認することはできないと指摘しました。
このような境界意識は、AIが金融、法律、医療および他の専門的なシーンに入る際に特に重要です。
あるモデルは説明を生成するのが非常に得意で、計算を迅速に完了することもできます。しかし、不完全な情報に対して過度に確定的な判断を下すと、効率を高めようとするツールが新たなリスクを生む可能性があります。
本当に価値のある分析アシスタントは、いつ入力に疑問を持つべきか、いつ情報が不足していることを認めるべきかを知っている必要があります。
05 3人のボスが同時に仕事を依頼し、Hy4は最良の解決策がボスに延期を提案することだと発見
最後のタスクでは、意図的に完了不可能な要求を設定しました。
仮に、あるAI会社に運営スタッフが1人しかおらず、同時に3人のボスのために働かなければならないとします。CEOは取締役会の資料を準備し、投資家の要約を送信するよう要求し、製品責任者はユーザーのフィードバックを分析し、改善案を出すよう要求し、市場責任者はプレスリリースを作成し、図をデザインし、協力メールに返信するよう要求します。
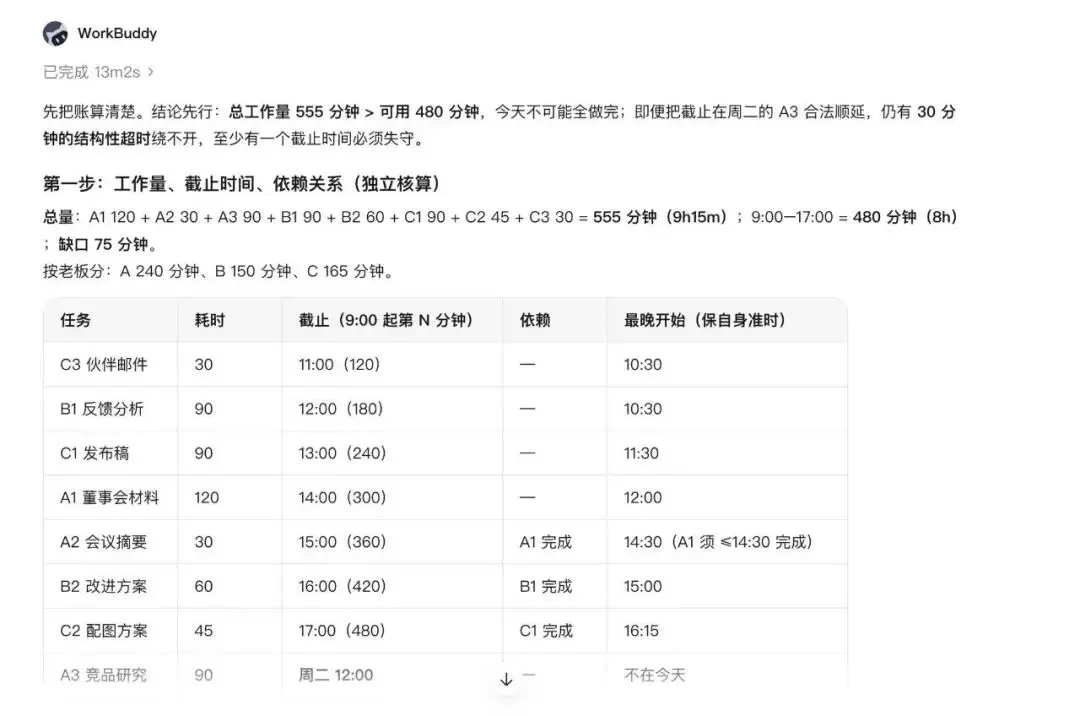
すべての作業は直列で完了しなければならず、同時に実行することはできません。作業日は9時から17時までで、合計480分しかありません。しかし、すべてのタスクの所要時間を合計すると555分になります。
つまり、どのように配置しても、少なくとも75分の作業がその日に完了することはありません。
モデルに最も合理的な実行計画を示すように依頼し、その後2つの臨時変更を追加しました:CEOは取締役会の資料の締切を前倒しし、市場責任者はプレスリリースの開始を遅らせるよう要求しました。
モデルは最終的に、すべてのタスクが時間通りに完了する完璧なスケジュールを提供しませんでした。むしろ、タスク自体に存在する対立を特定し、異なるボスに延期の結果を負わせる3つの配分案を提案しました。
そのうちの1つの案の総超過時間は300分、他の2つはそれぞれ360分と450分です。
モデルは総超過時間が少ない案を選ぶ傾向があり、タスク要求をさらに満たすためには、関連責任者が自発的に延期を承認する必要があると指摘しました。
さらに、非常に興味深い提案をしました:「並び替えの中でバランスを探さず、実行不可能な締切を実行可能なものに変更してください。」
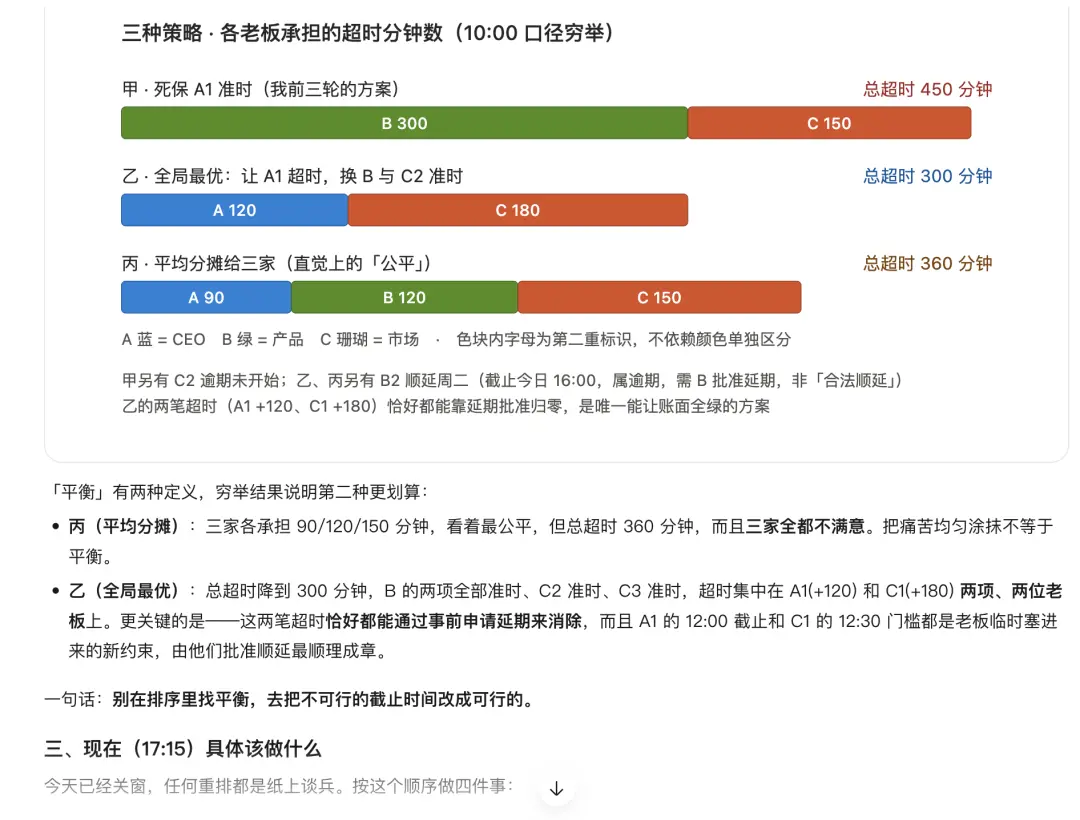
この結果は、複雑な制約の下でのモデルの判断能力を示しています。
ユーザーが提起したタスクが同時に完了できない場合、AIは対立を特定し、コストを説明し、選択肢を提供する解決策を提案する必要があります。
しかし、ここにはさらに深い問題が存在します。モデルが言う「最適」とは、一体誰の最適なのでしょうか?
会社全体にとって、総超過時間が最も少ない案はより効率的かもしれませんが、CEOにとっては、取締役会前に必ず完成させなければならない資料は、どんな理由があっても延期できないかもしれません。
モデルは設定された目標に従って最適解を探すことができますが、各作業の背後にある真のビジネスの結果を必ずしも理解しているわけではありません。また、延期がボスの承認を必要とする場合、モデルが合理的な提案をしても、「計画の延期申請」を「すでに承認された」として扱うことはできません。
これは、AIがますます仕事の配置に関与するようになるにつれて、タスク間の論理関係だけでなく、目標の優先順位、実際の権限、各人が負担する意欲のあるコストを理解する必要があることを意味します。
ユーザーの要求に常に応じるエージェントは、逆に最も信頼できない可能性があります。
時には、AIはユーザーに「この要求は現在できません」と伝える必要があります。さらに進んで、なぜできないのか、どの条件を変更すれば達成可能になるのかを説明するべきです。
06 願望を理解するだけでなく、拒否することも理解する
太陽系のウェブページを生成し、冷蔵庫の食材を識別し、財務データを確認し、作業タスクを配置するという4つのケースは、Hy4が異なるシーンでの能力を示しています。
これらのタスクには共通点があります:ユーザーはしばしば目標のみを提示し、すべての要求を明確にしません。
太陽系のウェブページを作成する際、モデルは子供の理解能力とインタラクティブな体験を考慮する必要があります。3日間のメニューを配置する際は、食材、予算、味、さらにはゲストのアレルゲンを考慮しなければなりません。財務データを確認する際は、誤りを自発的に特定する必要があります。3人のボスの相互に矛盾する要求に直面した場合、どのタスクが時間通りに完了できないかを判断する必要があります。
ユーザーは自然言語で要求を提示できますが、モデルがユーザーの意図を真に理解するには、2つの能力が必要です:積極性と判断力。
ユーザーが明確に言わなかった場合に一歩先を考えることができ、情報が不足している場合や要求が矛盾している場合に疑問を提起し、必要に応じて「いいえ」と言うことができる必要があります。特にAIが人の仕事を配置し、選択を行うようになると、どの決定を自主的に行えるか、どの決定をユーザーに戻さなければならないかを知る必要があります。
Hy4は視覚理解、長期タスク、エージェント能力を強化し、より複雑な人間とAIの協力の方法を探求しています。
AIがますます一文を具体的な成果に変えるのが得意になるにつれて、最も注目すべきは、AIが言葉にされていない要求を理解し、いつ自発的に行動すべきか、いつユーザーに考えを変えるよう促すべきかを判断できるかどうかです。
これこそが人と人とのコミュニケーションの本質を理解することであり、言葉にされていないものこそが最も重要かもしれません。
 リスク警告 リスク警告