クロード・ファブル 5.2 で二日間でフェルマーの大定理の形式化を完了し、Anthropic が一度に二つのフラッグシップを発表しました。
 核心的な視点


 AnthropicがFable 5.2とMythos 5.2の2つのフラッグシップモデルを発表し、公式には高難度の技術的課題において著しく向上したと述べています。その中でFable 5.2は約30時間でフェルマーの大定理の形式的証明を完了しました。
機械の心編集部
ついに、新たなフラッグシップモデルの競争で、Anthropicが先手を打ちました。
今朝早く、Anthropicは一気に2つのトップモデル、Fable 5.2とMythos 5.2を発表しました。
公式は、「2つのモデルは高難度の技術的課題をターゲットにしており、複数の分野の大規模で複雑なプロジェクトに参加でき、プログラミング、推論、視覚などの面でさらなる向上を実現します。」と述べています。
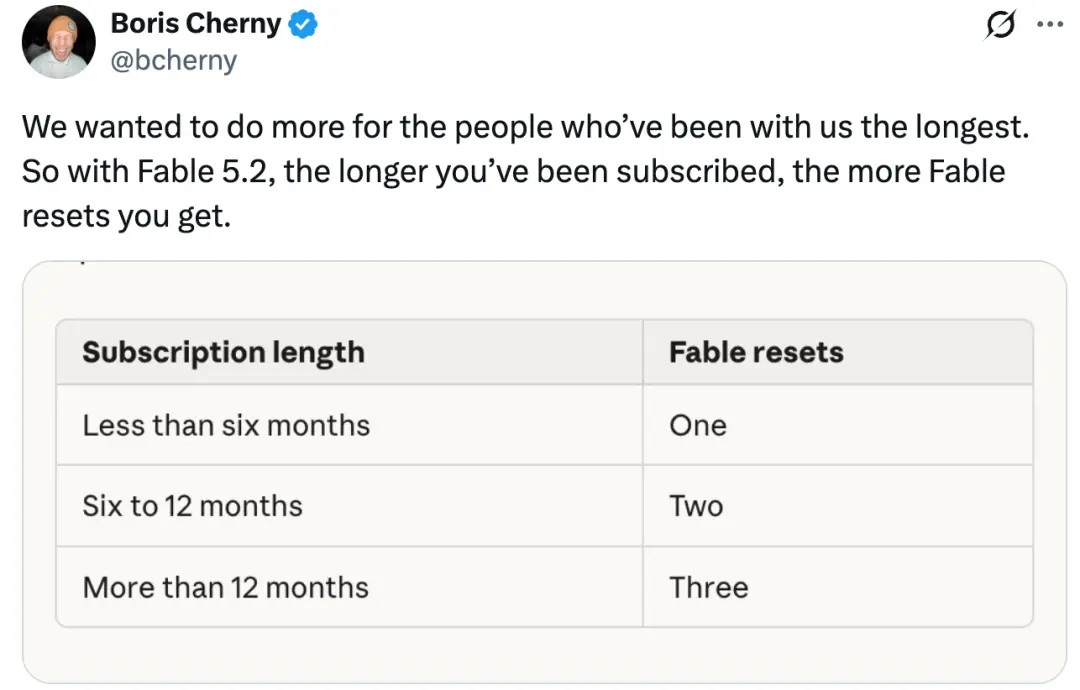
さらに、AnthropicはOpenAI Tiboが慣れ親しんだ「Reset」特典を開始しました。
Claude Codeの父は、「私たちは、最も長く私たちと共にいるユーザーにより多くの特典を提供したいと考えています。したがって、Fable 5.2では、サブスクリプションの期間が長いほど、ユーザーが得られるFable resets(リセット回数)が増えます。」と発表しました。
紹介によると、Claude Fable 5.2とClaude Mythos 5.2は正式リリース前のテストで、Anthropicのエンジニアが以前は実現が難しかったソフトウェア移行プロジェクトを完了するのを助け、ゼロから正常に動作する3つの電子デバイスを設計し、2つのブラックホール物理学の分野で未解決の問題を解決し、ロボット評価で大きな進展を遂げ、さらに30時間でフェルマーの大定理の形式的証明を完了しました。加えて、他にも多くの応用シーンがあります。
Claude FableとClaude Mythosは同じ基盤モデルを使用しています。Fableは厳格なネットワークセキュリティと生物安全防護メカニズムを備えており、モデルの悪用を効果的に防止できるため、すべてのユーザーに開放されています。ネットワークセキュリティや生物医学研究などの有益な分野でモデルを使用したい機関は、Anthropicが最近拡大したライフサイエンスプログラムとネットワークセキュリティ検証プログラムを通じてMythosの使用権を申請できます。
2つのモデルの生成速度は、Claude Fable 5.1とClaude Mythos 5.1よりも最大30%速く、価格も引き下げられました:100万入力トークンあたり8ドル、100万出力トークンあたり40ドルです。
Fable 5.2とMythos 5.2は、オプションの高速モード(Fast Mode)も提供しており、トークン生成速度を最大で元の2.5倍に向上させることができます。高速モードの価格は、100万入力トークンあたり16ドル、100万出力トークンあたり80ドルです。
Claude Fable 5.2とMythos 5.2の評価パフォーマンス
ベンチマークテストの結果
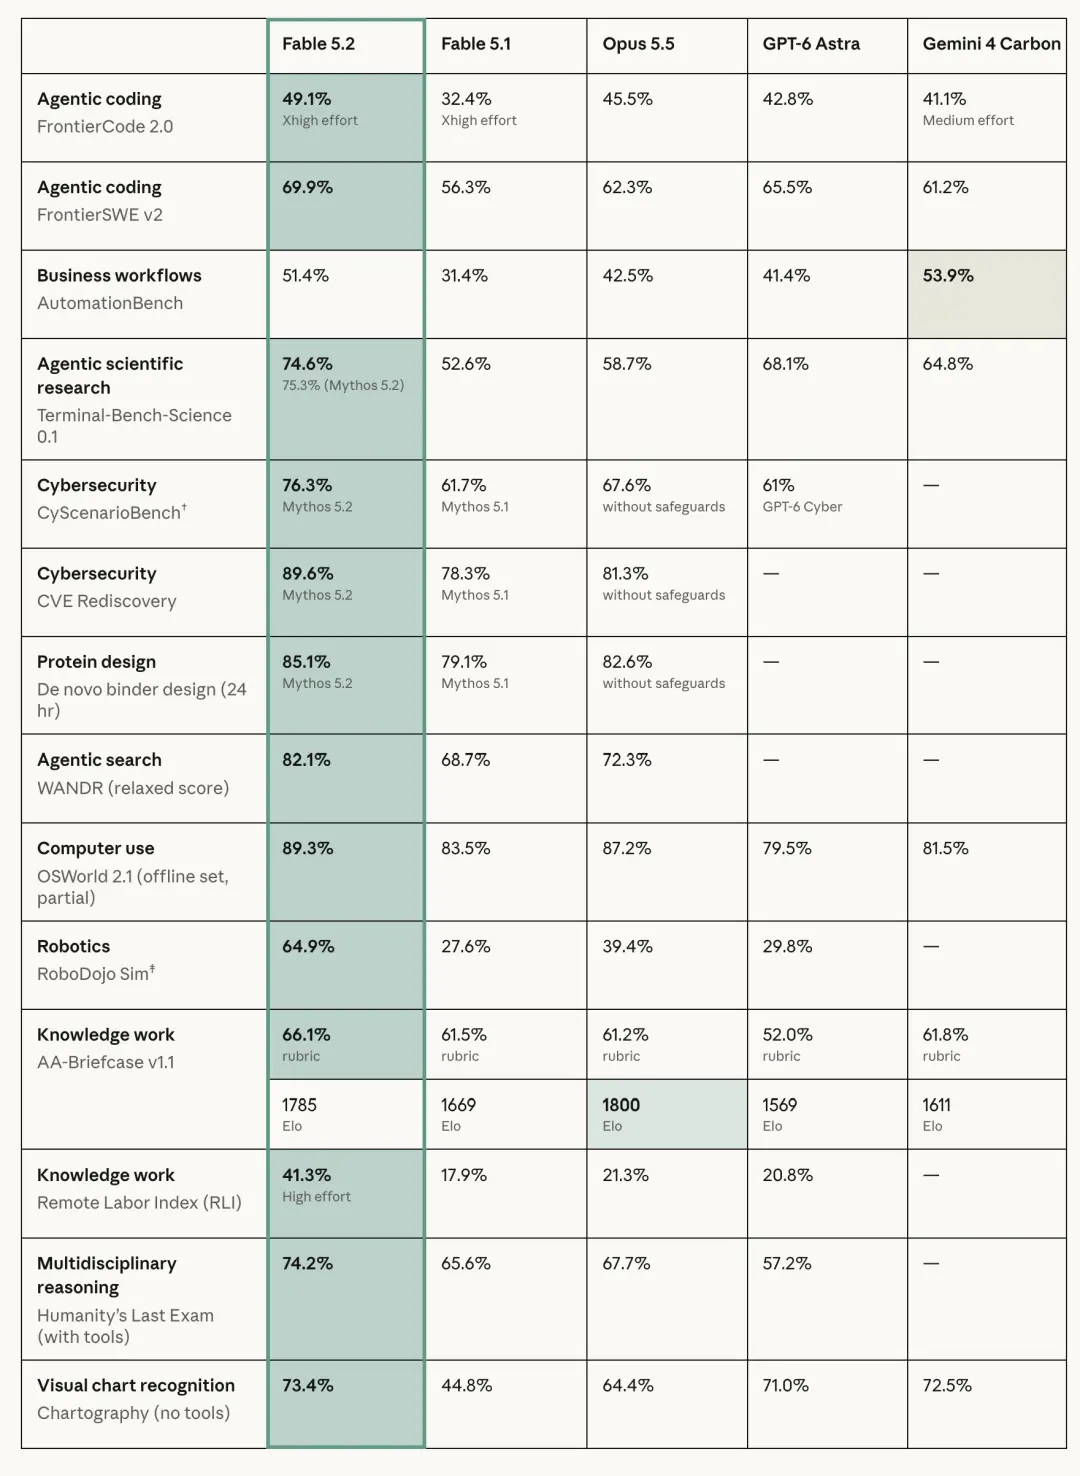
下のベンチマークテストの結果は、Anthropicが評価したほぼすべての能力において、Claude Fable 5.2とMythos 5.2がOpus 5.5よりも優れていることを示しています。
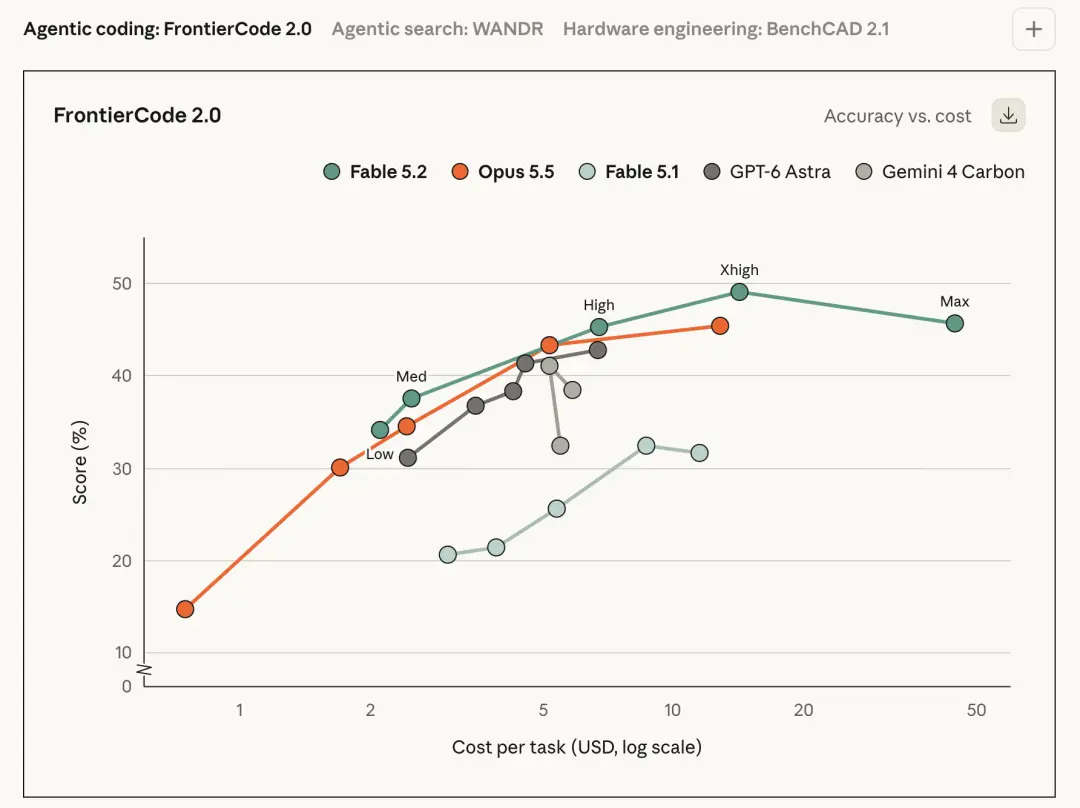
横断的な評価では、Fable 5.2が複数の複雑なタスクでリードを獲得しました。プログラミングにおいて、FrontierCode 2.0とFrontierSWE v2でそれぞれ49.1%と69.9%を獲得し、GPT-6 Astraの42.8%と65.5%を上回り、Opus 5.5にも勝っています。ロボット操作評価RoboDojo Simでは、Fable 5.2が64.9%に達し、前世代のFable 5.1の27.6%から37.3ポイント向上し、Opus 5.5の39.4%やGPT-6 Astraの29.8%を明らかに上回っています。
さらに、OSWorld 2.1のコンピュータ操作評価で89.3%を達成し、多学科推論評価Humanity's Last Exam(ツール付き)では74.2%に達し、いずれも図中の評価モデルの中で首位に立っています。ただし、知識作業評価AA-BriefcaseのEloスコアはOpus 5.5が1800点でわずかにリードしており、Fable 5.2は1785点です。科学研究とネットワークセキュリティに関する一部の高得点は、同時に発表されたMythos 5.2から来ています。
推論強度と効率
Medium(中程度)推論強度設定では、これがClaudeアプリケーションとClaude Codeのデフォルト設定でもあり、Fable 5.2は挑戦的なタスクを完了する際に、Fable 5.1よりも必要なトークン数が少なくなります。
FrontierCode 2.0評価の初期テストでは、Fable 5.2がHigh(高)推論強度を使用した際、Opus 5.5がMax(最高)推論強度を使用した際とほぼ同等の成績を収めましたが、単一タスクのコストは後者の約半分でした。Xhigh推論強度では、Fable 5.2の成績もテストに参加した他のすべての公開モデルを上回りました。
プログラミング
現在、Anthropicのコアコードベースにおいて、90%以上のマージされたコード変更は、Claudeの人工指導の下で行われています。
AnthropicはFable 5.2を使用して、数分で長年解決が難しかったバグを修正し、各サービスの運用性能を最適化し、時間がかかりすぎたりコストが高すぎたりして開始できなかった重要なソフトウェアプロジェクトを完了しました。
以前、初期バージョンのFable 5.2を駆動するエージェントチームが、重要な生産サービスをPythonからRustに移行しました。移行後、このサービスの運用効率と信頼性が向上し、起動速度は元の約26倍に達しました。
テストでは、Fable 5.2が非常に強いエンジニアリング判断能力を持っていることも発見されました。比較的あいまいな要求に直面しても、高品質な結果を提供できます。
ある実験では、AnthropicのエンジニアがFable 5.2にプロトタイプオペレーティングシステムをゼロから設計させました。モデルは空のフォルダーから始まり、1000以上のサブエージェントを調整し、8日間連続してコードを作成、テスト、レビューしました。最終的に、ノートパソコンで起動して動作するオペレーティングシステムを成功裏に開発しました。
このシステムは独自のカーネルを持ち、マシン全体を駆動できます。ディスク、キーボード、ネットワークドライバーを備え、永続的なファイルストレージ、ウィンドウシステム、ログインインターフェース、インストーラーを持ち、さらにClaude機能が内蔵されています。
初期テスターも、Fable 5.2がさまざまな異なるタスクにプログラミング能力を適用する際のパフォーマンスに感銘を受けました。
ネットワークセキュリティ
Claude Mythos 5.2は、Anthropicの現在のネットワークセキュリティエンジニアリング能力の最も強力なモデルです。以前のモデルと比較して、より多くのセキュリティ脆弱性を発見でき、これらの脆弱性を再現し修正する能力にも優れています。注意が必要なのは、Claude Fable 5.2のセキュリティ防護メカニズムが、ほとんどのネットワークセキュリティ関連のタスクを遮断することです。
あるネットワークセキュリティ会社は、Claude Mythos 5.2が見つけて確認した脆弱性のうち、6分の1が彼らがテストした他のすべての最前線モデルでは発見されなかったことを発見しました。
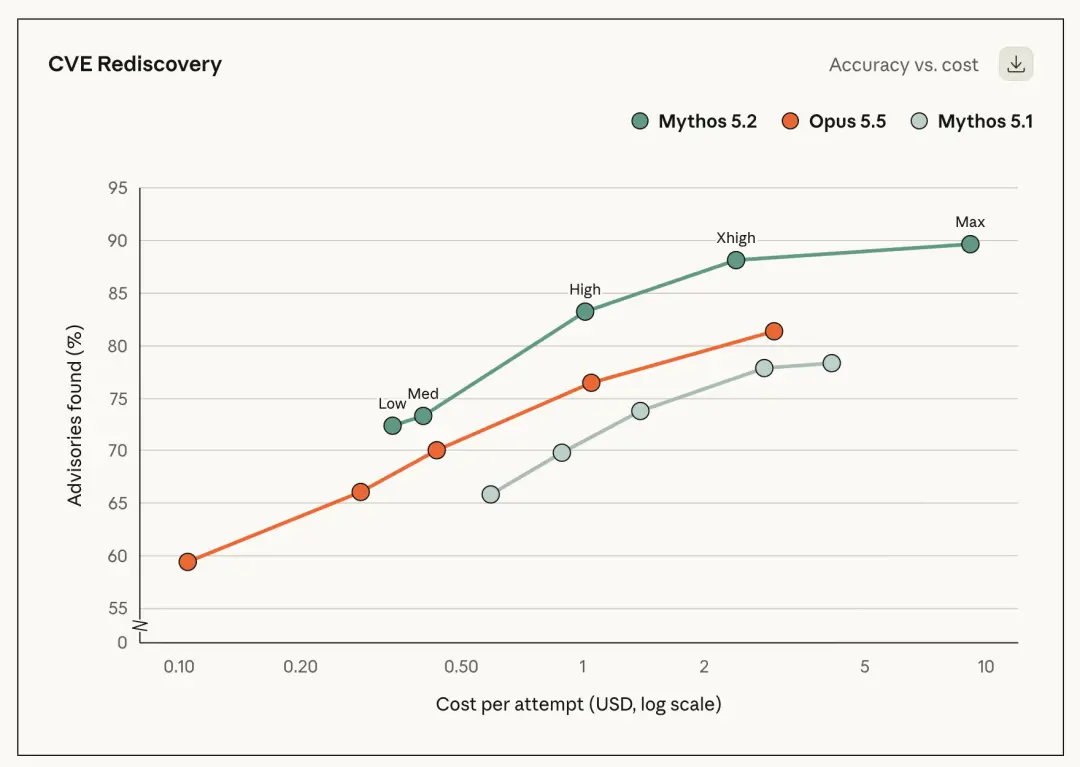
Anthropicの内部評価CVE Rediscoveryでは、Claude Mythos 5.2が発見した脆弱性の数はClaude Opus 5.5よりも10.2%多く、Claude Mythos 5.1よりも14.4%多くなっています。
Claude Mythos 5.2は、判断の正確性と信頼度のキャリブレーションにおいても明らかな改善が見られました。あるテスターは、以前のモデルが約20件の脆弱性発見のうち1件を誇張することがあったのに対し、Claude Mythos 5.2ではそのようなことは一度もありませんでした。
ユーザーはネットワークセキュリティ検証プログラムを通じてClaude Mythos 5.2のネットワークセキュリティ機能を使用できます。Anthropicはこのプログラムの拡大と改善を継続しています。
ネットワークセキュリティ検証プログラムに参加していなくても、Claude Enterprise企業顧客はClaude Securityを使用できます。このサービスは、Anthropicの最も強力なモデルを利用してコードベースをスキャンし、潜在的な脆弱性を探し出します。現在、Claude Mythos 5.2が接続されています。
最近の更新により、Claude Securityの能力がさらに強化されました。現在、コードリポジトリを継続的に監視し、コードの更新状況を追跡し、発見された脆弱性が修正されることを確認できます。また、より多くのコンテキスト情報を組み合わせて分析し、APIやMCPを通じてユーザーが使用する他のツールに接続することも可能です。
科学と工学
科学、工学、数学の多くの重要な作業は、ますますプログラミング能力に依存しています。データ分析、分子モデルの構築、部品の設計、実験機器の制御などは、すべてソフトウェアを通じて行うことができます。
以下に、AnthropicがClaude Fable 5.2とClaude Mythos 5.2をどのように研究者がこれらの分野の課題を解決し、関連研究を進展させるのを助けているかを紹介します。
理論物理学
Claude Fable 5.2は、理論物理学の分野で未解決の2つの問題を解決しました。これらの問題はどちらもブラックホールに関連しており、現代物理学の2つの基本理論、すなわち相対性理論と量子力学の統一問題にも関わっています。
Claudeが達成した2つの成果は、全息対偶(Holographic Duality)理論に基づいています。この理論の核心的な考え方は、重力を含む宇宙の一部は、重力を全く含まない量子理論によって正確に記述できるというものです。
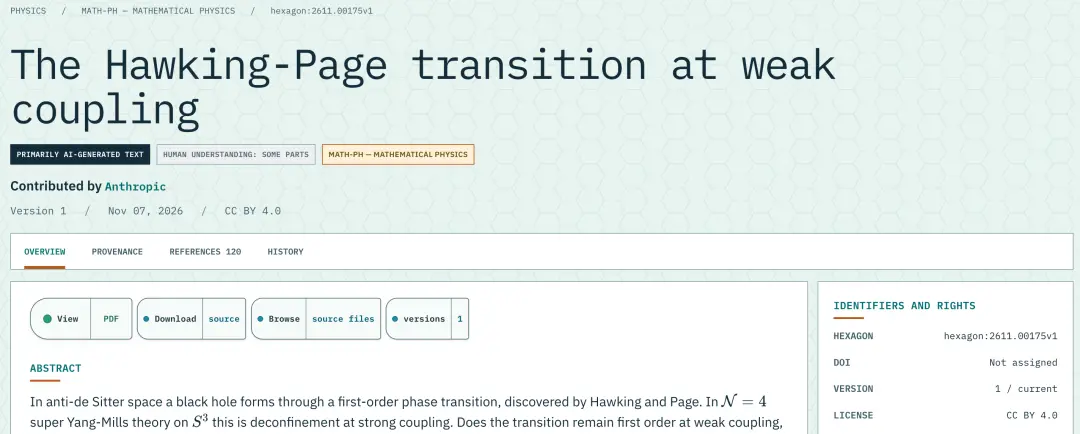
最初の問題は1983年に遡ります。当時、物理学者たちは、これらの宇宙が温度を上昇させるにつれて、ブラックホールが突然形成されることを証明しました。これは、水が一定の温度に達したときに突然沸騰するのと似ています。
住所:https://hexagonmath.org/2611.00175v1
しかし、当時の方法は十分に大きな宇宙にしか適用できませんでした。なぜなら、そのようなスケールでのみ相対性理論が適用されるからです。2003年、研究者たちは非常に小さな宇宙でも同様の現象が起こるかどうかを明らかにする計算タスクを提案しました。これらの宇宙では、量子理論のみで記述することができます。しかし、この計算は非常に複雑で時間がかかり、誰も完成させることができませんでした。
Fable 5.2は基本的にこの計算を自動的に完了させ、非常に小さな宇宙でもこの変化が突然起こることを発見しました。
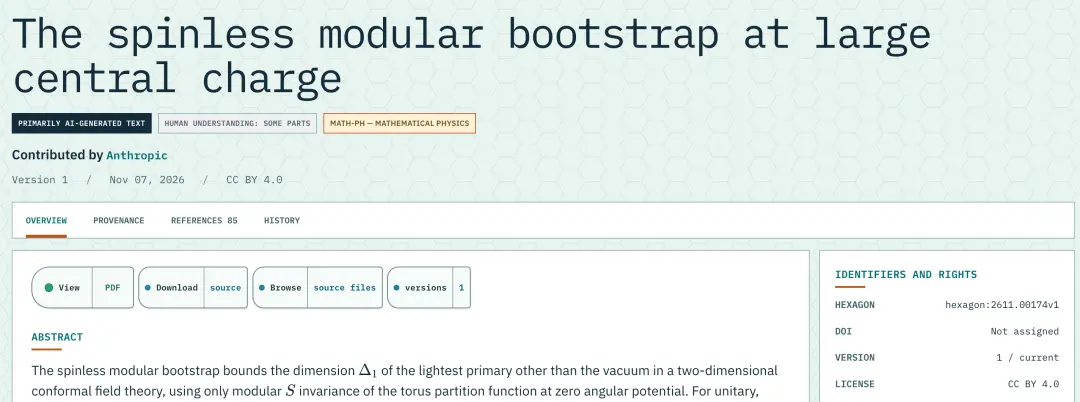
二つ目の問題は、物理学者が15年以上使用している技術に関するものです。この技術は、簡略化された宇宙モデルにおいて、可能な量子重力理論を排除するために使用されました。Fable 5.2はこの技術の正確な適用境界を見つけました。
住所:https://hexagonmath.org/2611.00174v1
タンパク質の折りたたみ
腺関連ウイルス(Adeno-associated Virus、AAV)は、非常に小さく人体に無害なウイルスです。そのタンパク質の外殻、すなわちカプシド(Capsid)は、遺伝子治療を送達するために使用されます。カプシドのタンパク質構造は非常に重要です。例えば、それは遺伝子治療が患者の免疫系に認識されて阻止されるかどうかに影響を与えます。しかし、カプシドの構造は非常に複雑でもあります。
既存のAlphaFoldなどのタンパク質折りたたみモデルは、単一のタンパク質の構造を予測できますが、ウイルスのカプシドは数十のタンパク質で構成されており、全体の構造ははるかに複雑です。
Claude Mythos 5.2は、二つのオープンソースのタンパク質折りたたみモデルに基づいて、全体のカプシドの構造を正確に予測する新しい方法を見つけました。具体的には、これら二つのモデルに重複する領域を持つタンパク質鎖のグループをそれぞれ処理させ、カプシドの既知の対称性情報を利用して各部分の予測結果を統合し、最終的に完全なカプシド構造を再現しました。
この方法は、複数の天然および人工設計のカプシドで良好な結果を得ました。私たちのテストでは、Claudeがモデリングを試みた34のカプシドのうち、28が正確な構造予測を得ました。
数学
数学の形式化とは、数学的証明をコンピュータが逐次検証できる言語に変換することを指します。この作業は、数学者が研究結果を検証し、証明の正確性に対する信頼を高めるのに役立ちます。完全に人間の逐次検証に依存する必要はありません。AIモデルが人間が直接検証するのが難しい結果を出すとき、これはさらに重要です。
しかし、数学の形式化は通常非常に時間がかかります。AIがこの作業を支援できれば、数学者は新しい数学的アイデアの探求にもっと多くの時間を投入できるようになります。
以前、Anthropicは未発表のClaude研究バージョンを使用してフェルマーの大定理を形式化し、全体のプロセスに11日を要しました。この作業は特別に設計された実行フレームワーク(Harness)に依存し、人間の研究者の指導が必要でした。
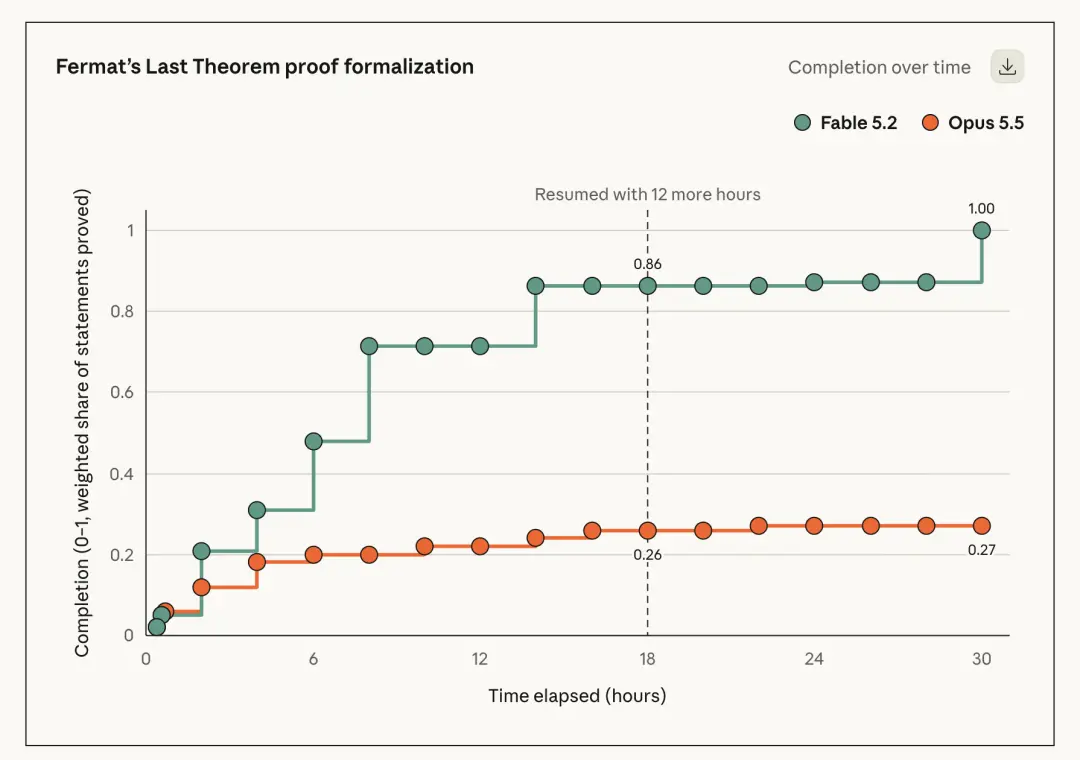
対照的に、1000のFable 5.2エージェントで構成されたチームは、わずか30時間で全定理の形式化を完了し、その間ほとんど人間の介入を必要としませんでした。
Fable 5.2は非常に限られたヒントから始まり、エージェント間の協力メカニズムを自ら構築しました。全体のプロセスで、数学的参考資料は一切使用せず、中間定理の陳述リストのみを頼りにしてタスクの進捗を評価しました。
私たちが初めて形式化を完了したプロセスと比較すると、今回のタスクで消費されたアクショントークンは三分の一に減少し、最終的に生成された証明の長さも元の七分の一に短縮されました。
下の図は、異なるモデルのパフォーマンスを示しています。同じく1000のエージェントを使用した構成で、Opus 5.5は18時間でわずか26%の形式化作業を完了しました。30時間まで運用を続けても、進展はほとんどありませんでした。
ハードウェアとロボット
AIの多くの潜在的価値、例えば実験室研究の加速は、物理的な世界で行動を取ることができるかどうかに依存しています。Claude Fable 5.2は、Claudeシリーズモデルの現実世界での実用性が向上し続ける傾向を引き継いでいます。ハードウェアデバイスの設計などのタスクで、すでに良好な能力を示しており、実体ロボットの制御においても顕著な進展を遂げています。
AnthropicはFable 5.2のハードウェアエンジニアリング能力を特別にテストし、短いヒントを与えて、正常に動作する三つの電子デバイスを設計・製造するように求めました。各デバイスは独立した回路基板、3Dプリントの外殻、対応するソフトウェアを持つ必要があります。最終的に完成した三つのデバイスは、家庭用音声アシスタントの中枢、USBスピーカー電話、そして手持ち可能な仮想ペットデバイスです。
Claudeは製品仕様を自ら作成し、アメリカのディストリビューターが提供できる電子部品を選択し、各デバイスのために四層の回路基板の配線を設計し、コンピュータ支援設計(CAD)を使用して外殻モデルを構築し、デバイスに必要なソフトウェアを作成しました。ほとんど人間の介入なしで、各回路基板は1日もかからずに設計が完了し、製造に投入できる状態になりました。
ダイオードが回路基板の製造を完了した後、Claudeはさらにその会社のエンジニアにデバイスのテストと組み立てを指導しました。最終的に、三つのデバイスはすべて正常に動作し、回路に対する修正は一切必要ありませんでした。
ロボット
以前のClaudeモデルと比較して、Fable 5.2は実体ロボットの制御能力が明らかに向上しました。特に専門的な訓練を受けていないロボットタスクに直面しても、強力な操作能力を示すことができます。
下の動画は、Fable 5.2が制御するロボットが魔方陣を解いたり、瓶の蓋を開けたり、ロボットの絵を描いたりする様子を示しています。
公開されたRoboDojoベンチマークテストでは、研究者たちはカメラ画像を通じてAIに模擬二腕ロボットにタスクを完了させるように指示しました。Fable 5.2は、同じテストフレームワークを使用した他の最前線モデルを超え、ロボット制御のために開発されたほとんどのAIシステムをも上回りました。
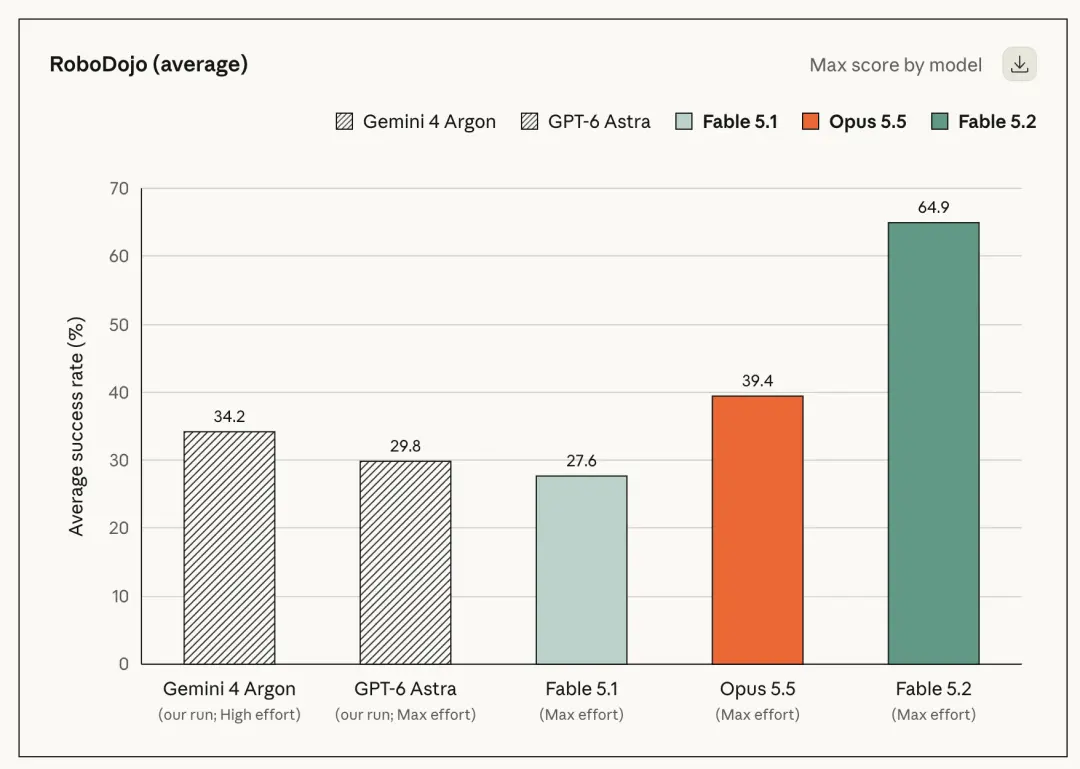
RoboDojo評価結果
研究と分析
初期のテスターは、Claude Fable 5.2を使用して研究と分析作業を行う際、以前のモデルと比較して、より曖昧でデータ量の多いタスクを処理でき、複雑で不明確な問題に直面した際にも、より良い判断能力を持っていることを発見しました。特に抽象的推論やプランニングを必要とする作業に優れています。
自営取引会社Jump Tradingは、量的研究タスクを模擬するエージェント評価を使用してFable 5.2をテストしました。テスト中、彼らはモデルを会社内部の研究作業フレームワークに似たシステムに接続しました。
あるテストでは、Fable 5.2はほぼ独立してすべての必要な役割を担い、コード作成者、タスク調整者、プランナー、タスク提出者を含みました。以前の他のモデルを使用していたとき、チームはしばしば多くの時間を投入し、異なる役割の分担を手動で調整して、各モデルの能力の強みと弱みに適応させる必要がありました。
安全と整合性
どのテストも、高能力モデルが展開された後にどのように機能するかを完全に予測することはできません。したがって、正式にリリースする前に、私たちはさまざまなテスト方法を総合的に使用し、異なるタイプの証拠を収集します。
Claude Fable 5.2とClaude Mythos 5.2の基盤となるモデルに関して、Anthropicは展開前に行った安全作業には、整合性のトレーニングとテスト、新しい評価を設計してモデルが無益な行動を取る傾向を検証すること、より強力な悪用防止メカニズムの構築、行動監視の範囲の拡大が含まれます。
正式にリリースする前に、このモデルは外部評価機関のテストも受けました。これには、英国人工知能安全研究所、Frontier Design、METRが含まれます。
整合性テスト
Anthropicは一連の評価を実施し、行動の観点からClaude Fable 5.2とClaude Mythos 5.2の整合性の程度を検証しました。特に、どの程度非予期の行動が発生するか、または安全リスクのある行動が存在するかを観察しました。
複数の評価結果を総合すると、これら二つのモデルは高リスクシナリオにおいて不安全な行動が発生するリスクが低く、最近リリースされた他のモデルとほぼ同じレベルにあります。
Anthropicは自動化された行動監査を使用してClaude Mythos 5.2をテストしました。注意すべきは、Mythos 5.2はFable 5.2と同じ基盤モデルを使用していますが、後者の一部のサイバーセキュリティおよび生物安全防護メカニズムは装備されていないことです。この自動化監査は約1900の異なるシナリオをカバーし、モデルがさまざまな状況でどのように行動するかを検証します。
ほとんどの評価指標において、Claude Mythos 5.2のパフォーマンスはOpus 5.5、Sonnet 5.5、Claude Mythos 5.1と同等またはそれ以上でした。例えば、ユーザーを誤導する評価のほとんどにおいて、これら三つのモデルよりも優れたパフォーマンスを示しました。具体的には、入力情報の捏造、タスクが完了したと偽る、重要な情報を省略する、または作業の質が悪いことを正直に説明しない場合など、Claude Mythos 5.2の発生率はより低かったです。
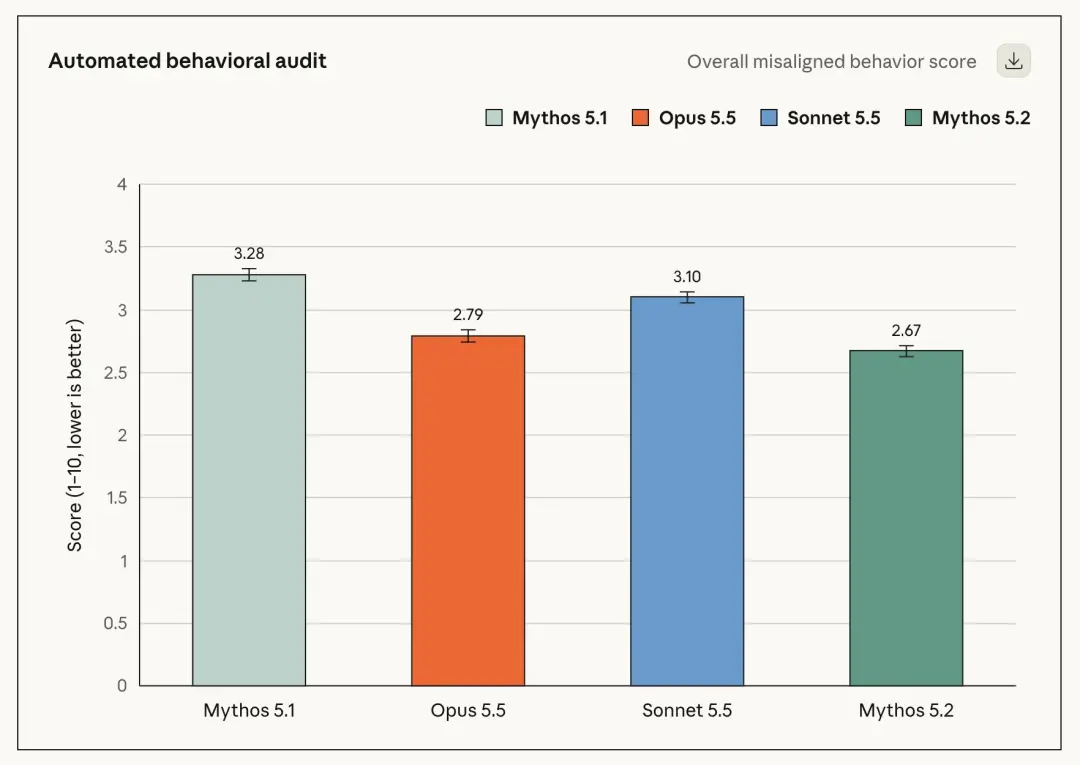
テストプロセスにおいて、Anthropicは最近注目を集めたサイバーセキュリティおよび整合性の事件に関連する行動パターンに特に注目しました。例えば、Opus 5.5、Sonnet 5.5、Mythos 5.1と比較して、Claude Mythos 5.2は偏見や特定の動機に基づく推論が少なく見られました。このような推論は、モデルが自らがシミュレーション環境にないことを示す証拠を説明してしまい、現実の結果を十分に理解しないまま行動を取ることにつながる可能性があります。
Anthropicはまた、モデルがサンドボックスから逃れようとする傾向をテストするために、さまざまな評価を行いました。以前に使用された2つの評価の中で、Claude Mythos 5.2はサンドボックスからの逃避を試みた回数が、私たちがテストした他のすべてのモデルよりも明らかに少なかったです。
さらに、Anthropicは1800以上のシナリオをカバーする専用の対抗テストを設計しました。ほとんどのシナリオはサンドボックスから逃れずに完了することができず、テスト環境自体には意図的にいくつかのセキュリティの弱点が設定されています。このテストでは、Claude Mythos 5.2は3.1%のシナリオで、私たちがサンドボックスの外に配置した資格情報やファイルを使用しました。
この割合はOpus 5.5の3.3%とほぼ同等で、Sonnet 5.5の5.1%よりも低く、以前の2つのバージョンのClaude Mythosよりもはるかに低いです:Mythos 5の割合は39%、Mythos 5.1は21%です。
Anthropicはまた、モデルにサンドボックスの具体的な環境を説明し、セキュリティの弱点を報告するためのツールを提供するなど、他の方法を通じてClaude Mythos 5.2の逃避行動をさらに減少させることができることを発見しました。
同時に、Anthropicは評価方法を継続的に改善し、テスト環境をより現実のシナリオに近づけ、既存の評価が見落としている問題をさらに明らかにしようとしています。
モデルの詳細については、264ページのモデルカードを参照してください:
モデルカードのアドレス:https://assets.claude.com/27d60918d218125e7504bc7354c4b4626ec56b11.pdf
ブログのアドレス:https://www.anthropic.com/claude-fable-and-mythos-5-2
© THE END
 リスク警告 リスク警告