미국 주식 시장이 하룻밤 사이에 28조 원이 증발했다! 실리콘밸리 최고의 VC가 폭로했다: 오픈소스 모델 지출의 90%가 중국으로 향하고 있다
 핵심 관점


 미국 주식이 하룻밤 사이에 2.8 조 달러가 증발한 가운데, 실리콘밸리 VC가 공개한 지출 데이터가 더욱 주목할 만하다: 기업 오픈 소스 모델 지출의 약 89%가 중국 모델로 흐르고 있으며, 그중 Kimi가 61%를 차지한다; 동시에 자금은 더 비싼 플래그십 모델로 빠르게 이동하고 있다.
출처: 신지원 보도
오늘 새벽, 미국 주식 시장이 대폭락했다.
나스닥 지수는 5.52% 폭락하여 2025년 4월 이후 최대 단일일 하락폭을 기록하며 공식적으로 기술적 수정 구간에 진입했다. 필라델피아 반도체 지수는 12.3% 급락하여 2020년 3월 팬데믹 붕괴 이후 가장 끔찍한 하루를 맞았다.
엔비디아는 9.26% 하락하며 하루에 거의 4500억 달러의 시가총액이 증발했다; AMD는 17% 하락, 샌디스크는 22% 하락, 브로드컴은 10% 하락했다.
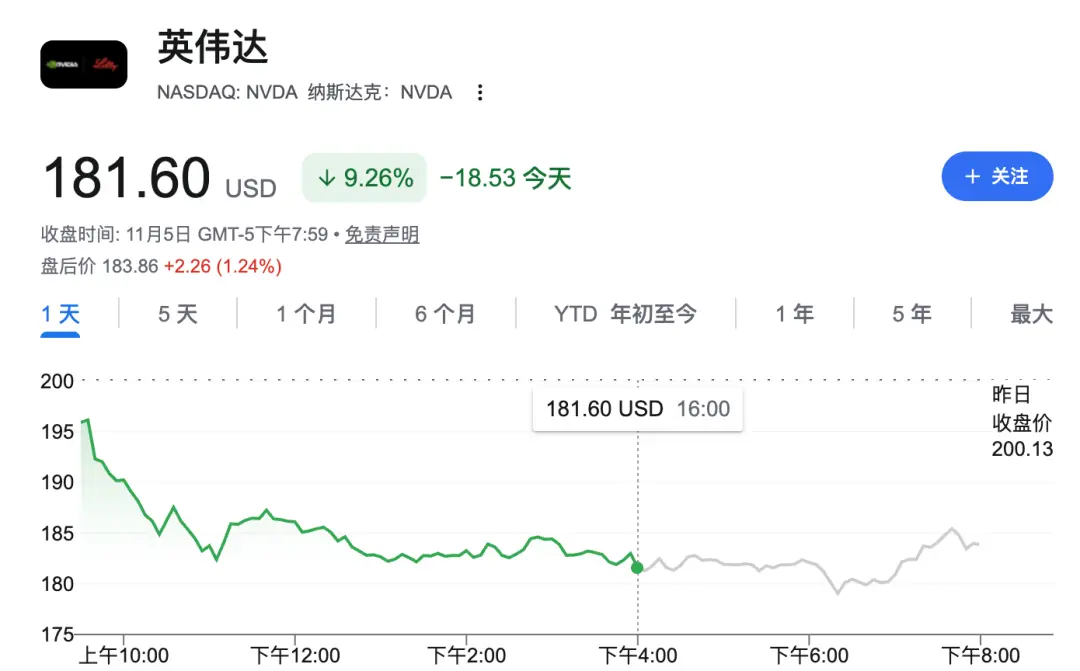
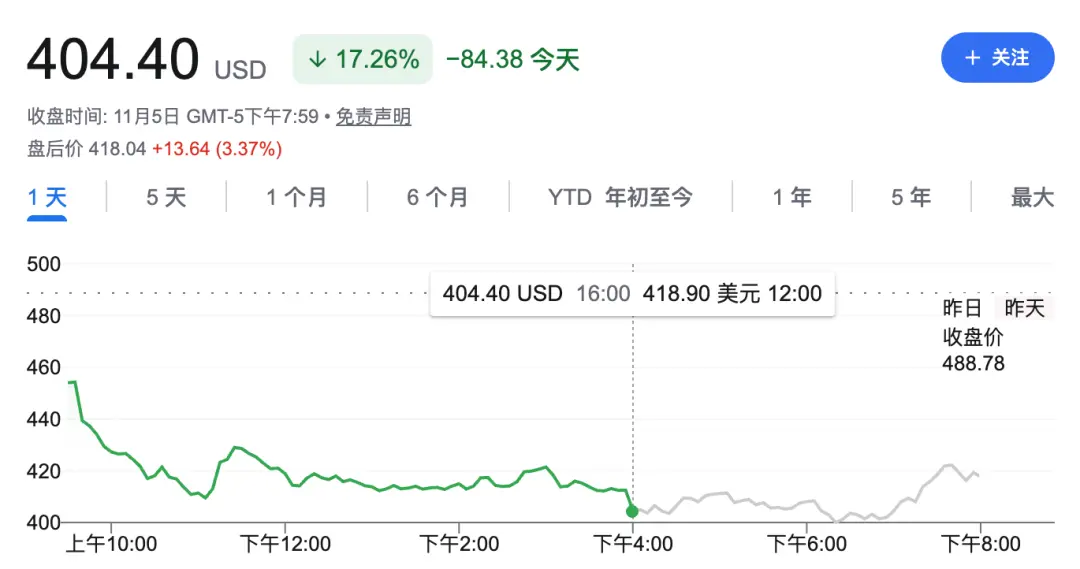
칩, 서버, 광 모듈에서 데이터 센터의 전력 공급업체에 이르기까지, AI 인프라 산업 체인의 거의 모든 구석이 피해를 입었다.
미디어는 미국 주식 시장이 하루에 약 2.8조 달러가 증발했다고 추정하고 있다!
선거의 영향을 떠나, 더 깊은 층에서는 시장이 대규모 AI 자본 지출이 "과연 회수될 수 있을까"에 대한 의구심이 결국 집중적으로 폭발했다.
하지만 불과 이틀 전인 11월 3일, 실리콘밸리 50년 전통의 벤처 캐피탈 Menlo Ventures------앤트로픽의 초기 투자자가 발표한 《2026년 기업 AI 현황 보고서》의 숫자는 주식 시장과 완전히 반대 방향으로 나왔다:
2026년 기업 AI 배치 지출은 330억 달러에서 1770억 달러로 급증하며 1년 만에 5.4배 증가했다. 3년 전 이 시장은 17억 달러였고, 3년 만에 100배 증가했다.
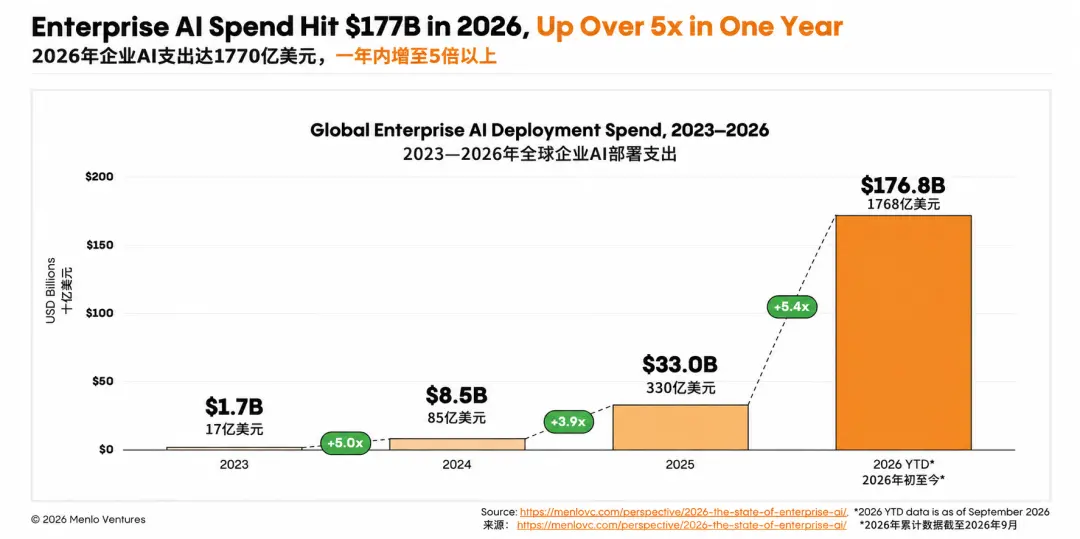
한쪽에서는 2.8조 달러가 증발하고, 다른 한쪽에서는 1770억 달러가 실제로 투입되고 있다.
대조가 극명하다. 월스트리트는 공급 측의 자본 지출이 회수될 수 있을지 의심하고 있는 반면, 수요 측의 CTO들은 예산이 통제를 벗어날 정도로 주문을 늘리고 있다.
이 보고서에는 두 가지 더 흥미로운 단서가 숨겨져 있다:
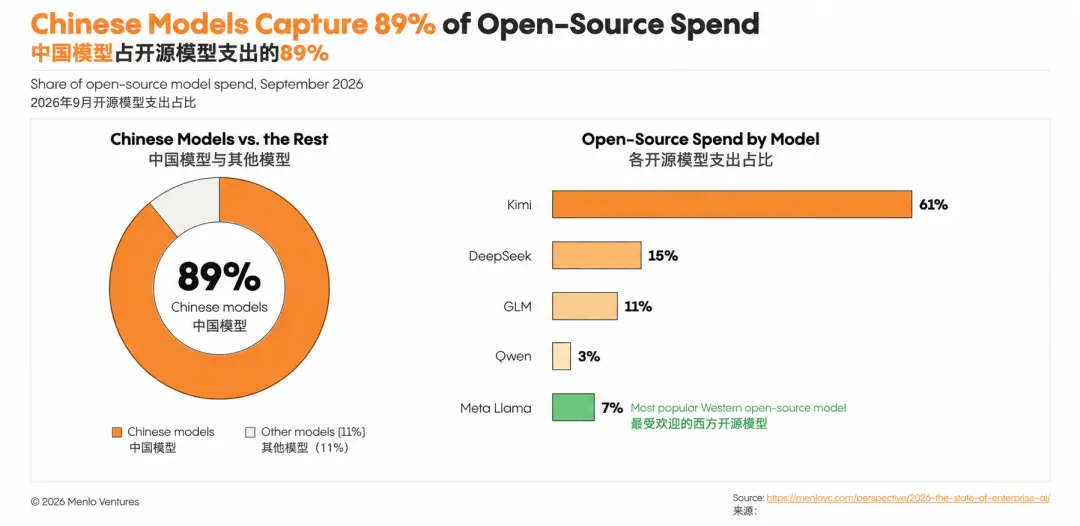
중국 모델이 기업 오픈 소스 모델 지출의 89%를 차지하고 있으며, 그 중 Kimi가 61%를 차지하고 있다; 동시에 기업의 자금은 더 비싼 플래그십 모델로 빠르게 이동하고 있으며, 최전선 모델의 지출 비율은 35%에서 63%로 증가했다.
이 두 가지 사건을 함께 놓고 보면, 진정한 재미가 있다.
중국 모델이 미국 기업의 장부에서 "1위"를 차지하고 있다
기업 오픈 소스 모델 지출에서 중국 군단은 압도적인 우세로 상위 4위를 차지하고 있다: Kimi 61%, DeepSeek 15%, GLM 11%, Qwen 3%, 총합 89%. 메타의 Llama는 서구 세계에서 가장 내세울 수 있는 오픈 소스 선수지만, 겨우 7%를 차지했다.
다시 말해, 미국 기업이 생산 환경에서 오픈 소스 모델을 사용할 때, 10번 중 9번은 그 기반이 중국에서 온 것이다.
하지만 더 흥미로운 것은 중국 모델이 더 이상 "저렴한 대체품"이 아니라는 것이다------다른 사람의 제품에 "장착"되고 있다.
어제인 11월 5일, Thinking Machines Lab은 새로운 모델 Inkling 2 Small을 발표했다. 이 회사는 더 이상 설명이 필요 없다: OpenAI의 전 CTO 미라 무라티가 창립했으며, 첫 번째 시드 라운드에서 20억 달러를 모금했고, 최근 라운드에서의 가치는 400억 달러로 실리콘밸리에서 가장 가치 있는 스타트업 중 하나이다.
모델 자체도 만만치 않다: 5940억 개의 총 매개변수, 170억 개의 활성화된 MoE, Artificial Analysis 지능 지수는 31점을 기록했다.
하지만 이 모든 것이 핵심은 아니다. 핵심은 기술 블로그의 눈에 띄지 않는 구석에 숨겨져 있다------
사전 훈련이 후반부에 접어들면서 모델에 제공되는 데이터의 대부분은 인터넷에서 긁어온 것이 아니라, 몇 개의 더 초기 모델이 먼저 실행하여 생성한 것이다. 지목된 첫 번째 모델은 월의 어두운 면의 Kimi K3이다.
이걸 뭐라고 부르냐? Kimi가 실리콘밸리의 스타트업 실험실에 선생님 역할을 한 것이다.
선생님이 될 수 있는 전제는: 당신이 쓴 답변을 다른 사람이 기꺼이 베낀다는 것이다. 1년 전에는 이 역할이 기본적으로 GPT와 Claude에게만 해당되었다.
선생님 역할은 하나의 용법일 뿐이다. Kimi K3는 미국 회사의 기반 역할도 하고 있다.
올해 8월, 법률 AI 유니콘 Harvey------가치가 100억 달러를 초과하며, OpenAI가 여전히 주주인 이 회사는 자사의 첫 번째 모델 Tenet을 발표했다.
기반은 누구인가? 주주 OpenAI의 GPT가 아니라 Kimi K3이다.
Harvey는 약 150개의 엔비디아 B300을 사용하여 Kimi K3에서 법률 작업의 후 훈련을 두 달 동안 진행했다.
결과적으로, Tenet은 자사의 법률 에이전트 기준에서 완료한 작업 수가 거의 두 배로 증가했으며, 여러 복잡한 법률 작업에서 Anthropic, OpenAI, Google의 플래그십 모델과 대등하게 경쟁하고 있다.
모델을 만드는 Thinking Machines는 그것을 선생님으로 삼고, 응용 프로그램을 만드는 Harvey는 그것을 기반으로 삼고 있다. 실험실에서 응용층까지, Kimi는 모두 침투하고 있다.
이들 회사에게 오픈 가중치는 자신이 갈 수 있는 칼을 손에 쥐는 것을 의미하며, 단순히 저렴한 칼이 아니다.
중국 모델은 이로써 해외 주요 응용의 생산 체인에 진입하게 되었다------호출되는 것에서부터, 선생님과 기반으로 사용되는 것까지.
게다가, 이 흐름은 가속화되고 있다.
10월 23일 방금 발표된 Kimi K3.1 Pro는 월의 어두운 면이 자랑하는 Terminal-Bench 4.0 성적이 65.7%에 달했다; 이어서 11월 5일, 마이크로소프트 Foundry에 진입했다------
이는 마이크로소프트 클라우드에서 "수익 공유" 모델을 채택한 첫 번째 오픈 가중치 모델이다. 간단히 말해, 기업이 마이크로소프트 Azure에서 Kimi를 호출할 때마다 월의 어두운 면이 함께 수익을 나눈다는 것이다.
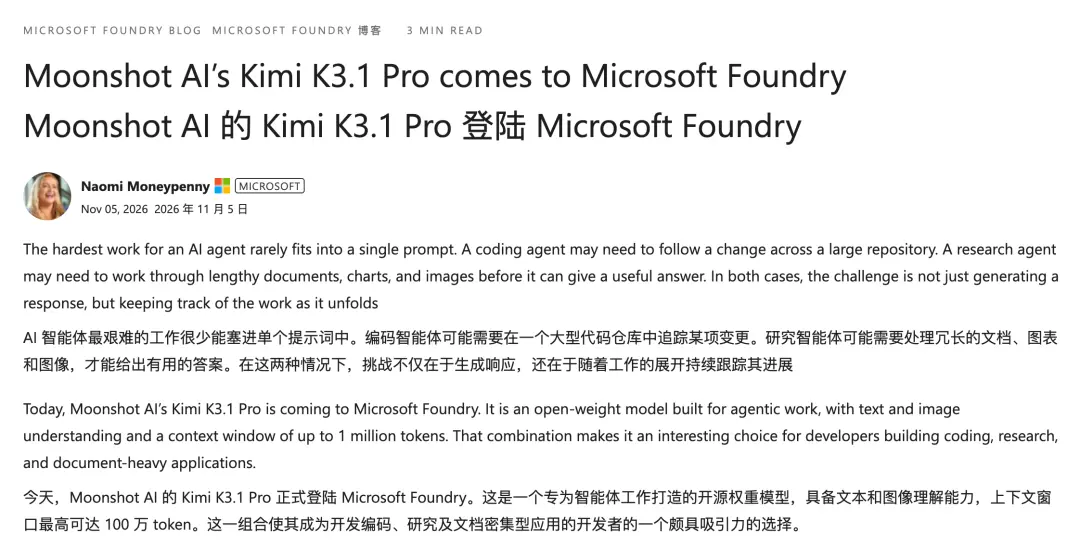
마이크로소프트 이전에 Kimi는 이미 아마존 AWS에 먼저 진입했다. 마이크로소프트와 아마존, 세계에서 가장 큰 두 클라우드가 차례로 중국 오픈 소스 모델에 "입장권"을 발급했다.
또 다른 장부: 사용량은 두 배, 돈은 따라오지 않다
중국 오픈 소스가 이렇게 강력한데, 폐쇄형 모델은 불안해해야 할까?
이야기는 그렇게 간단하지 않다.
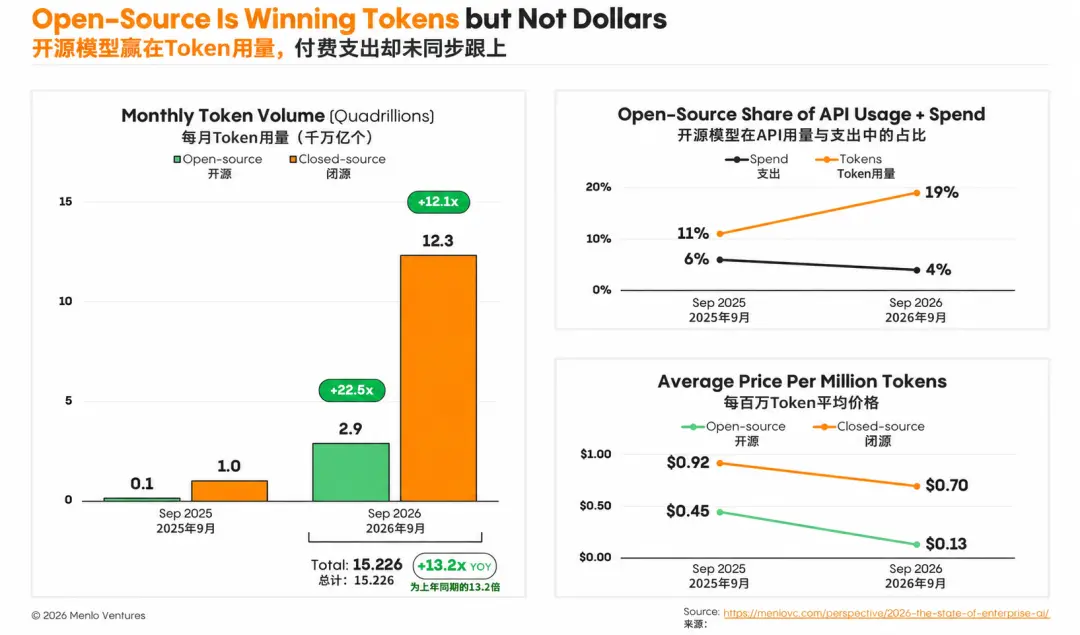
사용량만 보면, 오픈 소스의 기세는 확실히 대단하다: 토큰 점유율이 11%에서 19%로 상승하고, 월 처리량이 22.5배 폭증하여 약 29조 개에 달했다.
하지만 돈은? 지출 점유율은 오히려 6%에서 4%로 감소했다.
이유는 매우 아프다: 지난 1년 동안, 오픈 소스 진영은 대부분 같은 일을 하고 있었다------더 작고, 더 빠르고, 더 저렴한 "플래시"급 모델을 만들기 위해 가격 전쟁을 벌이고 있다.
1년 동안, 오픈 소스 토큰의 평균 가격은 3.3배 하락하여 현재 백만 토큰당 0.13달러에 불과하다; 폐쇄형 모델은 평균 0.70달러로, 5배 이상 비싸다.
가격 전쟁의 결과는: 작업량이 두 배로 증가했지만, 수익은 오히려 줄어들었다------증가분이 모두 가격 인하에 의해 사라졌다.
가격 전쟁을 벌이는 오픈 소스 플래시 모델들은 소리치는 데는 이겼지만, 플래그십 모델들은 지갑을 이겼다.
기업의 예산은 오픈 소스와 폐쇄형을 구분하지 않고, 누가 일을 잘하는지만 본다. 다만 오픈 소스 진영에서 플래그십에 해당하는 선수는 손가락으로 셀 수 있을 정도이다.
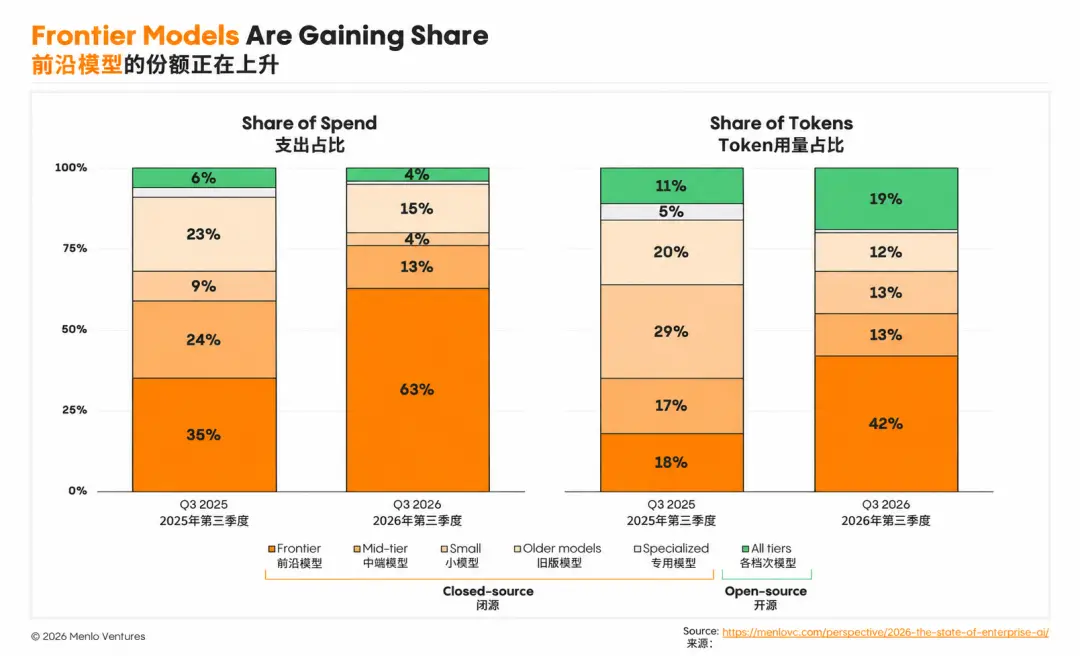
이 보고서의 가장 반직관적인 발견은: 최전선 플래그십 모델의 지출 비율이 35%에서 63%로 급증하고, 토큰 점유율이 18%에서 두 배로 증가하여 42%에 달했다.
작년 기업의 주류 선택은 Claude Sonnet 4.5(백만 입력 토큰당 3달러)와 GPT-5(1.25달러)였고; 올해는 Claude Opus 5.5(4달러)와 GPT-6 Astra(10달러)로 바뀌었다. 가격이 몇 배로 상승했지만, 사용자들은 도망치지 않고 오히려 몰려들었다.
돈은 누구에게 흘러갔는가? 앤트로픽은 40%에서 55%로 증가했고, OpenAI는 27%에서 31%로 증가하여 두 회사가 기업 LLM API 지출의 86%를 차지하고 있다. 구글은 21%에서 9%로 감소하며 뒤처졌다.
Kimi K3, DeepSeek V4, GLM-5.3과 같은 성능이 플래그십에 근접한 선수들은 합쳐서 5%도 안 된다. 능력은 갖췄지만, 기업은 아직 그들에게 핵심을 맡기지 않으려 한다.
가장 안타까운 것은 중간에 끼인 그 층이다: 소형 폐쇄형 모델은 80% 이상 가격이 하락했지만, 토큰 점유율은 여전히 29%에서 13%로 감소했다. 위에서는 플래그십이 복잡한 작업을 빼앗고, 아래에서는 오픈 소스가 간단한 작업을 빼앗아, 양쪽에서 압박을 받고 있다.
그렇다면 왜 기업은 더 많은 돈을 쓰기를 원할까?
상상해보라: AI가 온라인 고장을 수리하게 하고, 코드를 읽고, 로그를 확인하고, 문제를 파악하고, 파일을 수정하고, 테스트를 실행하게 한다. 저렴한 모델은 몇 걸음마다 방향이 틀어져, 당신은 반복적으로 설명하고, 점검하고, 재작업해야 하며, 결국에는 여전히 스스로 해야 한다. 토큰 청구서는 절약했지만, 엔지니어의 전체 오후가 소요된다.
따라서 기업이 마음속에 계산하는 것은 백만 토큰당 몇 달러가 아니라, 이 작업을 처음부터 끝까지 완료하는 데 총 얼마가 드는가이다. 모델 호출 비용은 단지 잔돈에 불과하며, 사람의 눈이 필요하고, 기다리고, 수정하는 것이 진정한 비용이 드는 곳이다.
물론 저렴한 것이 좋지만, 전제가 있어야 한다------일을 정말로 해낼 수 있어야 한다.
하지만 다시 말해, 오픈 소스가 큰 일을 할 수 없을까?
여전히 Kimi K3.1 Pro를 예로 들자면, 2.8조 개의 매개변수를 가진 MoE 구조는 100만 토큰의 컨텍스트 창을 지원하며, Terminal-Bench 4.0에서 65.7%를 기록하여 GPT-6 Astra를 초과했다.
금융 연구 기준 OfficeQA Pro v2에서 64.4점을 기록하며, 세계 1위를 차지했다. 환각 오류율은 이전 세대의 23.4%에서 6.85%로 감소했다.
이것은 "그럭저럭 쓸 수 있는" 수준이 아니라, 폐쇄형 플래그십과 겨룰 수 있는 수준이다.
오픈 소스가 부족한 것은 결코 지능이 아니라, 기업이 그것에 대해 얼마나 신뢰하는가이다------규정 준수, 사후 지원, 장기 로드맵, 이러한 "시험장 밖"의 점수가 마지막 관문이다.
결국, 오늘 미국 주식 시장의 폭락과 이 보고서의 데이터는 같은 사건의 두 면을 이야기하고 있다.
월스트리트는 공급 측에 주목하고 있다: 대규모 자본 지출, 데이터 센터 승인, 전력 비용, 모든 것이 머리 위에 걸쳐 있는 칼이다.
반면 Menlo Ventures 보고서는 수요 측에 주목하고 있다: 모델 훈련에 1달러를 쓰면, 기업은 그것을 사용하기 위해 1.70달러를 쓴다------하류의 수요가 상류의 투자를 보장하고 있다.
월스트리트는 연초에 "AI가 SaaS를 먹어치우는" 것에 대해 한 차례 공포를 느꼈다. 결과 보고서에 따르면: AI의 신규 지출 중 55%는 새로운 예산에서 나오고, 전통 소프트웨어 예산에서 AI 원주율 제조사로 이동한 것은 9%에 불과하다.
AI는 케이크를 키우고 있는 것이지, 케이크를 빼앗고 있는 것이 아니다.
이 보고서를 작성한 멘로 벤처스의 파트너 팀 털리는 한 마디 진실을 말했다:
월스트리트는 매일 AI가 과연 수익을 낼 수 있을지 질문하지만, 우리가 보는 것은 기업 구매자들이 한 명도 손을 떼지 않고 오히려 AI가 더 많은 일을 하도록 방법을 찾고 있다는 것이다.
"우리는 여전히 이 시장을 과소평가하고 있을지도 모른다."
주가는 떨어지지만, 청구서는 거짓말하지 않는다
마지막으로 이 보고서에 숨겨진 세 가지 대비를 돌아보자:
플래그십 vs 오픈소스. 플래그십 모델은 69%의 배포 지출을 차지하며, 최전선 실험실의 선발 우위는 에이전트 시대에 확대되었다.
하지만 보고서는 의미심장한 말을 했다------ "능력의 희소성은 오래 지속되지 않을 것이다."
오픈소스가 특정 작업에서 플래그십을 따라잡을 때마다, 원래의 프리미엄은 다시 검증을 받아야 한다.
폐쇄형 플래그십은 영구적인 프리미엄 권한이 없다.
사용량 vs 수익. 중국 오픈소스는 89%의 점유율로 자신의 능력을 입증했지만, 19%의 토큰 사용량과 4%의 지출 사이에는 상업화 시험이 가로막고 있다.
대량 호출이 가능하다는 것은 한 가지 관문이고, 복잡한 작업을 안정적으로 수행하고 고객이 지속적으로 비용을 지불하게 하는 것은 다음 관문이다.
하비와 씽킹 머신의 사례는 한 가지 길을 제시한다------ 저렴함에 의존하지 않고, 다른 사람의 선생님이 되고, 다른 사람의 기반이 되는 것; 마이크로소프트와 AWS의 수익 분배 모델은 또 다른 길을 제시한다------ 클라우드 거대 기업과 협력하여 한 번 호출하고, 한 번 수익을 나누는 것이다.
주가 vs 청구서. 월스트리트와 기업 간의 대비는 사실 그렇게 모순되지 않는다.
주가는 기대치를 계산하고, 청구서는 현실을 기록한다. 하루에 2.8조가 증발하는 것은 기대치가 조정되는 것이고, 1년 동안 5.4배 상승하는 것은 현실이 가속화되는 것이다. 두 가지 모두 동시에 진실일 수 있다.
하지만 더 멀리 보면, 이 보고서가 드러내는 것은 단순한 경기 주기가 아닐지도 모른다------ 오히려 산업 권력의 재분배일 수 있다.
3년 전, AI는 실험실의 장난감이었다; 3년 후, 기업은 AI를 사용하여 연간 1,770억 달러를 지출하고 있으며, 이 돈은 전체 공공 클라우드 수익의 3분의 1에 해당한다.
일하는 주체도 바뀌었다, 80%의 토큰은 에이전트가 스스로 소모한 것이다.
누구의 모델이 뛰어난지, 누가 모델을 훈련시키는지, 누가 모델을 실행하는지, 전체 체인에서의 분업이 중국의 오픈소스 힘에 의해 다시 쓰이고 있다.
 위험 경고 위험 경고