








Google Gemini Decision 1 phát hành: không tạo ra từng chữ một, một lần yêu cầu đánh giá 1000 câu hỏi
 Quan điểm cốt lõi

 Google đã phát hành mô hình quyết định đầu tiên Gemini Decision 1: không tạo ra từng từ một, chỉ cần một lần truyền tiến có thể chấm điểm cho tối đa 1000 câu hỏi, độ trễ đầu cuối từ 150 đến 250 mili giây, chỉ 0.10 USD cho mỗi triệu Token đầu vào; 9 bài kiểm tra chuẩn đã giành được 7 vị trí đầu tiên, độ chính xác cao nhất là 92.2%.
Tác giả|Đông Mai(AI Tiên Phong)
Khi toàn bộ ngành AI vẫn đang cạnh tranh xem ai có thể tạo ra nhiều Token hơn, ai có khả năng suy luận mạnh hơn, thì Google đã cho ra mắt một mô hình mới không dựa vào việc tạo ra câu trả lời từng từ một.
Vừa mới đây, Google đã chính thức phát hành Gemini Decision 1, đồng thời ra mắt Gemini Decisions API được điều khiển bởi mô hình này. Khác với các mô hình lớn truyền thống, mô hình này được thiết kế đặc biệt để đưa ra quyết định nhanh chóng, không cần phải tạo ra văn bản từng Token một, mà thay vào đó, nó đánh giá các câu trả lời ứng viên đã được thiết lập trước thông qua một lần truyền tiến.
CEO của Google, Sundar Pichai, cũng đã đăng bài trên nền tảng X để giới thiệu khả năng chính của Gemini Decision 1. Ông viết:
Hôm nay, chúng tôi chính thức ra mắt Gemini Decisions API trong Google AI Studio, được hỗ trợ bởi mô hình Gemini Decision 1 hoàn toàn mới.
Khác với các mô hình truyền thống tạo ra văn bản từng Token một, mô hình này được thiết kế đặc biệt cho các nhiệm vụ quyết định trong tập tùy chọn đóng. Nó có thể đánh giá tối đa 1000 câu hỏi trong văn bản, hình ảnh, âm thanh, video và PDF trong một lần xử lý.
Dưới đây là một số chi tiết đáng chú ý:
· Hỗ trợ ba loại quyết định: phán đoán Có/Không, lựa chọn nhiều (tối đa 255 tùy chọn), và đánh giá dựa trên tiêu chí;
· Giá chỉ 0.10 đô la cho mỗi triệu Token đầu vào, phí Token đầu ra là miễn phí, chi phí khoảng một phần năm so với Flash-Lite;
· Vị trí dẫn đầu trong nhiều bài kiểm tra chuẩn, đồng thời có sai số hiệu chỉnh thấp nhất.
Nhóm nội bộ của Google đã bắt đầu sử dụng công nghệ này.
Trước đây, khi các nhà phát triển muốn AI xác định xem một email có phải là thư rác hay không, hoặc quyết định nhiệm vụ nào nên giao cho Agent nào, thường phải gọi đến mô hình lớn sinh tạo, rồi trích xuất kết quả từ văn bản được tạo ra bởi mô hình. Gemini Decision 1 đã loại bỏ bước giải mã từng từ.
Các nhà phát triển chỉ cần cung cấp nội dung đầu vào, câu hỏi cần phán đoán và các tùy chọn ứng viên, mô hình có thể trả về ngay kết quả phán đoán, xác suất và độ tin cậy tương ứng.
Điều này có nghĩa là, đối với các nhiệm vụ chỉ cần một phân loại, đánh giá hoặc kết quả lựa chọn, AI không cần phải hoàn thành toàn bộ quy trình tạo văn bản.
Theo dữ liệu được công bố bởi Google, Gemini Decision 1 có thể xử lý tối đa 1000 câu hỏi độc lập trong một yêu cầu, hỗ trợ đầu vào đa phương thức như văn bản, hình ảnh, âm thanh, video và PDF, với độ trễ đầu cuối chỉ từ 150 đến 250 mili giây.
Giá cũng khá quyết liệt: chỉ 0.10 đô la cho mỗi triệu Token đầu vào, không tính phí cho Token đầu ra. Trong cùng một bộ bài kiểm tra chuẩn mà Google công bố, chi phí gọi của nó thấp hơn gần 5 lần so với Gemini 3.5 Flash-Lite.
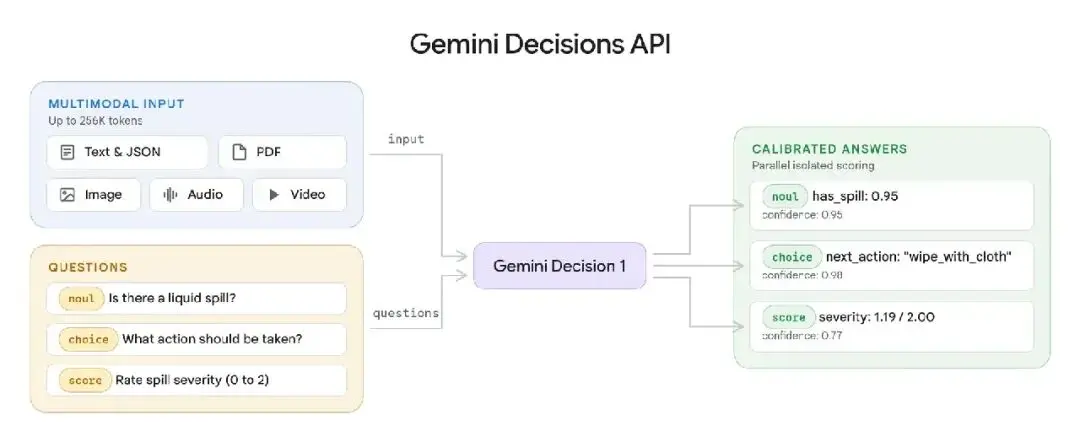
Điều đáng chú ý hơn nữa là, đây không chỉ là một mô hình dùng để trả lời câu hỏi lựa chọn. Google đã sử dụng nó cho định tuyến mô hình AI, lựa chọn công cụ Agent, thiết kế sản phẩm và kiểm tra an toàn, cố gắng biến nó thành một thành phần cơ sở chuyên trách về phán đoán và quyết định trong hệ thống AI.
Xử lý 1000 câu hỏi, tối đa 255 tùy chọn
Theo giới thiệu công nghệ được Google công bố, Gemini Decision 1 cung cấp ba loại khả năng quyết định cốt lõi.
Loại đầu tiên là Có/Không (phán đoán nhị phân). Ví dụ, xác định xem có nguy cơ an toàn nào trong hình ảnh hay không, hoặc một đoạn văn có vi phạm quy tắc đã định hay không. Mô hình sẽ đưa ra xác suất cho các điều kiện tương ứng.
Loại thứ hai là Lựa chọn nhiều (Multiple Choice). Các nhà phát triển có thể thiết lập trước từ 2 đến 255 tùy chọn ứng viên, mô hình không chỉ chọn ra câu trả lời phù hợp nhất mà còn trả về xác suất đã được chuẩn hóa cho mỗi tùy chọn.
Loại thứ ba là Đánh giá theo tiêu chí có thứ tự (Ordered Rubric). Các nhà phát triển có thể tự định nghĩa các tiêu chí đánh giá ở các cấp độ khác nhau, cho phép mô hình đánh giá nội dung đầu vào và trả về điểm số liên tục có trọng số cùng với xác suất của từng cấp độ.
Ba loại nhiệm vụ này cũng có thể được thực hiện kết hợp trong một yêu cầu.
Google đã cung cấp một ví dụ đơn giản: tải lên một bức ảnh về mặt bàn trong phòng trà của văn phòng và kèm theo một đoạn mô tả văn bản, yêu cầu nó đồng thời xác định xem có sự rò rỉ chất lỏng trên bàn hay không, nên thực hiện biện pháp dọn dẹp nào, và mức độ nghiêm trọng của tình huống.
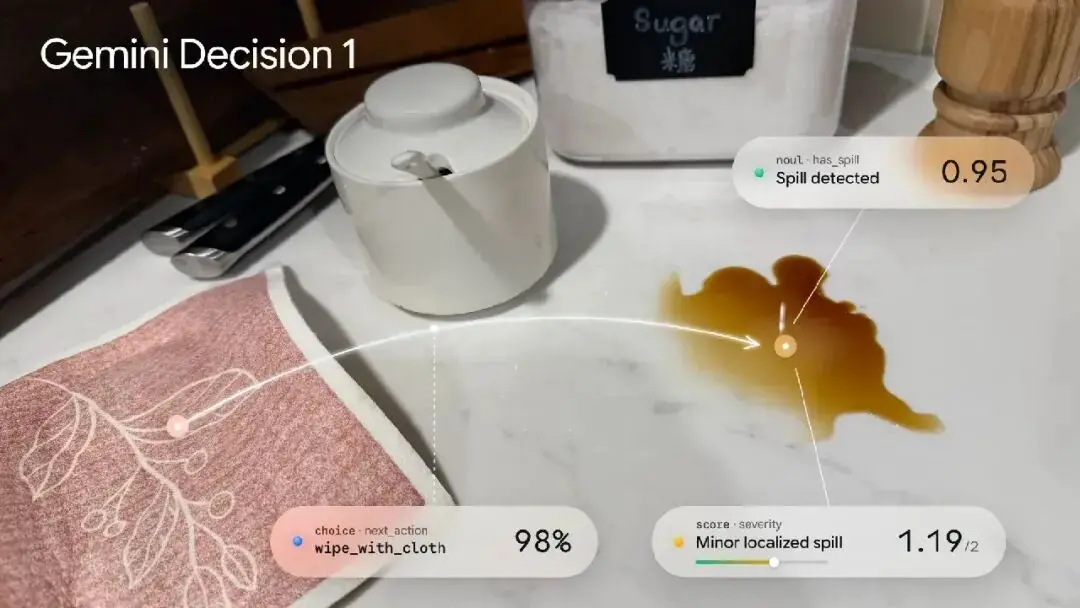
Cách truyền thống có thể cần thiết kế nhiều bộ phân loại, hoặc thực hiện các nhiệm vụ khác nhau thông qua mô hình lớn sinh tạo. Gemini Decision 1 có thể hoàn thành tất cả các phán đoán này trong một yêu cầu.
Ngoài ra, mô hình hỗ trợ ngữ cảnh đầu vào đa phương thức lên đến 256K Token. Đối với các tình huống doanh nghiệp, điều này có nghĩa là các nhà phát triển có thể phân tích cùng lúc bản ghi cuộc gọi và hồ sơ khách hàng, hoặc kết hợp tài liệu yêu cầu bảo hiểm với hình ảnh hiện trường để đưa ra quyết định.
Mỗi quyết định sẽ cung cấp độ tin cậy từ 0 đến 1, giúp hệ thống chuyển giao các kết quả không chắc chắn cho các mô hình khác hoặc kiểm tra thủ công.
Một lợi thế khác của Gemini Decision 1 là tốc độ và chi phí.
Theo thông tin chính thức từ Google, trong các bài kiểm tra chuẩn bao gồm định tuyến Agent, suy luận, phân loại và hiểu biết đa phương thức, Gemini Decision 1 thể hiện vị trí dẫn đầu và đạt được sai số hiệu chỉnh thấp nhất.
Trong ngữ cảnh thử nghiệm không vượt quá 16K Token, độ trễ trung vị trong giai đoạn tính toán của mô hình duy trì ở mức 50 đến 100 mili giây, độ trễ đầu cuối khoảng 150 đến 250 mili giây. Ngay cả khi số lượng câu hỏi trong một yêu cầu tăng từ 1 lên 100, độ trễ vẫn giữ ổn định.
Trên bộ bài kiểm tra chuẩn chung mà chính thức sử dụng, chi phí của Gemini Decisions API thấp hơn gần 5 lần so với việc gọi Gemini 3.5 Flash-Lite thông qua Interactions API.
9 bài kiểm tra đạt 7 vị trí đầu, độ chính xác cao nhất 92.2%
Google lần này phát hành Gemini Decision 1, cũng công bố một bảng điểm so sánh mô hình rất đáng chú ý.
Khác với việc so sánh các mô hình lớn chung, Google lần này đã chọn ba sản phẩm cạnh tranh: GPT-6 Luna của OpenAI, TypeSafe Jev 1.14 chuyên về quyết định phân loại, và Gemini 3.5 Flash-Lite của chính họ.
Theo kết quả, Gemini Decision 1 đã đạt 7 vị trí đầu trong 9 bài kiểm tra chuẩn, cũng dẫn đầu về hiệu chỉnh xác suất, nhưng trong hai bài kiểm tra khác và tổng chi phí gọi, vẫn có đối thủ thể hiện tốt hơn.
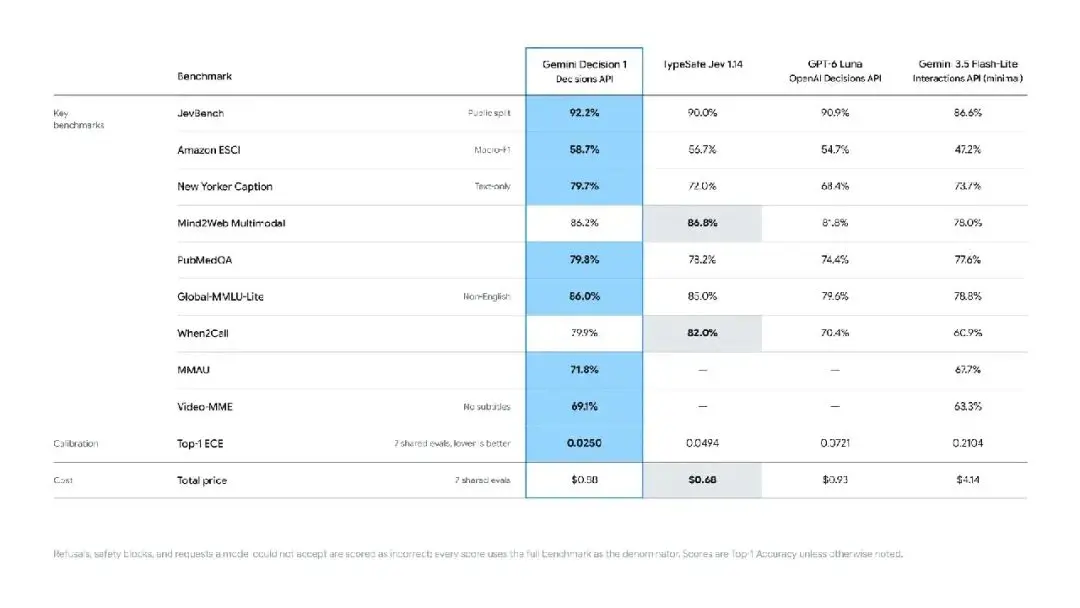
Trong bài kiểm tra JevBench, Gemini Decision 1 đạt độ chính xác 92.2%, vượt qua GPT-6 Luna với 90.9%, TypeSafe Jev 1.14 với 90.0%, và Gemini 3.5 Flash-Lite với 86.6%.
Trong bài kiểm tra liên quan đến độ liên quan tìm kiếm sản phẩm Amazon ESCI, Gemini Decision 1 đạt điểm Macro-F1 58.7%, cao hơn 4 điểm phần trăm so với GPT-6 Luna, và cao hơn 11.5 điểm phần trăm so với Flash-Lite.
Còn trong bài kiểm tra New Yorker Caption, khoảng cách càng được kéo dài. Gemini Decision 1 đạt 79.7%, trong khi GPT-6 Luna là 68.4%, chênh lệch 11.3 điểm phần trăm. Bài kiểm tra này liên quan đến việc hiểu và chọn chú thích cho tranh biếm họa, thử thách khả năng hiểu ngữ cảnh và phán đoán nội dung ứng viên của mô hình.
Trong bài kiểm tra câu hỏi y tế PubMedQA, Gemini Decision 1 cũng đứng đầu, với điểm số 79.8%, cao hơn 74.4% của GPT-6 Luna.
Kết quả bài kiểm tra đa ngôn ngữ Global-MMLU-Lite cũng tương tự. Gemini Decision 1 đạt 86.0%, trong khi GPT-6 Luna là 79.6%, chênh lệch 6.4 điểm phần trăm.
Tuy nhiên, Google chưa đạt được vị trí dẫn đầu toàn diện.
Trong bài kiểm tra Mind2Web Multimodal, TypeSafe Jev 1.14 đứng đầu với 86.8%, Gemini Decision 1 đạt 86.2%, kém 0.6 điểm phần trăm.
Trong bài kiểm tra When2Call, kiểm tra khả năng phán đoán khi gọi công cụ, TypeSafe Jev 1.14 thể hiện ưu thế rõ ràng hơn, với điểm số 82.0%, trong khi Gemini Decision 1 đạt 79.9%.
Kết quả này đặc biệt đáng chú ý. Lựa chọn công cụ và phán đoán thời điểm gọi là một trong những tình huống ứng dụng chính mà Gemini Decision 1 hướng tới, nhưng trong bài kiểm tra này, mô hình quyết định chuyên dụng TypeSafe Jev vẫn giữ vị trí dẫn đầu.
Ngoài ra, trong bài kiểm tra hiểu âm thanh MMAU và bài kiểm tra hiểu video Video-MME, Gemini Decision 1 lần lượt đạt 71.8% và 69.1%, đều cao hơn Flash-Lite.
Điều đáng chú ý hơn cả là khả năng hiệu chỉnh xác suất mà Google đặc biệt nhấn mạnh lần này.
Trong bài kiểm tra Top-1 ECE (Expected Calibration Error, sai số hiệu chỉnh dự kiến), sai số hiệu chỉnh của Gemini Decision 1 chỉ là 0.0250, trong khi GPT-6 Luna là 0.0721, TypeSafe Jev 1.14 là 0.0494, và Flash-Lite đạt 0.2104.
Nói cách khác, trong nhóm đánh giá này, sai số hiệu chỉnh của Gemini Decision 1 thấp hơn khoảng 65% so với GPT-6 Luna và thấp hơn khoảng 88% so với Flash-Lite.
Chỉ số này đặc biệt quan trọng đối với hệ thống Agent.
Ví dụ, khi một Agent cần xác định xem một đoạn mã có tồn tại lỗ hổng bảo mật hay không, mô hình đưa ra không chỉ là kết quả "có" hoặc "không", mà còn có thể bao gồm một giá trị xác suất. Hệ thống có thể dựa vào mối quan hệ giữa xác suất và tỷ lệ chính xác thực tế để quyết định có nên tự động hành động hay không, hoặc giao cho con người kiểm tra thêm.
Google đã áp dụng: Độ trễ định tuyến Agent giảm tối đa 40%
Khác với một số mô hình mới chỉ hiển thị điểm chuẩn, Google lần này còn tiết lộ các trường hợp ứng dụng của Gemini Decisions API trong các sản phẩm nội bộ.
Trong số đó, Gemini Notebook là điểm đáng chú ý nhất.
Google đang tận dụng Decisions API để đóng vai trò là bộ định tuyến mô hình thời gian thực, chọn mức độ mô hình và cường độ suy nghĩ phù hợp dựa trên độ phức tạp của yêu cầu người dùng. Đối mặt với các vấn đề đơn giản hàng ngày, hệ thống có thể ưu tiên gọi mô hình có chi phí thấp hơn và phản hồi nhanh hơn; khi gặp các nhiệm vụ suy luận phức tạp, yêu cầu sẽ được chuyển cho mô hình mạnh hơn.
Google cho biết, nhờ vào cách định tuyến động này, độ trễ của các truy vấn hàng ngày có thể giảm tối đa 40%.
Thiết kế này liên quan chặt chẽ đến xu hướng phát triển hiện tại của hệ thống Agent. Khi một Agent hoàn thành nhiệm vụ, thường cần liên tục đánh giá hành động tiếp theo, chẳng hạn như chọn công cụ nào, gọi mô hình nào, hoặc quyết định có cần can thiệp của con người hay không.
Nếu mỗi quyết định đơn giản đều phải giao cho mô hình sinh lớn xử lý, hệ thống sẽ phải chịu thêm độ trễ và chi phí. Mô hình quyết định chuyên biệt cung cấp một lựa chọn khác: giao các phán đoán tương đối đơn giản, có lựa chọn rõ ràng cho mô hình độ trễ thấp xử lý, để lại các nhiệm vụ phức tạp cho mô hình lớn chung.
Ngoài Gemini Notebook, Google còn tiết lộ ba hướng ứng dụng khác.
Trong Google Stitch, tính năng thử nghiệm Rapid Canvas mới ra mắt sử dụng Decisions API để tạo ra các khung sản phẩm tương tác trong vài giây và phản hồi nhanh chóng các chỉ thị chỉnh sửa từ người dùng thông qua giọng nói hoặc nhấp chuột. Sau khi người dùng xác nhận hướng thiết kế, có thể chuyển trang vào quy trình làm việc Stitch hoàn chỉnh để hoàn thiện hơn.
Trong sản phẩm CC của Google Labs, Decisions API được sử dụng để nhanh chóng chọn phản ứng biểu cảm phù hợp từ hơn 200 tùy chọn Emoji. Trong Google Search, Google cũng đã sử dụng API này để xây dựng lớp kiểm tra an toàn cho công cụ MCP, nhận diện các hành vi và nội dung có khả năng gây hại.
Tham khảo liên kết: Blog chính thức của Gemini Decisions API
 Cảnh báo rủi ro Cảnh báo rủi ro

Bài viết nổi bật





