








Гугл Gemini Decision 1 выпущен: не генерирует текст слово в слово, за один запрос оценивает 1000 вопросов
 Ключевые тезисы

 Google выпустила первую модель принятия решений Gemini Decision 1: не генерирует текст построчно, однократная прямая передача может оценивать до 1000 вопросов, задержка от конца до конца составляет 150~250 миллисекунд, всего 0.10 долларов за миллион входных токенов; 9 тестов, из которых 7 заняли первое место, максимальная точность 92.2%.
Автор|Дунмэй(AI Фронт)
Когда вся индустрия ИИ еще соревнуется в том, кто сможет сгенерировать больше токенов и чьи способности к рассуждению сильнее, Google представила новую модель, которая не полагается на пословное генерирование ответов.
Только что Google официально представила Gemini Decision 1 и одновременно запустила Gemini Decisions API, основанный на этой модели. В отличие от традиционных генеративных больших моделей, эта модель специально предназначена для быстрого принятия решений, не требуя пословного генерирования текста, а оценивая заранее заданные кандидатные ответы с помощью одного прямого распространения.
Генеральный директор Google Сундар Пичаи также опубликовал пост на платформе X, в котором представил основные возможности Gemini Decision 1. Он написал:
Сегодня мы официально запускаем Gemini Decisions API в Google AI Studio, поддерживаемый совершенно новой моделью Gemini Decision 1.
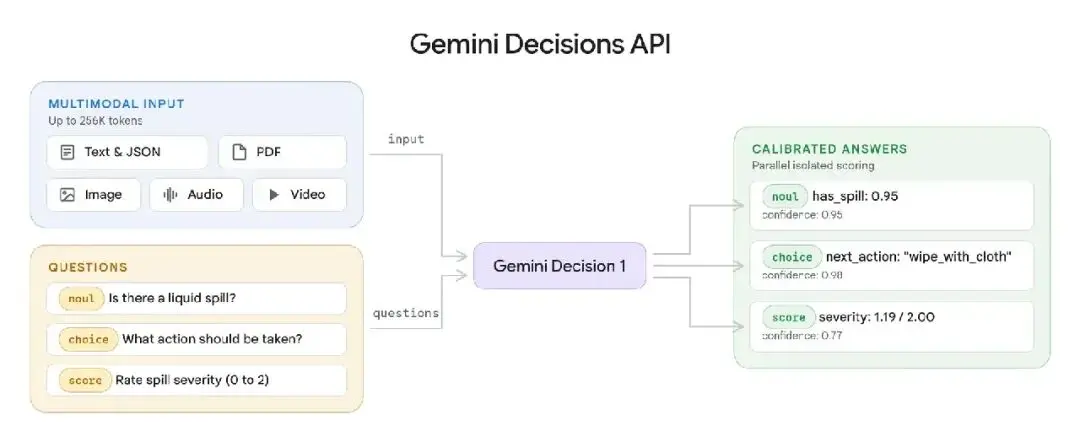
В отличие от традиционных моделей, которые генерируют текст по токенам, эта модель специально разработана для задач принятия решений в закрытых наборах вариантов. Она может оценивать до 1000 вопросов в одном процессе обработки, включая текст, изображения, аудио, видео и PDF.
Вот несколько деталей, на которые стоит обратить внимание:
· Поддерживает три типа решений: да/нет, множественный выбор (до 255 вариантов) и оценка на основе критериев;
· Цена составляет всего 0,10 доллара за миллион входных токенов, стоимость выходных токенов равна нулю, что примерно в пять раз меньше стоимости Flash-Lite;
· Лидирует в нескольких бенчмарках с наименьшей ошибкой калибровки.
Внутренние команды Google уже начали использовать эту технологию.
Ранее, когда разработчики хотели, чтобы ИИ определил, является ли электронное письмо спамом, или решили, какому агенту поручить задачу, им часто приходилось вызывать генеративную большую модель и извлекать результаты из текста, сгенерированного моделью. Gemini Decision 1 устраняет этап пословного декодирования.
Разработчикам нужно просто предоставить входные данные, вопрос для оценки и кандидатные варианты, и модель может сразу вернуть соответствующий результат, вероятность и уровень доверия.
Это означает, что для задач, которые изначально требуют лишь классификации, оценки или выбора результата, ИИ больше не нужно проходить весь процесс генерации текста.
Согласно данным, опубликованным Google, Gemini Decision 1 может обрабатывать до 1000 независимых вопросов за один запрос, поддерживая мультимодальные входные данные, такие как текст, изображения, аудио, видео и PDF, с задержкой от конца до конца всего 150–250 миллисекунд.
Цены также довольно агрессивные: всего 0,10 доллара за миллион входных токенов, выходные токены не облагаются платой. В той же группе бенчмарков, опубликованных Google, стоимость вызова составляет почти в 5 раз меньше, чем у Gemini 3.5 Flash-Lite.
Что еще более важно, это не просто модель для ответов на вопросы с выбором. Google уже использует ее для маршрутизации моделей ИИ, выбора инструментов для агентов, проектирования продуктов и проверки безопасности, стремясь сделать ее основным компонентом, ответственным за оценку и принятие решений в системах ИИ.
Обработка 1000 вопросов, до 255 вариантов
Согласно техническому описанию, опубликованному Google, Gemini Decision 1 предлагает три основных типа возможностей принятия решений.
Первый тип — это да/нет (двоичное суждение). Например, определить, существует ли угроза безопасности на изображении, или нарушает ли текст установленные правила. Модель предоставит вероятность выполнения соответствующих условий.
Второй тип — множественный выбор. Разработчики могут заранее задать от 2 до 255 кандидатных вариантов, и модель не только выберет наиболее подходящий ответ, но и вернет вероятность каждого кандидатного варианта после нормализации.
Третий тип — упорядоченная оценка. Разработчики могут самостоятельно определить различные уровни критериев оценки, позволяя модели оценивать входные данные и возвращать непрерывные взвешенные баллы и вероятности для каждого уровня.
Эти три задачи также могут быть выполнены в одном запросе.
Google предоставила простой пример: загрузить в модель фотографию стола в офисной кухне и приложить текстовое описание, требуя одновременно определить, есть ли на столе разлитая жидкость, какие меры очистки следует предпринять и насколько серьезна ситуация.
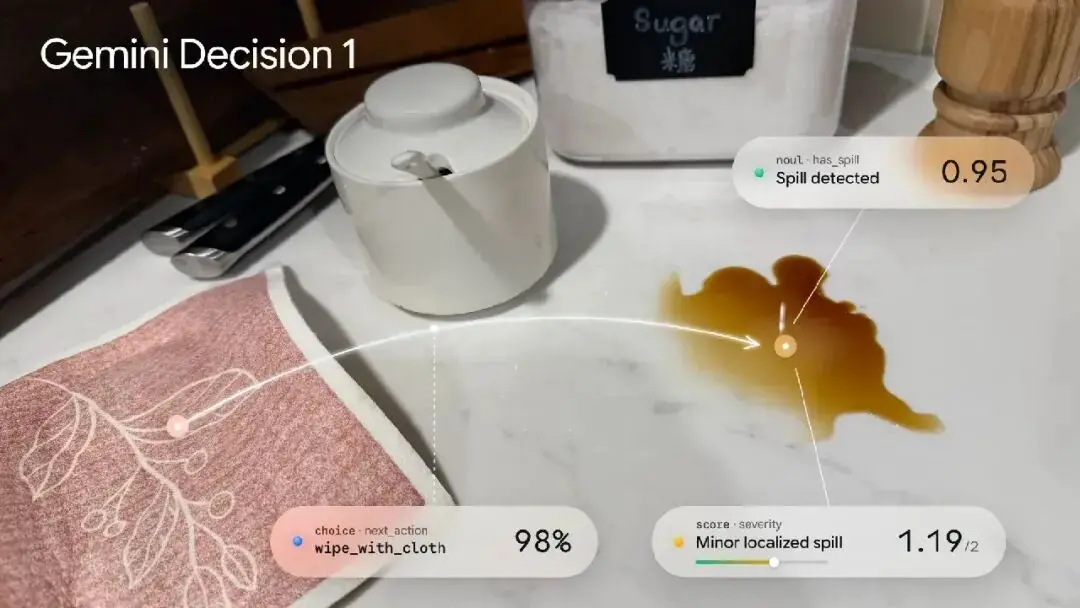
Традиционный подход может потребовать разработки нескольких классификаторов или выполнения различных задач с помощью генеративной большой модели. Gemini Decision 1 может выполнить все эти оценки за один запрос.
Кроме того, модель поддерживает мультимодальные входные контексты до 256K токенов. Для корпоративных сценариев это означает, что разработчики могут анализировать записи разговоров вместе с данными клиентов или принимать решения, комбинируя документы страховых претензий с фотографиями места происшествия.
Каждое решение будет предоставлять уровень доверия от 0 до 1, что упрощает передачу неопределенных результатов другим моделям или на ручную проверку.
Еще одним конкурентным преимуществом Gemini Decision 1 является скорость и стоимость.
Согласно официальной информации Google, в бенчмарках, охватывающих маршрутизацию агентов, рассуждения, сортировку и мультимодальное понимание, Gemini Decision 1 показывает лидирующие позиции и достигает наименьшей ошибки калибровки.
В тестовом контексте, не превышающем 16K токенов, медианная задержка на этапе вычислений модели составляет 50–100 миллисекунд, а задержка от конца до конца составляет около 150–250 миллисекунд. Даже если количество вопросов в одном запросе увеличивается с 1 до 100, задержка остается относительно стабильной.
На общих бенчмарках, используемых официально, стоимость Gemini Decisions API почти в 5 раз ниже, чем при вызове Gemini 3.5 Flash-Lite через Interactions API.
9 тестов, 7 первых мест, точность 92.2%
В этом выпуске Google представила Gemini Decision 1 и опубликовала довольно интересный отчет о сравнении моделей.
В отличие от обычного сравнения с универсальными большими моделями, Google выбрала три конкурентных продукта: GPT-6 Luna от OpenAI, TypeSafe Jev 1.14, специально предназначенный для классификационных решений, и собственный Gemini 3.5 Flash-Lite.
Согласно результатам, Gemini Decision 1 заняла 7 первых мест из 9 в бенчмарках, также лидируя по калибровке вероятностей, но в двух других тестах и по общей стоимости вызова все еще есть конкуренты с лучшими показателями.
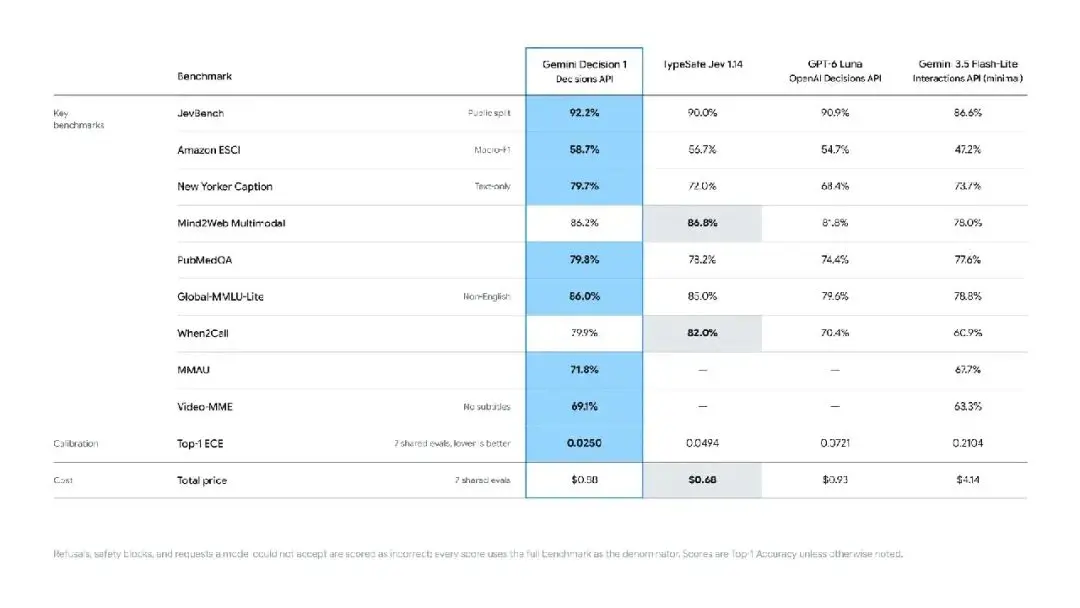
В тесте JevBench Gemini Decision 1 достигла 92.2% точности, превысив 90.9% у GPT-6 Luna, 90.0% у TypeSafe Jev 1.14 и 86.6% у Gemini 3.5 Flash-Lite.
В тесте на релевантность поиска товаров Amazon ESCI Gemini Decision 1 получила 58.7% по Macro-F1, что на 4 процентных пункта выше, чем у GPT-6 Luna, и на 11.5 процентных пункта выше, чем у Flash-Lite.
В тесте New Yorker Caption разрыв еще больше увеличился. Gemini Decision 1 показала 79.7%, в то время как GPT-6 Luna составила 68.4%, разница составила 11.3 процентных пункта. Этот тест включает в себя понимание и выбор подписей к комиксам, проверяя способности модели к пониманию контекста и оценке кандидатного контента.
В медицинском вопросно-ответном тесте PubMedQA Gemini Decision 1 также заняла первое место с результатом 79.8%, что выше 74.4% у GPT-6 Luna.
Результаты многоязычного теста Global-MMLU-Lite также похожи. Gemini Decision 1 получила 86.0%, в то время как GPT-6 Luna составила 79.6%, разница составила 6.4 процентных пункта.
Тем не менее, Google не достигла полной доминации.
В тесте Mind2Web Multimodal TypeSafe Jev 1.14 заняла первое место с результатом 86.8%, в то время как Gemini Decision 1 составила 86.2%, отставание составило 0.6 процентных пункта.
В тесте When2Call, проверяющем способности к оценке вызовов инструментов, преимущество TypeSafe Jev 1.14 стало еще более очевидным, с результатом 82.0%, в то время как Gemini Decision 1 составила 79.9%.
Этот результат особенно заслуживает внимания. Выбор инструментов и оценка времени вызова — это один из ключевых сценариев применения Gemini Decision 1 для агентов, но в этом тесте специализированная модель принятия решений TypeSafe Jev по-прежнему сохраняет лидерство.
Кроме того, в тестах на понимание аудио MMAU и понимание видео Video-MME Gemini Decision 1 показала 71.8% и 69.1% соответственно, оба результата выше, чем у Flash-Lite.
Более важным, чем точность, является способность калибровки вероятностей, на которую Google особенно акцентировала внимание.
В тесте Top-1 ECE (Expected Calibration Error, ожидаемая ошибка калибровки) ошибка калибровки Gemini Decision 1 составила всего 0.0250, в то время как у GPT-6 Luna она составила 0.0721, у TypeSafe Jev 1.14 — 0.0494, а у Flash-Lite — 0.2104.
Иными словами, в этой группе оценок ошибка калибровки Gemini Decision 1 ниже примерно на 65% по сравнению с GPT-6 Luna и на 88% по сравнению с Flash-Lite.
Этот показатель особенно важен для систем Agent.
Например, когда Agent необходимо определить, существует ли у определенного кода уязвимость, модель предоставляет не только результат "существует" или "не существует", но и вероятность. Система может на основе соотношения вероятности и фактической точности решить, следует ли автоматически предпринять действия или передать задачу на дальнейшую проверку человеку.
Google уже использует: задержка маршрутизации Agent снижена на 40%
В отличие от некоторых новых моделей, которые показывают только результаты бенчмарков, Google также раскрыла примеры применения Gemini Decisions API в своих внутренних продуктах.
Наиболее примечательным является Gemini Notebook.
Google использует Decisions API в качестве маршрутизатора моделей в реальном времени, выбирая подходящий уровень модели и интенсивность мышления в зависимости от сложности запроса пользователя. При решении простых повседневных задач система может в первую очередь использовать модели с низкими затратами и более быстрым откликом; при столкновении со сложными задачами она передает запрос более мощной модели.
Google утверждает, что благодаря такому динамическому маршрутизированию задержка при повседневных запросах может быть снижена на 40%.
Этот дизайн тесно связан с текущими тенденциями развития систем Agent. Когда Agent выполняет задачу, ему часто необходимо постоянно оценивать следующие действия, например, выбирать инструмент, вызывать модель или решать, требуется ли вмешательство человека.
Если каждое простое решение должно обрабатываться крупной генеративной моделью, системе придется нести дополнительные задержки и затраты. Специальные модели принятия решений предлагают другой вариант: передать относительно простые и четкие решения моделям с низкой задержкой, оставляя сложные задачи для универсальных больших моделей.
Помимо Gemini Notebook, Google также раскрыла еще три направления применения.
В Google Stitch новая экспериментальная функция Rapid Canvas использует Decisions API для создания интерактивных каркасных схем продуктовых процессов за считанные секунды и быстрого реагирования на изменения, которые пользователи вносят голосом или нажатием. После подтверждения направления дизайна пользователи могут перевести страницу в полный рабочий процесс Stitch для дальнейшего совершенствования.
В продукте CC от Google Labs Decisions API используется для быстрого выбора подходящей реакции из более чем 200 вариантов Emoji. Внутри Google Search Google также использует этот API для создания слоя безопасности инструмента MCP, который выявляет потенциальные агрессивные действия и контент.
Ссылка для справки: Официальный блог Gemini Decisions API
 Предупреждение о рисках Предупреждение о рисках

Популярные статьи





