








Сэм Альтман: Установка памяти на ПК слишком расточительна, лучше оставить для AI дата-центров
 Ключевые тезисы


 С точки зрения глобального распределения ресурсов, позволять каждому накапливать дефицитный DRAM в своем компьютере и большую часть времени оставлять его без дела — это довольно плохая организация.
Редактор: Цзэ Нань, Машинное сердце
«С точки зрения глобального распределения ресурсов, позволять каждому хранить дефицитные DRAM в своих компьютерах большую часть времени без дела — это 'весьма ужасное' решение, память должна быть сосредоточена в облачных дата-центрах.»
Слова сказаны.
В этот четверг, во время интервью на YouTube-канале Cheeky Pint, генеральный директор OpenAI Сэм Альтман (Sam Altman) пил пиво и в непринужденной атмосфере обсудил локальную инференцию больших моделей ИИ и связанные с этим проблемы нехватки памяти в домашних компьютерах, невольно произнеся несколько резких слов.
Мы знаем, что текущий глобальный всплеск ИИ вызвал рост цен на память, что уже привело к резкому удорожанию ПК и смартфонов, и обычным потребителям стало трудно это вынести. В то же время, расширение мощностей у крупных производителей памяти займет еще некоторое время. В то время как передовые компании в области ИИ поглощают большую часть памяти, они уже начали обсуждать, используется ли память в персональных компьютерах эффективно.
Альтман упомянул гипотезу о том, что люди смогут запускать локальный искусственный интеллект на своих компьютерах, которые могут быть как уже имеющимися, так и собранными из-за роста технологий больших моделей ИИ. Он считает, что это плохая идея.
«С точки зрения глобального распределения ресурсов, позволять каждому хранить ограниченные DRAM в своих компьютерах, при этом использование составляет всего 5%, на самом деле очень плохо», — сказал Альтман. «Если вы хотите работать в условиях крайне ограниченных ресурсов, то в облаке следует максимально повысить эффективность использования ресурсов. Но почему-то интуиция многих людей совершенно противоположна.»
В настоящее время основной бизнес OpenAI основан на закрытых моделях, работающих в крупных дата-центрах, и его защита своей бизнес-модели вызвала много споров в сообществе ИИ.
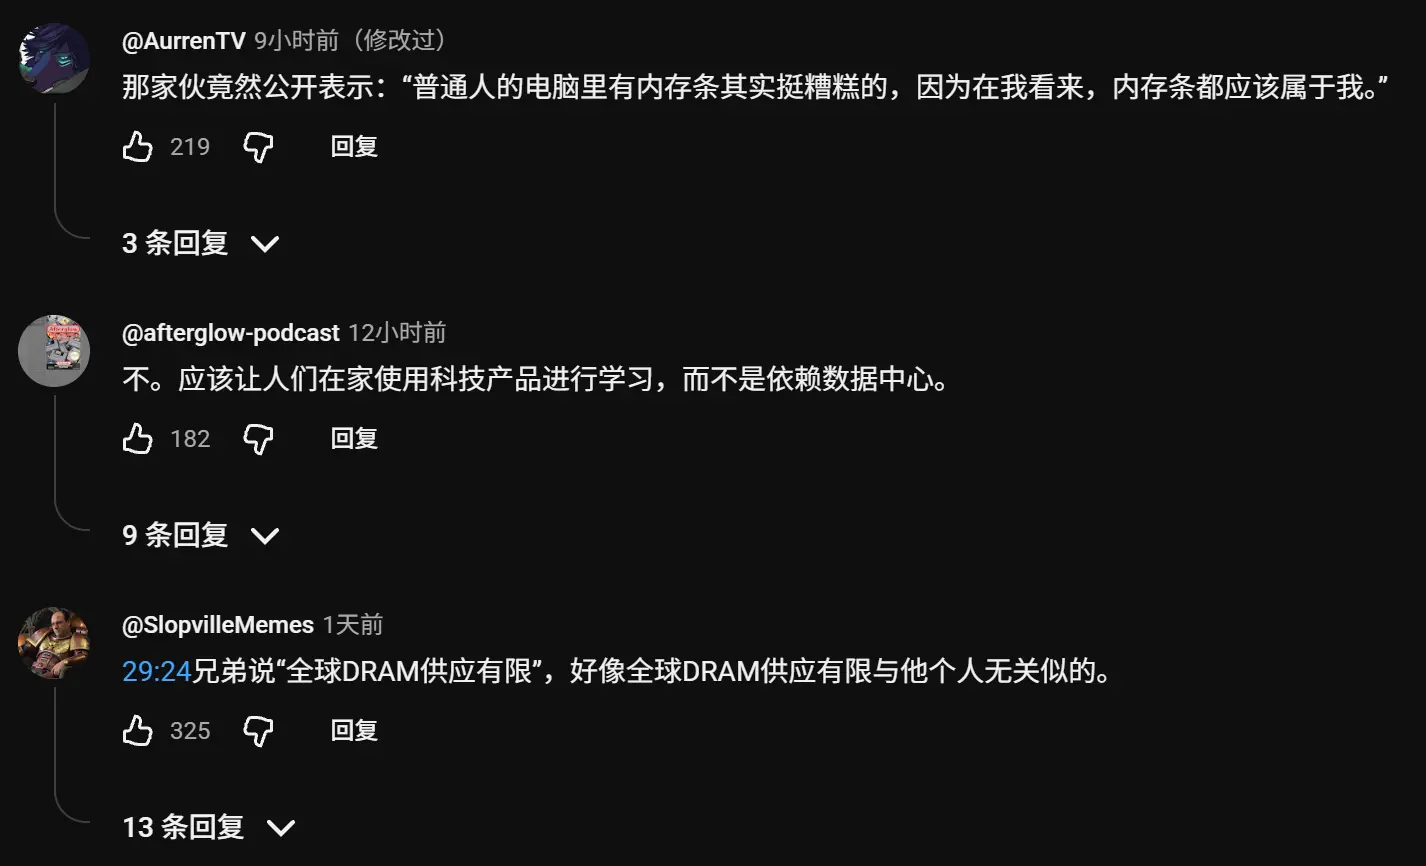
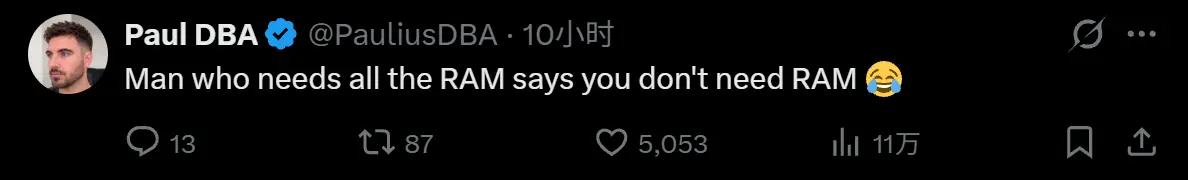
Это также вызвало беспокойство у многих: в будущем нам может быть сложнее иметь собственное оборудование или программное обеспечение, и мы сможем только рассматривать возможность аренды облачных агентов и компьютеров.
Хотя память, используемая обычными ПК, смартфонами и ускорителями ИИ, различна, их производство будет конкурировать за часть мощностей полупроводниковых фабрик. Альтман обсуждает распределение ресурсов глобального DRAM, и когда речь идет о том, кто имеет право решать, куда направить мощности памяти, чаще всего это тот пользователь, который делает более крупные заказы.
Некоторые из взглядов Альтмана основаны на предположении, что строительство дата-центров не замедлится. Кроме того, он предполагает, что память, используемая круглосуточно для дата-центров ИИ, более ценна, чем память, используемая для электронных таблиц, веб-серфинга, игр и даже иногда для локального ИИ.
На самом деле это интервью было длинным, Альтман также обсудил уязвимость PHP, которая вызвала глобальную панику за последние две недели, песочницу для обучения моделей и исследования ИИ в области математики.
Посмотрим, о чем он говорил:
ИИ вызывает волну уязвимостей
Что касается огромной уязвимости PHP, Альтман считает: способность больших моделей находить уязвимости быстро растет, а объем кода в интернете колоссален, и когда люди начинают систематически использовать ИИ для сканирования всего кода, «мы обнаружим, что находимся в мире, где серьезные уязвимости превышают ожидания». Он считает, что просто исправлять уязвимости недостаточно, необходимо перестраивать архитектуру, маршрутизаторы, операционные системы и прикладной уровень нужно заново проектировать для мира, где «уязвимости будут становиться все более умными». Два года назад «переписывать весь технологический стек» казалось безумной идеей, сейчас появились стартапы, которые хотят создать совершенно новый стек.
Он редко делал самокритику в отрасли: «Я не думаю, что мы хорошо объяснили людям, почему все потенциальные риски этой технологии оправданы». Он сказал, что нарратив в индустрии ИИ — это плохая продажа, обещая излечить рак и снизить затраты, одновременно рисуя будущее с безработицей, потерей контроля и необходимостью жесткого регулирования. Он повторил, что OpenAI настаивает на итеративном развертывании и способности к противодействию, потому что нельзя позволить «людям из нескольких квадратных миль Сан-Франциско принимать все решения».
Когда его спросили, можно ли создать «тюрьму с высшим уровнем безопасности» для модели, Альтман дал пессимистичный ответ: песочница эффективна только в определенной степени, мониторинг (включая проверку цепочки мышления и мониторинг активации) может продвинуться дальше, но в конечном итоге необходимо высокое доверие к выравниванию. Он задал вопрос: «Сможете ли вы действительно доверять этой песочнице, когда модель умнее самого умного специалиста по безопасности на миллион раз и может открывать новые науки, которые человечество еще не понимает?»
Он ясно сказал, что ненавидит термин «агентские рои», потому что «рой» вызывает ассоциации с саранчой, настаивая на том, чтобы называть это «агентскими командами», и считает, что свойства взаимного сдерживания между командами соответствуют механизму, обеспечивающему устойчивость через плюрализм, что является безопасным направлением, которое стоит развивать.
Взрыв интеллекта и цена научных открытий
Альтман нарисовал кривую: в эпоху GPT-4 трудно эффективно вложить 1 доллар в вычислительную мощность на один вопрос; цепочка мышления позволяет моделям «усердно думать», а теперь мы можем параллельно запускать целую команду агентов тысячи раз. Разрыв в использовании между обычными пользователями и самыми продвинутыми пользователями постоянно увеличивается.
Что касается того, как OpenAI распределяет вычислительную мощность, он сказал, что сотрудники имеют большую свободу, но никогда не вознаграждаются за высокое потребление токенов: «Высокий рейтинг токенов на самом деле немного стыдно, это определенно не причина для повышения». Он привел доказательство уравнения Навье-Стокса как пример: одно доказательство стоило около 10 миллионов долларов, в течение недели «все вышло из-под контроля», потому что тогда никто не знал о законах расширения команды агентов. Но он ожидает, что через год с помощью более умных моделей и методов это можно будет сделать за 1/100 стоимости.
Он также редко проявил эмоции: ситуация тогда была просто невероятной, в выходные, когда новый модельный алгоритм был запущен, все бросили самые сложные задачи этой модели, и она смогла решить их одну за другой. Люди изначально не ожидали, что модель сможет это сделать. Все стали свидетелями того, как многие из самых сложных научных задач в карьере были решены этой моделью, и это охватывало несколько различных областей, зрелище было просто потрясающим.
«Были две ночи, когда я почти не спал, потому что был слишком взволнован, не мог уснуть. Многие из результатов, которые мы позже опубликовали, на самом деле были решены в то время.»
Альтман тогда чувствовал невероятное волнение и радость, но также возникло неожиданное чувство печали, тоски и ощущение, что «определенная эпоха заканчивается». Это не только ностальгия, но и эмпатия к человеческим ученым, которые «услышали истину и готовы умереть». Он настаивает на том, что человечество должно получить базовые знания, но индустрия должна предоставить решение для специалистов в этих областях.
Хотя сейчас говорить о суперразуме еще рано, Альтман считает, что триллион небольших сверхчеловеческих существ лучше, чем один ИИ с триллионом IQ:
"Я бы предпочел, чтобы триллион ИИ с немного сверхчеловеческим интеллектом присоединились к обществу, чем один ИИ с триллионом IQ."
«Интуитивно я предпочел бы, чтобы триллион ИИ с немного сверхчеловеческим интеллектом присоединились к обществу, а не один ИИ с триллионом IQ.»
Его аргумент заключается в том, что мощная устойчивость общества возникает из-за большого количества участников, которые взаимно сдерживают и сотрудничают, «мир с одним мозгом» не обладает такой гибкостью. Но он подчеркивает, что это не произойдет автоматически, это должно быть активно продвигаемо.
Рыночное регулирование, в эпоху ИИ это не сработает?
Что касается глобальной нехватки памяти, Альтман рассказал о планах OpenAI: разработка собственных чипов (для повышения производительности на ватт), строительство собственных дата-центров, проекты по робототехнике и более смелая концепция «самовоспроизводящихся дата-центров», где ИИ будет управлять роботами для работы на полупроводниковых фабриках, производства турбин и солнечных панелей, строительства дата-центров. Он заявил: «Это уже в наших руках».
Говоря о том, почему «рынок сам себя не регулирует», он считает, что текущие достижения ужасны, и объясняет логику поведения производителей памяти: эта отрасль долгое время была трудным бизнесом, вкладывая 20 миллиардов долларов в капитальные затраты и зарабатывая 1,9 миллиарда, в истории много раз крупные компании почти разорялись из-за чрезмерного строительства фабрик. В настоящее время каждая компания может зарабатывать около 100 миллиардов долларов свободного денежного потока в год, но болезненные воспоминания делают их крайне осторожными в расширении мощностей. Он делает вывод, что «невидимая рука сейчас не работает».
Он различает два типа возможностей в полупроводниковой промышленности: фотолитография «похоже, что только одна компания на Земле знает, как это делать», но проектирование чипов (документы, отправляемые на фабрики) уже является отличным полем для применения ИИ.
Говоря о реальном уровне рекурсивного самосовершенствования (RSI), Альтман заявил, что сейчас модели могут выполнять задачи типа «найти 5% повышения вычислительной эффективности», но никто не знает, как заставить ИИ обнаруживать новые архитектуры уровня трансформеров, не хватает более умных моделей. Он даже предсказал, что общество может потребовать в течение некоторого времени согласиться ограничить IQ одной модели, «если будущие достижения будут недостаточными, это будет связано с этим решением, а не с возможностью ИИ проводить исследования».
Он выразил свою веру в дефляцию: текущая общая стоимость владения передовой вычислительной мощностью ИИ на 1 ГВт составляет около 70 миллиардов долларов за 5 лет, было бы лучше снизить ее до 20 миллиардов, при этом модели должны ежегодно увеличивать производительность в 10 раз. Путь к этому — сделать энергоресурсы дешевле и сократить «прибыль на каждом этапе от песка до токена».
Что касается беспокойства компаний по поводу бюджета токенов, он считает, что текущая более распространенная проблема заключается в том, что ИИ используется недостаточно, а не слишком много.
Какова цена личных агентов?
Что касается недавно популярных продуктов личных агентов (например, Muse), Альтман считает, что «момент Macintosh еще не наступил». Люди любят эти продукты, но еще не дошли до «невозможно представить жизнь без них», форма победителей будет похожа на текущие продукты, но «это просто будет работать», надежно и способно справляться с более сложными задачами. Игра в кошки-мышки в использовании компьютеров, по его мнению, в конечном итоге будет сводиться к «вы имеете право позволить ИИ управлять вашим компьютером».
Что касается способов коммерциализации агентов, Альтман считает, что компании слишком сильно привязываются к ИИ в своих продуктах и HTML, опасаясь потерять клиентские отношения, но потребители хотят, чтобы ИИ выполнял все в их основном приложении для общения. Он считает, что настоящая защитная стена исходит от бренда, выбора продуктов и сети выполнения, а не от HTML. Он сам признался, что 10 раз из 10 выбирает Amazon Pay, даже если цена выше, и восхваляет сеть выполнения Amazon, одновременно признавая, что платформа сотрудничества внутри ChatGPT еще не достаточно хороша. Он также назвал все веб-формы «фальшивой работой» и сравнил текущее время с эпохой App Store.
Именно поэтому, при разработке ценовой политики, OpenAI чуть не переняла модель ценообразования AWS, основанную на задачах, полностью отказавшись от расчета по токенам, но столкнулась с сильным сопротивлением со стороны клиентов: «Мне нужно знать, за что я плачу», даже если придется платить больше, все равно необходимы токены как понятная единица.
 Предупреждение о рисках
 Предупреждение о рисках
Популярные статьи





