Американские акции за одну ночь потеряли 2.8 триллиона! Топовые венчурные капитальные компании Кремниевой долины раскрыли: 90% расходов на открытые модели направляются в Китай
 Ключевые тезисы


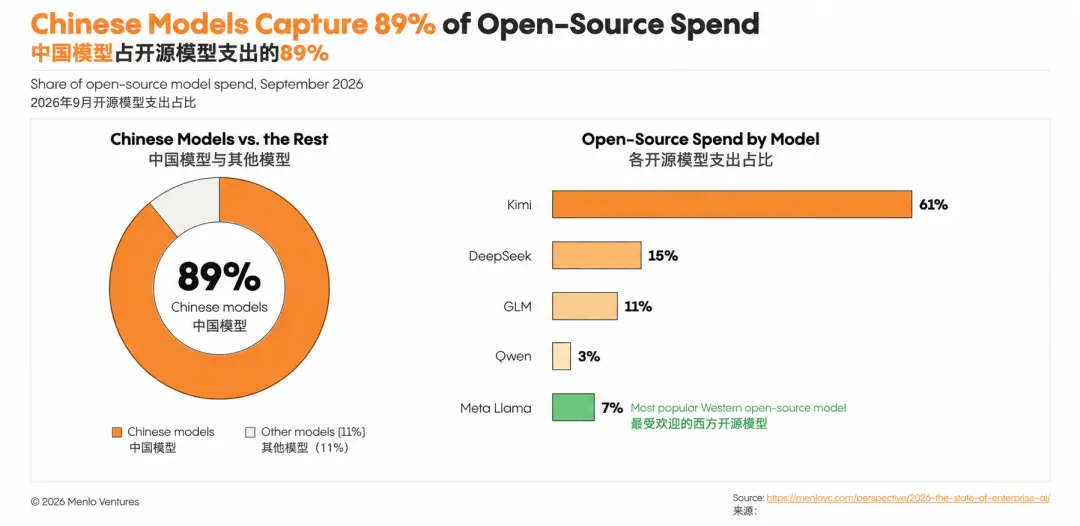
 На фоне того, как американские акции за одну ночь потеряли 2,8 триллиона долларов, данные о расходах, раскрытые венчурными капиталистами Кремниевой долины, заслуживают особого внимания: около 89% расходов на корпоративные открытые модели направляются на китайские модели, из которых Kimi составляет 61%; в то же время деньги стремительно перетекают к более дорогим флагманским моделям.
Источник: Новые технологии
Сегодня рано утром американские фондовые рынки были сильно подорваны.
Индекс Nasdaq упал на 5,52%, что стало самым большим падением за один день с апреля 2025 года, и официально вошел в зону технической коррекции. Индекс полупроводников Филадельфии рухнул на 12,3%, что стало самым худшим днем с момента краха в марте 2020 года.
NVIDIA упала на 9,26%, потеряв почти 450 миллиардов долларов рыночной капитализации за один день; AMD упала на 17%, SanDisk на 22%, Broadcom на 10%.
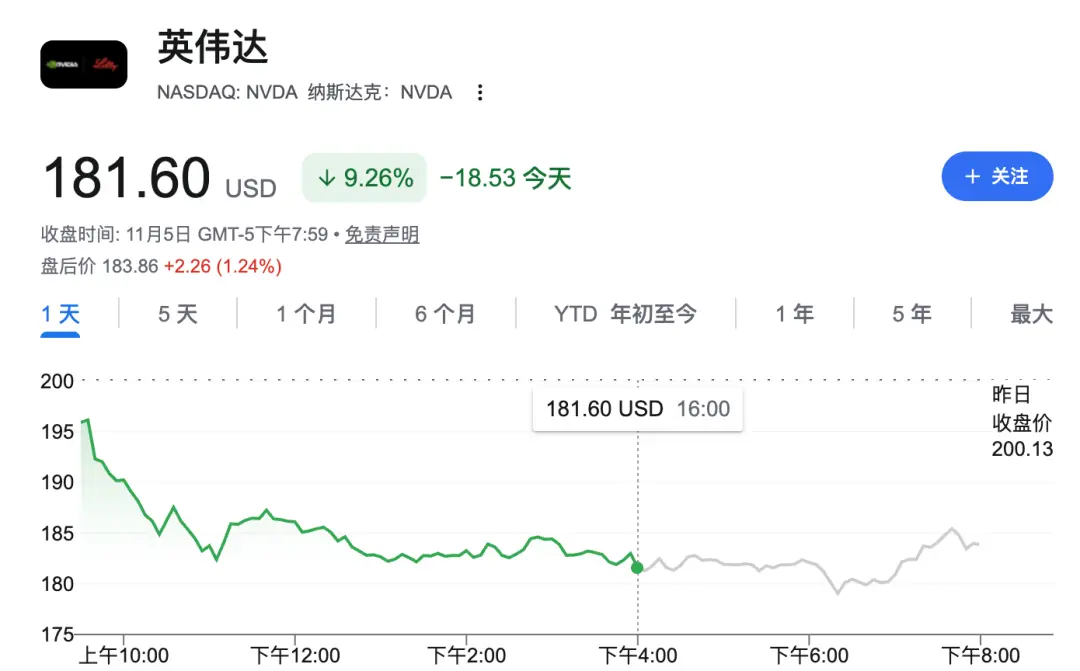
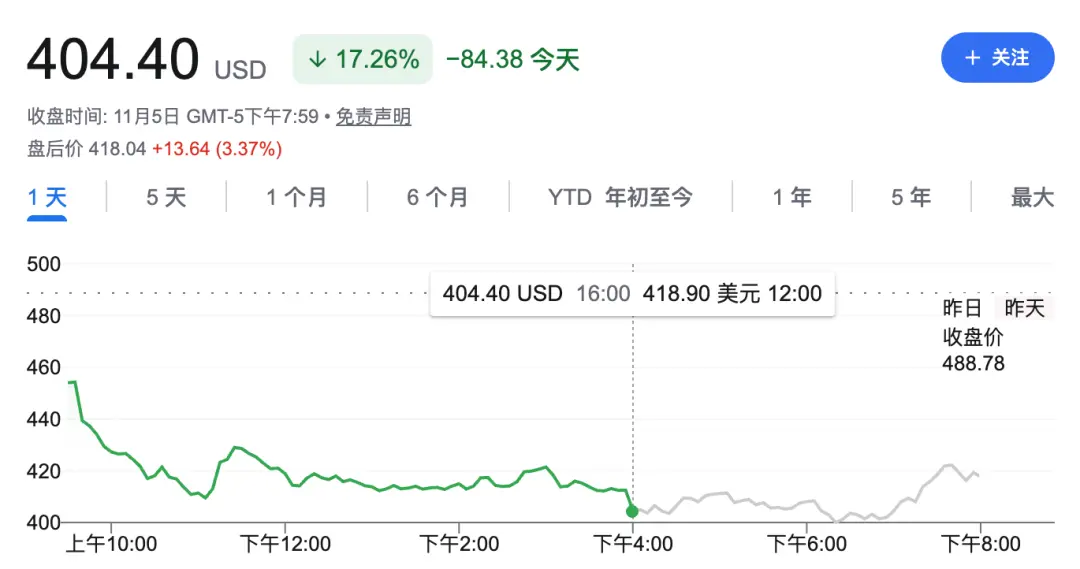
От чипов, серверов, оптических модулей до поставщиков электроэнергии для центров обработки данных, вся цепочка поставок ИИ-инфраструктуры практически не оставила ни одного уголка, который бы не пострадал.
СМИ оценивают, что за один день американские фондовые рынки потеряли около 2,8 триллиона долларов!
Отложив влияние выборов, более глубокий уровень заключается в том, что рынок наконец-то сосредоточил свои сомнения относительно того, «можно ли вернуть вложенные средства» в огромные капитальные расходы на ИИ.
Но всего два дня назад, 3 ноября, венчурная компания Menlo Ventures, которая существует уже 50 лет и является ранним инвестором Anthropic, выпустила «Отчет о состоянии корпоративного ИИ в 2026 году», в котором цифры пошли в совершенно противоположном направлении от фондового рынка:
Расходы на развертывание корпоративного ИИ в 2026 году выросли с 33 миллиардов долларов до 177 миллиардов долларов, увеличившись в 5,4 раза за год. Три года назад этот рынок составлял всего 1,7 миллиарда, за три года он вырос в 100 раз.
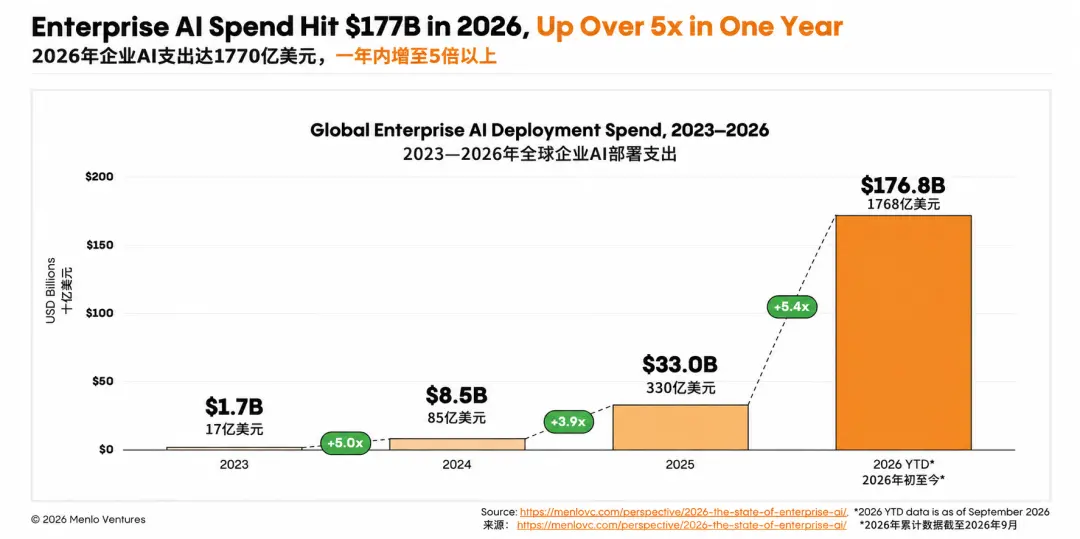
С одной стороны, 2,8 триллиона долларов исчезли, с другой стороны, 177 миллиардов долларов были вложены.
Контраст просто огромен. Уолл-стрит сомневается, сможет ли капиталовложение со стороны предложения вернуть свои средства, в то время как CTO со стороны спроса увеличивают заказы до неуправляемого бюджета.
В этом отчете также скрыты два более интригующих факта:
Китайские модели составляют 89% расходов на корпоративные открытые модели, из которых Kimi занимает 61%; в то же время деньги компаний стремительно направляются к более дорогим флагманским моделям, доля расходов на передовые модели увеличилась с 35% до 63%.
Только совместив эти два факта, мы увидим настоящую картину.
Китайские модели «захватывают» бухгалтерские книги американских компаний
В расходах на корпоративные открытые модели китайская команда занимает подавляющее большинство в первой четверке: Kimi 61%, DeepSeek 15%, GLM 11%, Qwen 3%, в сумме 89%. Модель Meta Llama, наиболее заметный игрок на Западе, получила всего 7%.
Другими словами, когда американские компании используют открытые модели в производственной среде, в девяти случаях из десяти они основаны на китайских разработках.
Но еще более интересно то, что китайские модели уже не просто «дешевые заменители» — они начинают «врастать» в продукты других компаний.
Вчера, 5 ноября, Thinking Machines Lab выпустила новую модель Inkling 2 Small. Эту компанию не нужно представлять: ее основала бывший CTO OpenAI Mira Murati, она привлекла 2 миллиарда долларов на первом раунде, а последняя оценка составила 40 миллиардов долларов, это одна из самых престижных лабораторий в Силиконовой долине.
Сама модель тоже впечатляет: 594 миллиарда параметров, 17 миллиардов активированных MoE, индекс искусственного анализа составил 31 балл.
Но это не главное. Главное скрыто в одном неприметном углу технического блога —
На этапе предобучения данные, которые подаются модели, в основном не собираются из интернета, а генерируются с помощью нескольких более ранних моделей. Первой из них является Kimi K3 от «Темной стороны Луны».
Как это называется? Это называется, что Kimi стала учителем для звездной лаборатории Силиконовой долины.
Чтобы быть учителем, нужно, чтобы твои ответы были желанными для копирования. Год назад эта роль в основном принадлежала только GPT и Claude.
Быть учителем — это лишь один из способов использования. Kimi K3 также служит основой для американских компаний.
В августе этого года юридический ИИ-единорог Harvey, оцененный более чем в 10 миллиардов долларов, где OpenAI также является акционером, выпустил свою первую модель Tenet.
Кто является основой? Не GPT от акционера OpenAI, а Kimi K3.
Harvey использовал всего около 150 графических процессоров NVIDIA B300 и потратил два месяца на дообучение юридических задач на Kimi K3.
В результате Tenet почти удвоил количество выполненных задач по собственному юридическому бенчмарку, и в нескольких сложных юридических задачах он смог соперничать с флагманскими моделями Anthropic, OpenAI и Google.
Thinking Machines, создающие модели, используют ее как учителя, а Harvey, занимающийся приложениями, использует ее как основу. От лаборатории до уровня приложений Kimi проникла повсюду.
Для этих компаний открытые веса означают, что они получили нож, который могут точить сами, а не просто дешевый нож.
Таким образом, китайские модели вошли в производственную цепочку ведущих зарубежных приложений — от вызова до использования в качестве учителя и основы.
И эта тенденция продолжает набирать скорость.
23 октября была выпущена Kimi K3.1 Pro, и по данным «Темной стороны Луны» результаты Terminal-Bench 4.0 составили 65,7%; затем, 5 ноября, она была запущена на Microsoft Foundry —
Это первая открытая модель с весами, использующая модель «разделения доходов» на облаке Microsoft. Проще говоря: каждая активация Kimi на Microsoft Azure приносит доход «Темной стороне Луны».
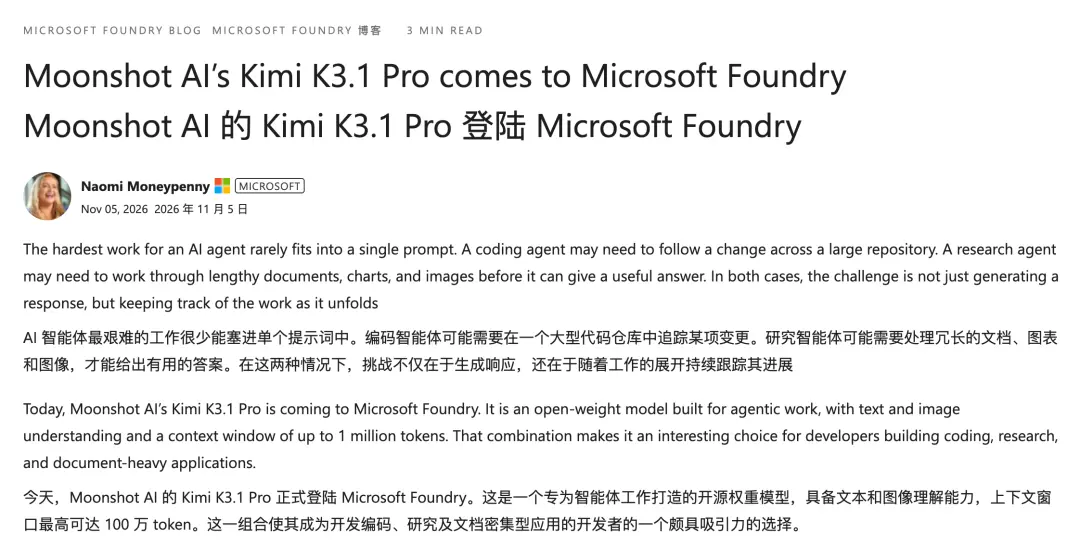
А до Microsoft Kimi уже была на Amazon AWS. Microsoft и Amazon, две крупнейшие облачные платформы в мире, последовательно выдали китайским открытым моделям «пропуск на вход».
Другие счета: объем использования удвоился, но деньги не увеличились
Китайские открытые модели так эффективны, неужели закрытые модели должны волноваться?
История не так проста.
Если смотреть только на объем использования, действительно наблюдается мощный рост открытых моделей: доля токенов увеличилась с 11% до 19%, а месячный объем обработки взлетел в 22,5 раза, достигнув примерно 29 триллионов токенов.
Но где деньги? Доля расходов наоборот снизилась с 6% до 4%.
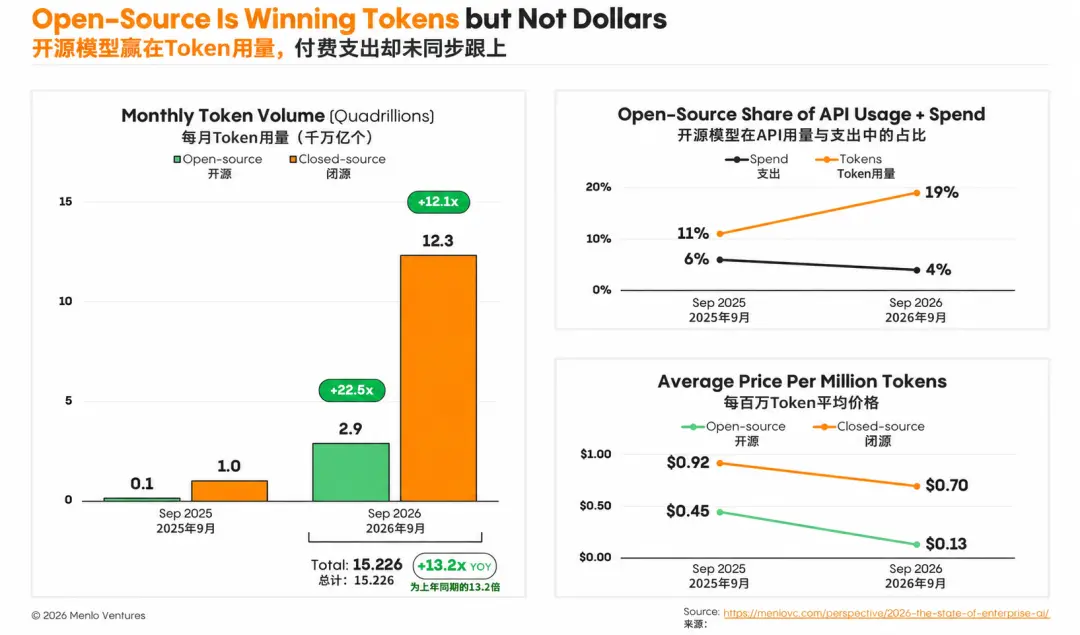
Причина очень болезненная: за последний год открытые модели в основном сосредоточились на одной и той же задаче — создании более мелких, быстрых и дешевых моделей уровня «flash», ведя жестокую ценовую войну.
За год средняя цена токенов открытых моделей упала в 3,3 раза, сейчас каждый миллион токенов стоит всего 0,13 доллара; закрытые модели в среднем стоят 0,70 доллара, что более чем в пять раз дороже.
Результат ценовой войны: объем работы увеличился вдвое, а доходы на самом деле уменьшились — весь прирост был съеден снижением цен.
Модели открытого кода Flash выиграли в громкости, а флагманские модели выиграли в доходах.
Бюджеты компаний не различают открытые и закрытые модели, они просто смотрят, кто может выполнять работу. Однако в открытой экосистеме достаточно флагманских игроков, чтобы их можно было пересчитать на пальцах одной руки.
Это самое противоречивое открытие всего отчета: доля расходов на передовые флагманские модели выросла с 35% до 63%, а доля токенов удвоилась с 18% до 42%.
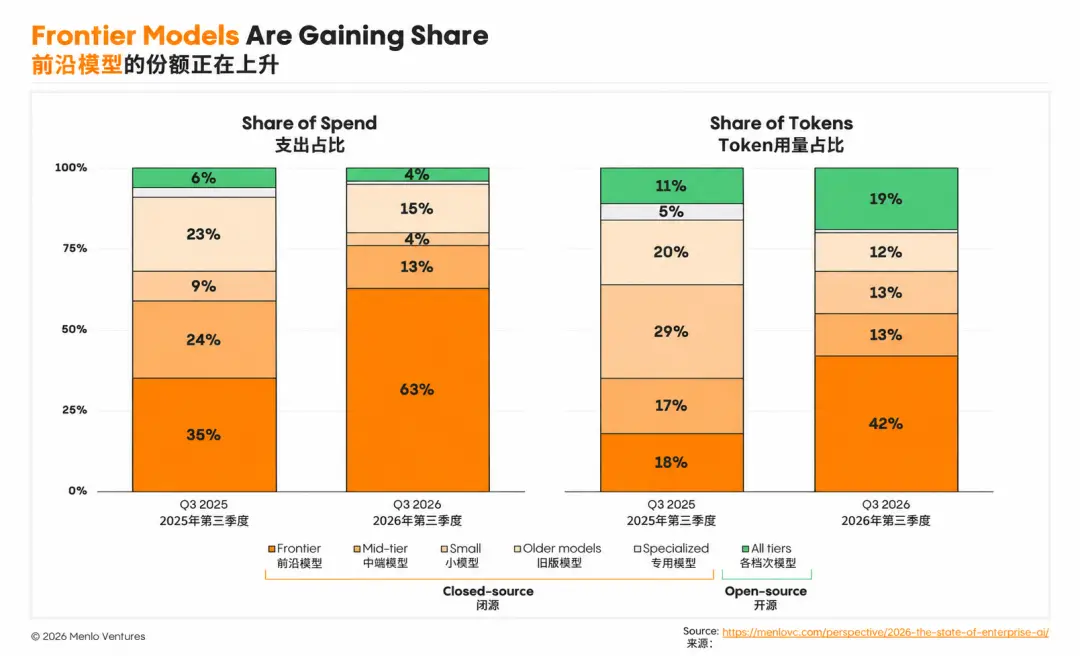
В прошлом году основными выборами для компаний были Claude Sonnet 4.5 (3 доллара за миллион входящих токенов) и GPT-5 (1,25 доллара); в этом году они сменились на Claude Opus 5.5 (4 доллара) и GPT-6 Astra (10 долларов). Цены выросли в несколько раз, пользователи не только не ушли, но и устремились.
Кому достались деньги? Anthropic увеличила свою долю с 40% до 55%, OpenAI с 27% до 31%, обе компании поглотили 86% расходов на корпоративные LLM API. Google упала с 21% до 9%, отстала.
А такие игроки, как Kimi K3, DeepSeek V4, GLM-5.3, которые уже приближаются к флагманским показателям, в сумме составляют менее 5%. Способности достигнуты, но компании еще не осмелились доверить им свои ключевые задачи.
Самое худшее положение — это средний уровень: небольшие закрытые модели снизили цены более чем на 80%, а доля токенов упала с 29% до 13%. Сверху сложные задачи забирают флагманы, снизу простые задачи отбирают открытые модели, обе стороны давят, обе стороны страдают.
Так почему компании предпочитают тратить больше денег?
Представьте себе: заставить ИИ исправить онлайн-неисправность, прочитать код, проверить журналы, определить проблему, изменить файл, провести тесты. Дешевые модели сбиваются с пути каждые несколько шагов, вам приходится многократно объяснять, проверять и переделывать, в конечном итоге все равно придется делать это самостоятельно. Счет за токены сэкономлен, но целый день инженера потрачен.
Таким образом, компании на самом деле считают не стоимость за миллион токенов, а сколько всего стоит завершить задачу от начала до конца. Стоимость вызова модели — это лишь мелочь, а время, потраченное на наблюдение, ожидание и исправление, на самом деле является настоящей статьей расходов.
Дешево, конечно, хорошо, но при одном условии — работа действительно должна быть выполнена.
Но можно ли сказать, что открытые модели не могут выполнять крупные задачи?
Возьмем, к примеру, Kimi K3.1 Pro, архитектура MoE с 2,8 триллиона параметров, поддерживающая контекстное окно в 1 миллион токенов, Terminal-Bench 4.0 показал 65,7%, что превышает показатели GPT-6 Astra.
На финансовом исследовательском бенчмарке OfficeQA Pro v2 она набрала 64,4 балла, заняв первое место в мире. Уровень ошибок галлюцинации снизился с 23,4% до 6,85%.
Это уже не уровень «сносного использования», это уровень, на котором можно соперничать с закрытыми флагманами.
Открытые модели никогда не уступали в интеллекте, а в степени доверия со стороны компаний — в соответствии, послепродажном обслуживании, долгосрочной стратегии, эти «баллы вне экзамена» являются последним барьером.
В конечном итоге, резкое падение американских фондовых рынков и данные из этого отчета рассказывают об одной и той же вещи с разных сторон.
Уолл-стрит сосредоточена на стороне предложения: огромные капитальные расходы, одобрение центров обработки данных, стоимость электроэнергии — все это мечи, висящие над головой.
А отчет Menlo Ventures сосредоточен на стороне спроса: на каждый доллар, потраченный на обучение модели, компании тратят 1,70 доллара на ее использование — спрос на нижнем уровне обеспечивает поддержку вложений на верхнем уровне.
Уолл-стрит в начале года также испытывала панику по поводу «AI, поглощающего SaaS». Итоговый отчет показывает: 55% новых расходов на AI поступают из совершенно нового бюджета, только 9% были перенесены с традиционного программного обеспечения на нативных поставщиков AI.
AI увеличивает общий объем, а не отбирает его.
Автором этого отчета является Menlo Ventures, их партнер Тим Талли сказал правду:
Уолл-стрит каждый день спрашивает, сможет ли AI вернуть свои вложения, но мы видим, что корпоративные покупатели не сокращают свои расходы, а наоборот, ищут способы заставить AI работать больше.
«Возможно, мы все еще недооценили этот рынок.»
Акции упадут, счета не обманут
В конце концов, стоит взглянуть на три группы контрастов, скрытых в этом отчете:
Флагман vs Открытый исходный код. Флагманские модели забирают 69% расходов на развертывание, преимущество первых лабораторий в эпоху Агентов было усилено.
Но отчет также говорит о важной вещи — «дефицит возможностей не будет длиться долго».
Каждый раз, когда открытый исходный код достигает уровня флагмана в какой-либо задаче, прежняя надбавка должна быть снова проверена.
Закрытые флагманы не имеют постоянного права на надбавку.
Объем vs Доход. Китайский открытый исходный код доказал свою способность с долей 89%, но между 19% использования токенов и 4% расходов существует коммерческий вопрос.
Быть широко используемым — это одно, а стабильно справляться со сложными задачами и заставлять клиентов продолжать платить — это следующий уровень.
Примеры Harvey и Thinking Machines предлагают один путь — не полагаться на дешевизну, а стать учителем для других, основой для других; модель распределения Microsoft и AWS предлагает другой путь — сотрудничать с облачными гигантами, вызывать один раз, делить доход один раз.
Акции vs Счета. Контраст между Уолл-стрит и компаниями на самом деле не так противоречив.
Акции рассчитываются на основе ожиданий, счета фиксируют реальность. Утрата 2,8 триллиона в день — это коррекция ожиданий, рост в 5,4 раза за год — это ускорение реальности. Оба могут быть истинными одновременно.
Но если смотреть дальше, этот отчет может раскрывать не только один экономический цикл — а перераспределение власти в индустрии.
Три года назад AI был игрушкой в лаборатории; через три года компании тратят 177 миллиардов долларов в год на работу с AI, эта сумма уже сопоставима с третью доходов всего публичного облака.
Основные исполнители также изменились, 80% токенов сжигаются самими Агентами.
Чья модель может работать, кто обучает модель, кто помогает вам запускать модель — вся цепочка распределения труда переписывается силами китайского открытого исходного кода.
 Предупреждение о рисках Предупреждение о рисках